MiniMax M3: Das Open-Weight-Coding-Modell für einen Bruchteil des GPT-Preises
MiniMax M3 ist ein Open-Weight-Coding-Modell, bis zu 25-mal günstiger als GPT-5.5 und Claude Opus. Was der Preisunterschied für KI-Agenten wirklich bedeutet.
Ein KI-Coding-Agent, der in einer Schleife läuft, ein Repository liest, einen Patch schreibt, die Tests laufen lässt und es bei Bedarf erneut versucht, kann ganz schön ins Geld gehen, wenn man dafür Spitzenpreise pro Token zahlt. Genau an diesem Punkt setzt MiniMax M3 an, ein auf Programmieren spezialisiertes großes Sprachmodell (LLM) des Shanghaier KI-Unternehmens MiniMax, das auch für seine Video-Marke Hailuo und eigene Audio-Tools bekannt ist, alles unter demselben Dach wie die M-Serie der Textmodelle. M3 ist nicht einfach ein weiterer Rang in irgendeiner Bestenliste. Die Kombination aus offenen Gewichten und einem drastischen Preisnachlass verändert, wer es sich leisten kann, einen KI-Agenten stundenlang unbeaufsichtigt arbeiten zu lassen.
Was “Open Weight” hier bedeutet, und warum die Lizenz trotzdem zählt
MiniMax hat die Gewichte von M3 öffentlich zugänglich gemacht: Wer will, lädt sich das Modell herunter und betreibt es auf eigener Hardware, statt es über MiniMax’ API aufzurufen. Das ist handfest nützlich, denn kein Anbieter kann dann heimlich die Preise erhöhen, das Verhalten des Modells ändern oder den Zugang kappen, wie es bei einem geschlossenen API-Dienst passieren kann. Die gängige Kurzformel “Open Source” verspricht allerdings mehr, als tatsächlich geliefert wird. M3 läuft unter MiniMax’ eigener Community-Lizenz, nicht unter einer von der Open-Source-Organisation OSI anerkannten Lizenz wie Apache 2.0 oder MIT. In der Praxis heißt das: Es gelten MiniMax-spezifische Bedingungen für Nutzung und Weitergabe des Modells, nicht die breiten, standardisierten Rechte einer echten Open-Source-Veröffentlichung.
Genau um diese Unterscheidung dreht sich unser Leitfaden zur Auswahl eines Open-Weight-LLM anhand der Lizenzbedingungen statt der Benchmark-Platzierung: Das Etikett “offen” deckt eine ganze Spannbreite an tatsächlicher rechtlicher Freiheit ab, und erst die Lizenz entscheidet, ob man das Modell wirklich kontrolliert oder es sich nur unter anderen Bedingungen ausgeliehen hat. Für Hobbyisten, die das Modell lokal für private Projekte laufen lassen, spielt das kaum eine Rolle. Für ein Unternehmen, das ein Produkt auf M3 aufbauen und weiterverteilen will, zählt der tatsächliche Lizenztext deutlich mehr als das Wort “offen” in einer Überschrift.
Die Zahl, auf die es ankommt: ungefähr 20- bis 25-mal günstiger
MiniMax nennt für die API-Nutzung von M3 Preise von rund 0,30 Dollar pro Million Input-Token und 1,20 Dollar pro Million Output-Token - Werte, die sich sowohl in den Modell-Listen von OpenRouter als auch auf MiniMax’ eigener Preisseite zum Zeitpunkt der Recherche konsistent wiederfinden. Zum Vergleich die Spitzenmodelle hinter verschlossener Tür, gegen die M3 implizit antritt: OpenAIs GPT-5.5 verlangt 5 Dollar pro Million Input-Token und 30 Dollar pro Million Output-Token, Anthropics Claude Opus 4.5 liegt bei 5 Dollar Input und 25 Dollar Output. Moonshot AIs Kimi K2.7-Code, ein günstigerer Open-Weight-Konkurrent, rangiert meist dazwischen, bei 0,95 Dollar Input und 4,00 Dollar Output.
Wer das bei den Output-Token durchrechnet, den Token, die bei einem Agenten dominieren, der Code schreibt, Befehle ausführt und Ergebnisse zurückliest, kommt auf ein klares Verhältnis: 30 Dollar geteilt durch 1,20 Dollar ergibt genau 25. Das ist kein gerundeter Werbetrick, sondern das tatsächliche Verhältnis zwischen dem teuersten Spitzenmodell dieser Liste und MiniMax’ Coding-Modell. Diese genauen Zahlen werden in ein paar Monaten veraltet aussehen, die Preise in diesem Markt bewegen sich ständig, aber die Größenordnung ist der Teil, den man sich merken sollte: Dieselbe Coding-Agenten-Arbeit kostet auf M3 ungefähr ein Zwanzigstel bis ein Fünfundzwanzigstel von dem, was die teuersten geschlossenen Alternativen verlangen. Alle vier Preise oben sind Momentaufnahmen, nicht das eigentliche Fundament des Artikels; das Fundament ist, was so eine Preislücke daran ändert, wie Menschen diese Modelle tatsächlich einsetzen.
Warum die Lücke bei Coding-Agenten mehr zählt als beim Chat
Eine einzelne Frage, die ein Chatbot beantwortet, kostet ein paar Cent, egal welches Modell dahintersteckt. Die Rechnung ändert sich komplett, sobald ein Modell in eine agentische Schleife eingebaut wird: ein Setup, in dem die KI Dateien liest, Code schreibt, ihn ausführt, die Ausgabe liest und diesen Zyklus Dutzende oder Hunderte Male wiederholt, bis eine Aufgabe fertig ist. Jeder dieser Durchläufe verbraucht Token, und ein länger laufender Agent kann leicht Millionen von Token verbrennen, bevor er fertig ist. Bei Spitzenpreisen summiert sich das schnell genug, dass Teams rationieren, wie lange sie einen Agenten unbeaufsichtigt laufen lassen. Bei 20- bis 25-mal niedrigeren Kosten kauft dasselbe Budget 20- bis 25-mal mehr Agenten-Stunden, was in der Praxis heißt: den Agenten länger arbeiten lassen, mehr Versuche zulassen und sich an schwierigere Probleme wagen, bevor ein Mensch eingreifen und entweder die Ausgaben absegnen oder selbst übernehmen muss.
MiniMax selbst stellt genau diesen Rahmen in den Vordergrund. Laut dem offiziellen M3-Release-Post des Unternehmens lief das Modell rund 12 Stunden lang unbeaufsichtigt, um die Methodik eines wissenschaftlichen Papers von Grund auf nachzubauen. Derselbe Beitrag beschreibt einen weiteren Durchlauf, bei dem das Modell fast 24 Stunden ununterbrochen FP8-GEMM-Kernel optimierte (der niedrigschwellige CUDA-Code, der Matrixmultiplikationen auf einer Grafikkarte übernimmt), und meldet dabei eine 9,4-fache Beschleunigung gegenüber der ursprünglichen Version. Beide Zahlen stammen aus MiniMax’ eigenen, selbst gemeldeten Benchmark-Ergebnissen, nicht von unabhängiger Dritt-Prüfung, zeigen aber genau die Art von Aufgabe, die diese Preislücke eröffnen soll: lange, iterative, weitgehend unbeaufsichtigte Entwicklungsarbeit, bei der ein Modell, das “gut genug” und deutlich günstiger ist, einem Modell vorzieht, das etwas besser, aber für gelegentliche Nutzung bepreist ist.
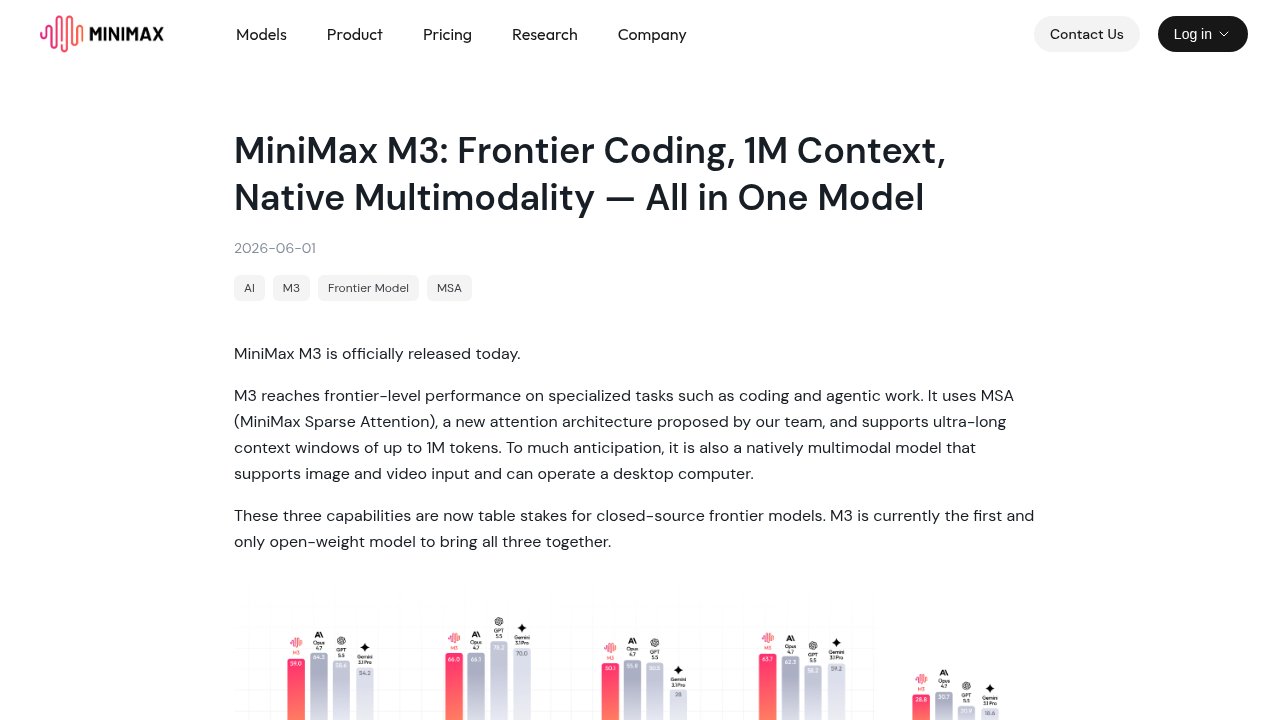 Offizieller MiniMax-M3-Release-Post - die eigene Ankündigung des Unternehmens, mit den oben erwähnten Benchmark-Grafiken.
Was tatsächlich unter der Haube steckt
Hinter der Preisgestaltung steht ein großes Modell, das trotz seiner Größe günstig im Betrieb sein soll. MiniMax gibt an, das Modell habe insgesamt rund 428 Milliarden Parameter, von denen pro Token nur etwa 23 Milliarden tatsächlich aktiv sind. Dieses spärliche Mixture-of-Experts-Design, bei dem sich für jedes Textstück nur ein Bruchteil des gesamten Netzwerks einschaltet, ist der Grund, warum ein so großes Modell trotzdem zu einem Bruchteil der Kosten eines kleineren, aber vollständig “dichten” Modells laufen kann. Es ist dasselbe Grundprinzip, das auch preisbewusste Open-Weight-Modelle von DeepSeek und Qwen nutzen, beschrieben in unserem Leitfaden zu Open-Weight-LLM-Lizenzen.
M3 setzt außerdem auf das, was MiniMax MiniMax Sparse Attention (MSA) nennt, ein eigenes Design dafür, wie das Modell lange Dokumente oder lange Unterhaltungen im Blick behält. Standard-”dichte” Aufmerksamkeit, bei der das Modell jedes frühere Textstück gegen jedes andere abwägt, wird mit wachsender Eingabe proportional langsamer und kann an Genauigkeit verlieren. MSA soll die Qualität stabiler halten, je länger das Kontextfenster wird, und MiniMax untermauert das Design mit Unterstützung für Kontextfenster von bis zu einer Million Token in einer einzigen Sitzung, ungefähr die Länge mehrerer dicker Romane.
Das Modell ist zudem von Natur aus multimodal: Es nimmt Text, Bilder und Video in derselben Unterhaltung entgegen, ohne sie über separate Spezialsysteme umzuleiten. MiniMax’ eigener Blogpost geht noch weiter und behauptet, das Modell könne einen Desktop-Computer direkt bedienen, also einen Bildschirm betrachten, entscheiden, was es klickt oder eintippt, und handeln, statt nur Fragen zu einem eingefügten Bild zu beantworten.
 MiniMax-M3 auf Hugging Face - die offizielle Modellkarte und die von MiniMax veröffentlichten Gewichte.
Wo die Qualitätslücke real ist
Nichts davon macht M3 zum makellosen Ersatz für die fähigsten geschlossenen Modelle. Bei den zwei meistbeachteten Software-Engineering-Benchmarks der Branche meldet MiniMax für M3 80,5 Prozent bei SWE-Bench Verified (ein Test aus echten, bestätigt lösbaren GitHub-Issues) und 59,0 bei SWE-Bench Pro, einem schwereren Nachfolge-Benchmark, der genau der Art von Auswendiglernen widerstehen soll, die die Werte beim ursprünglichen Test aufgebläht hatte. Bei Terminal-Bench 2.1, das misst, wie gut ein Modell eine Kommandozeilen-Umgebung bedienen kann, um mehrstufige Aufgaben zu erledigen, meldet MiniMax einen Wert von 66,0. Das sind starke Ergebnisse für ein Open-Weight-Modell, und MiniMax meldet sie selbst statt über eine unabhängige Prüfung, was man im Kopf behalten sollte, wenn man sie mit Zahlen vergleicht, die Labore veröffentlichen, die sich unabhängigen Ranglisten stellen.
In der Praxis zeigt sich die Lücke zwischen M3 und den besten geschlossenen Modellen bei den schwierigsten, ungewöhnlichsten Problemen, also dort, wo echtes neues Denken gefragt ist statt Mustererkennung anhand einer großen Menge von Trainingsbeispielen. Für den Großteil der gewöhnlichen Agenten-Coding-Arbeit, eine Funktion schreiben, einen fehlschlagenden Test reparieren, ein Modul umbauen, einem Styleguide folgen, schrumpft diese Lücke deutlich, und genau darauf baut das Preisargument von oben auf: 25-mal mehr zu zahlen, lohnt sich nur, wenn sich die zusätzliche Qualität bei den Aufgaben zeigt, die man tatsächlich ausführt.
Eine Beobachtung zum Verhalten von M3 ist bemerkenswert, gerade weil sie nicht von MiniMax selbst stammt: In einem viel beachteten Praxistest stellte ein Entwickler fest, dass M3 von sich aus eigene Testskripte mit einem Headless-Browser schrieb (ein Browser, der ohne sichtbares Fenster läuft, oft für automatisierte Tests genutzt), um die eigene Arbeit zu überprüfen, ohne dass es dazu aufgefordert wurde. Das ist eine einzelne Beobachtung eines unabhängigen Testers, keine dokumentierte Funktion und keine allgemeine Aussage darüber, wie sich das Modell immer verhält, aber genau diese Art Detail zählt für jemanden, der tatsächlich damit arbeitet, mehr als ein weiterer Prozentpunkt bei einem Benchmark: Ein Modell, das seine eigene Ausgabe ungefragt prüft, braucht in einer Agenten-Schleife weniger Nachsicht.
Wer diese Abwägung gegen den Verbleib bei einem geschlossenen Spitzenmodell abwägt, sollte zudem bedenken, dass der Zugang zu geschlossenen Modellen nicht garantiert stabil bleibt. Unsere Berichterstattung darüber, wie Anthropic ohne Vorwarnung den Zugang zu einem eigenen Modell abschaltete, erinnert daran, dass ein Workflow, der komplett auf der API eines einzigen Anbieters aufbaut, bedeutet, dessen Entscheidungen über Verfügbarkeit zu akzeptieren, nicht nur über den Preis. Offene Gewichte, selbst unter einer einschränkenden Community-Lizenz, beseitigen genau diese Abhängigkeit: Das Modell, das man heute herunterlädt, läuft auf der eigenen Hardware weiter, egal was der Anbieter morgen entscheidet.

FAQ
Ist MiniMax M3 wirklich Open Source?
MiniMax M3s Gewichte sind öffentlich und herunterladbar, was oft “Open Weight” genannt wird, aber das Modell erscheint unter MiniMax’ eigener Community-Lizenz statt unter einer anerkannten Open-Source-Lizenz wie Apache 2.0. Das bedeutet, dass einige der breiten Freiheiten echter Open-Source-Software, besonders bei Weitergabe und kommerzieller Nutzung, enger gefasst sind, als es das Etikett “Open Source” vermuten lässt.
Wie teuer ist MiniMax M3 im Vergleich zu GPT-5.5 oder Claude Opus?
MiniMax M3 wird üblicherweise mit rund 0,30 Dollar pro Million Input-Token und 1,20 Dollar pro Million Output-Token angegeben, verglichen mit etwa 5 Dollar Input und 30 Dollar Output bei GPT-5.5 und 5 Dollar Input sowie 25 Dollar Output bei Claude Opus 4.5. Das macht M3 bei den Output-Preisen etwa 20- bis 25-mal günstiger, auch wenn sich alle diese Zahlen mit der Zeit verschieben werden.
Kann ich MiniMax M3 auf eigener Hardware betreiben?
Ja, weil MiniMax die Gewichte des Modells veröffentlicht hat, lässt sich M3 herunterladen und selbst hosten, statt es über eine API aufzurufen. In der Praxis erfordert seine Größe, rund 428 Milliarden Parameter insgesamt mit etwa 23 Milliarden aktiven pro Token, dafür aber ernsthafte GPU-Infrastruktur, keinen Laptop.
Ist MiniMax M3 beim Programmieren so gut wie GPT-5.5?
MiniMax M3 erzielt starke Werte bei Benchmarks wie SWE-Bench Verified (80,5 Prozent, nach MiniMax’ eigenen Angaben), wird aber nicht als gleichwertig mit den allerbesten geschlossenen Modellen bei den schwierigsten, neuartigsten Engineering-Problemen positioniert. Bei routinemäßiger Agenten-Coding-Arbeit ist die praktische Qualitätslücke meist klein genug, dass der große Preisunterschied stärker zählt als der Benchmark-Abstand.
Was ist MiniMax Sparse Attention, und warum ist das wichtig?
MiniMax Sparse Attention, kurz MSA, ist MiniMax’ eigenes Design dafür, wie das M3-Modell lange Textabschnitte verarbeitet, mit dem Ziel, die Antwortqualität auch bei sehr langen Unterhaltungen oder Dokumenten stabil zu halten. Es trägt MiniMax M3s Kontextfenster von bis zu einer Million Token, ohne den starken Qualitätsabfall, den klassische dichte Aufmerksamkeits-Designs bei dieser Länge zeigen können.