KI-Training per robots.txt ablehnen: Was der neue Opt-out wirklich bringt
Google, Microsoft, OpenAI und Anthropic unterstützen ein Token in robots.txt gegen KI-Training. Was es wirklich regelt – und was offen bleibt.
Wer eine Website betreibt und verhindern will, dass KI-Firmen ihre Inhalte zum Training verwenden, kann ab jetzt eine einzige Zeile in eine Datei schreiben, die fast jede Website bereits besitzt. Vier der größten KI-Anbieter haben versprochen, diese Zeile zu respektieren. Das klingt nach dem Ende eines langen, unübersichtlichen Problems. Tatsächlich ist es eher der Anfang eines geordneteren.
Am 30. Oktober 2026 veröffentlichten Google, Microsoft, OpenAI und Anthropic jeweils eine eigene Ankündigung: Sie wollen künftig ein neues, gemeinsames Signal gegen KI-Training respektieren, das in der robots.txt steht – jener kleinen Textdatei im Stammverzeichnis einer Website (deineseite.de/robots.txt), die automatisierten Crawlern sagt, welche Bereiche sie besuchen dürfen. In der Berichterstattung wurde daraus schnell die Erzählung: vier Tech-Riesen einigen sich auf einen neuen Standard. Diese Lesart ist in zwei Punkten falsch, und genau die Lücke zwischen dem, was angekündigt wurde, und dem, was sich tatsächlich ändert, sollte jeder kennen, der jetzt an seiner robots.txt herumschrauben will.
Was das neue robots.txt-Token wirklich tut
Der Mechanismus passt in drei Zeilen. Eine Website trägt in ihrer robots.txt einen Block mit einem neuen User-Agent-Token ein, __usage_ai-training, und legt fest, was dieser Crawler darf und was nicht – genau wie robots.txt das schon immer für Suchmaschinen-Crawler regelt:
User-Agent: __usage_ai-training
Disallow: /
Allow: /press-kit/
Übersetzt heißt das: Dieses Beispiel sperrt KI-Trainings-Crawler von der gesamten Seite aus, außer von einem Presse-Ordner, den der Betreiber sowieso indexiert sehen will. Wichtig: Das unterstrichene Token ist kein Crawler einer bestimmten Firma, wie etwa Googlebot oder GPTBot es sind. Es ist ein gemeinsames Etikett, das der Crawler jeder teilnehmenden KI-Firma erkennen und befolgen kann – wer eine Website betreibt, muss also nicht mehr jeden einzelnen Crawler-Namen jeder KI-Firma auflisten, um eine einzige Präferenz auszudrücken: dieser Inhalt darf nicht zum Training eines Modells verwendet werden.
Das ist tatsächlich der nützliche Teil, und er ist real. Bisher musste eine Website, die KI-Training ablehnen wollte, eine stetig wachsende Liste benannter Crawler pflegen – ähnlich wie Seiten, die ihre Inhalte aus einer Vektordatenbank für Retrieval heraushalten wollen, bislang jedes System einzeln verfolgen mussten – und diese Liste bei jedem neuen Anbieter aktualisieren. Eine Zeile, einmal eingetragen, soll künftig jeden Crawler abdecken, der sich zu diesem Signal bekennt. Die praktische Frage, die weiter unten im Detail folgt, ist, was diese eine Zeile heute tatsächlich abdeckt – und was nicht.
Kein IETF-Standard – was es wirklich ist
Das Token stammt aus einem Dokument namens draft-kelley-aipref-training-preference-signal-00, eingereicht bei der IETF, der Internet Engineering Task Force, jener Standardisierungsorganisation, die technische Spezifikationen wie diese betreut. Das Wort „Draft” bedeutet im IETF-Jargon nicht „grob” oder „unfertig” im Alltagssinn. Es ist eine formale Kategorie, und diese besondere Art, ein individueller Internet-Draft, ist die unterste Stufe: Jeder kann einen solchen Entwurf einreichen, und der IETF-Datatracker-Eintrag zum Entwurf stellt klar, dass er „von der IETF nicht unterstützt wird und im IETF-Standardisierungsprozess keinen formalen Status hat”.
Das Token selbst wurde also von keiner IETF-Arbeitsgruppe geprüft, diskutiert oder ratifiziert. Was diesen Prozess tatsächlich durchlaufen hat, ist ein verwandtes, aber anderes Dokument: draft-ietf-aipref-vocab-08, mit dem Titel „A Vocabulary For Expressing AI Usage Preferences”. Dieses Dokument ist ein echtes Arbeitsgruppen-Dokument (verfasst von Paul Keller von Open Future und Martin Thomson von Mozilla, im Rahmen der IETF-Arbeitsgruppe aipref), auf dem Weg zu einem Proposed Standard – der formalen Bezeichnung für eine Spezifikation, die die IETF-Prüfung durchlaufen hat. Es definiert, was Begriffe wie „KI-Training” in einem maschinenlesbaren Vokabular bedeuten. Der Kelley-Entwurf borgt sich einfach dieses Vokabular und überträgt es in die Syntax von robots.txt, trägt aber selbst nicht die Rückendeckung der Arbeitsgruppe.
Der Unterschied ist wichtig, denn hinter einem echten Arbeitsgruppen-Dokument steht ein offener Prozess: Prüfung, Einwände, Überarbeitungen, ein Weg zum Konsens. Ein individueller Entwurf hat davon standardmäßig nichts. Er wird erst bedeutsam, wenn genügend Beteiligte sich in der Praxis dazu entschließen, ihn zu respektieren – und genau das ist hier passiert: Vier Unternehmen haben sich entschieden, einen nicht offiziell gebilligten Entwurf zu unterstützen, nicht weil die IETF es ihnen vorgeschrieben hätte, sondern weil sie ihre jeweiligen Ankündigungen eigenständig darauf abgestimmt haben.
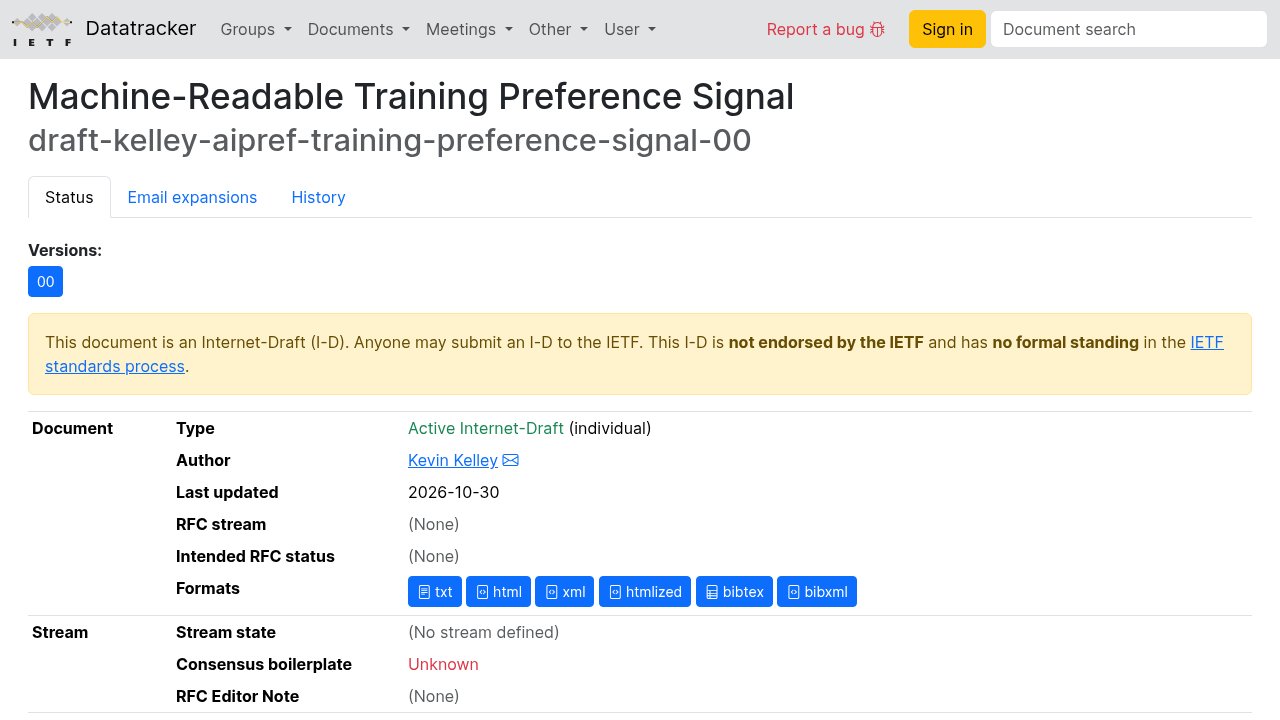
IETF-Datatracker-Eintrag zu draft-kelley-aipref-training-preference-signal-00 – der individuelle Internet-Draft, der das Token definiert, mit dem Hinweis, dass er keinen formalen IETF-Status besitzt.
Vier Firmen, ein Token, vier verschiedene Zeitpläne
Genau hier bricht die Kurzformel „4 Riesen, 1 Standard” am stärksten auseinander. Die vier Unternehmen haben zwar am selben Tag ihre Ankündigungen veröffentlicht, aber was jedes von ihnen tatsächlich zugesagt hat, unterscheidet sich in Zeitpunkt und Umfang deutlich.
Google schrieb in einem Beitrag im Search Central Blog, dass eine Website, die das gemeinsame Token nutzt, ohne separat Google-Extended zu konfigurieren (Googles eigene bestehende Kontrolle für KI-Trainingsnutzung), künftig damit rechnen kann, dass Google das gemeinsame Token so behandelt, als decke es Google-Extended gleich mit ab. Doch auch diese Verschmelzung ist noch nicht aktiv: Google schreibt, man „strebe an, diese neue Kontrolle zusammen mit anderen KI-Anbietern im Jahr 2027 zu unterstützen” – ohne genaueres Datum, während die bisherigen firmenspezifischen Kontrollen in der Zwischenzeit weiterlaufen.
Microsoft, über Bing, kündigte im Bing-Blog an, das gemeinsame Token ab dem 1. Februar 2027 zu respektieren – nicht sofort. Microsoft führte außerdem eine zweite, separate Präferenz namens „AI Grounding” ein, die einen anderen Anwendungsfall abdeckt: wenn ein KI-System den Inhalt einer Seite live heranzieht, um eine Antwort zu generieren, statt diesen Inhalt von Anfang an zum Training eines Modells zu verwenden. Grounding lässt sich derzeit nur auf Ebene einzelner Seiten steuern, über ein Meta-Tag oder einen X-Robots-Tag-Header (eine Anweisung in der Server-Antwort einer Seite, nicht in der robots.txt-Datei) – über robots.txt selbst geht das gar nicht.
OpenAI erklärte in einem Beitrag auf openai.com, das Unternehmen wolle dasselbe Signal respektieren, mit Rollout „in den kommenden Monaten” – ohne konkretes Datum. Die bestehenden robots.txt-Kontrollen von OpenAI bleiben in der Zwischenzeit gültig, wer also abwartet, verliert nichts. Nur tritt eben auch nichts Neues zu einem festen Termin in Kraft.
Anthropic, dessen eigener Ingenieur Kevin Kelley den technischen Entwurf verfasst hat, ist das einzige Unternehmen, das angibt, bereits daran zu arbeiten: In der Ankündigung des Entwurfs auf der IETF-Mailingliste ai-control am 30. Oktober 2026 schrieb Kelley, „Anthropic hat bereits begonnen, die Unterstützung für diesen Entwurf zu implementieren”, warnte zugleich aber: „es wird einige Zeit dauern, bis wir die Unterstützung über alle unsere Dienste hinweg einführen und die unvermeidlichen Komplikationen und Grenzfälle durcharbeiten.” Anthropic hat also einen Vorsprung, aber, wie OpenAI, kein festes Fertigstellungsdatum.
Legt man diese vier Zeitpläne nebeneinander, ergibt sich kein Bild von „ein Schalter, vier Bestätigungen”, sondern eher von vier separaten internen Rollout-Plänen, die zufällig auf dieselbe Syntax zielen.
Die Microsoft-Frist, die man nicht ignorieren kann
Von den vier Unternehmen hat nur eines ein konkretes Ablaufdatum für eine bestehende Praxis gesetzt, und genau das ist das Detail, das Website-Betreiber am ehesten überrascht.
Viele Websites halten KI-Training bisher indirekt fern, über ältere Anweisungen wie NoArchive oder NoCache, Meta-Tags, die ursprünglich Suchmaschinen davon abhalten sollten, zwischengespeicherte Kopien einer Seite zu speichern, die manche Crawler aber inoffiziell auch als Signal gegen KI-Training interpretiert haben. Laut Bings eigener Webmaster-Tools-Dokumentation zu KI-Präferenzen wird Microsoft NoArchive und NoCache ab dem 1. März 2027 nicht mehr als Opt-out-Signal gegen KI-Training behandeln.
Das bedeutet: Wer sich derzeit auf diese älteren Tags verlässt, um eigene Inhalte aus dem KI-Training von Bing-nahen Systemen herauszuhalten, hat eine klare, feste Frist vor sich, kein vages Zeitfenster. Wer NoArchive oder NoCache noch zu diesem Zweck verwendet, muss vor dem 1. März 2027 das neue Token hinzufügen, sonst verliert diese Seite den Schutz bei Bing – ohne Rückfallebene. Das ist der einzige Teil der ganzen Ankündigung, der sich wie eine echte Richtlinienänderung mit einem echten Stichtag verhält, nicht wie ein freiwilliges Signal, das die Unternehmen irgendwann umsetzen werden.
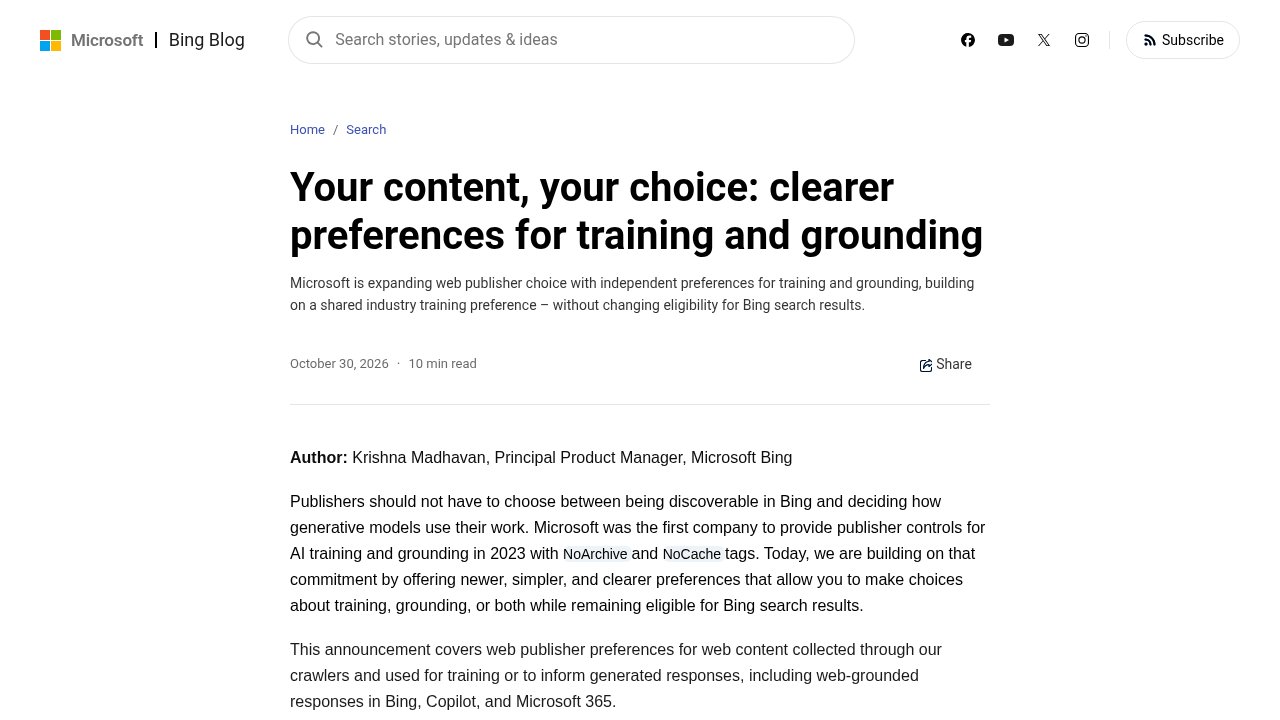
Microsoft Bing-Blog – der Beitrag vom 30. Oktober 2026, der die neuen Präferenzen für Training und Grounding sowie das Ablaufdatum für NoArchive/NoCache ankündigt.
Was heute konkret in die robots.txt gehört – und was dadurch noch nicht gelöst ist
Wer jetzt handeln will, statt auf die endgültige Klärung aller Zeitpläne zu warten, kann einen einfachen Schritt gehen: den Block __usage_ai-training noch heute in die robots.txt eintragen, eingegrenzt auf die Pfade, die geschützt werden sollen. Das kostet nichts, bricht nichts anderes auf der Website, und setzt die Uhr in Gang, von denjenigen Unternehmen erkannt zu werden, die sich dazu verpflichtet haben – Anthropic schon mitten in der Umsetzung, Microsoft ab Februar 2027, Google irgendwann 2027, OpenAI irgendwann „in den kommenden Monaten”.
Was es noch nicht leistet: eine einheitliche Antwort auf die Frage „Sind meine Inhalte vor KI-Training sicher?”. Crawler von Unternehmen, die sich dem Signal nicht angeschlossen haben, müssen weiterhin auf die alte Art adressiert werden, namentlich, wenn man sie blockieren will. Auch Microsofts separate AI-Grounding-Präferenz liegt außerhalb der Reichweite dieses Tokens, denn die muss auf Seitenebene gesetzt werden, nicht in der robots.txt – für alle, die bei genau diesem Anwendungsfall ein Mitspracherecht wollen. Und rechtlich bindend ist das Ganze ohnehin nicht: Es handelt sich um ein freiwilliges Signal, das befolgt wird, weil ein Unternehmen sich dazu entschieden hat, nicht weil eine Regulierung oder ein ratifizierter Standard dazu zwingt.
Das ist die eigentliche Lehre unter den vier Ankündigungen vom 30. Oktober. Ein gemeinsames Token, das aussieht wie „einmal einstellen, überall erledigt”, ist nicht dasselbe wie ein ratifizierter Standard mit synchronisierter Durchsetzung. Es sind vier Unternehmen, die sich darauf verständigt haben, dasselbe Wort zu lesen, jedes nach seinem eigenen Zeitplan, mit seinen eigenen Ausnahmen. Für die eigene Kontrolle über die eigenen Inhalte bedeutet das weiterhin: die jeweilige Richtlinienseite jedes Unternehmens einzeln prüfen, statt eine Zeile in der robots.txt als abgeschlossene Sache zu betrachten.

FAQ
Was ist das Token __usage_ai-training in robots.txt?
Das Token __usage_ai-training ist eine Kennzeichnung, die eine Website in ihrer robots.txt-Datei hinterlegt, um KI-Crawlern mitzuteilen, dass sie die Inhalte nicht zum Training eines Modells verwenden sollen. Anders als benannte Crawler wie GPTBot ist es ein gemeinsames Signal, das mehrere Unternehmen gleichzeitig erkennen können – das verringert den Aufwand, jeden einzelnen KI-Crawler namentlich aufzulisten.
Ist der KI-Training-Opt-out in robots.txt ein offizieller IETF-Standard?
Nein. Das konkrete Dokument, das das Token __usage_ai-training definiert, draft-kelley-aipref-training-preference-signal-00, ist ein individueller Internet-Draft, zu dem der IETF-Datatracker ausdrücklich festhält, dass er im IETF-Standardisierungsprozess keinen formalen Status hat. Ein verwandtes Vokabular-Dokument durchläuft tatsächlich eine echte IETF-Arbeitsgruppenprüfung, das robots.txt-Token selbst aber nicht.
Behandeln Google, Microsoft, OpenAI und Anthropic das Token alle gleich?
Nein. Google plant, es in die bestehende Kontrolle Google-Extended einzubinden, sagt aber, dass das erst irgendwann 2027 passiert. Microsoft respektiert das Token ab dem 1. Februar 2027 und behandelt einen separaten Anwendungsfall namens „AI Grounding” anders, außerhalb von robots.txt. OpenAI plant den Rollout „in den kommenden Monaten” ohne festes Datum, und Anthropic, das den Entwurf verfasst hat, gibt an, die Umsetzung bereits begonnen zu haben, nennt aber kein Fertigstellungsdatum.
Warum ist die Microsoft-Frist für Website-Betreiber gerade jetzt wichtig?
Microsoft wird NoArchive und NoCache ab dem 1. März 2027 nicht mehr als Opt-out-Signal gegen KI-Training bei Bing anerkennen. Wer sich derzeit auf diese älteren Tags verlässt, um KI-Training bei Bing zu blockieren, muss das neue Token __usage_ai-training vor diesem Datum in die robots.txt eintragen, sonst entfällt dieser Schutz ohne automatische Rückfalllösung.
Verhindert das neue Token, dass alle KI-Unternehmen meine Inhalte trainieren?
Nein. Es deckt nur Unternehmen ab, die sich zur Einhaltung des gemeinsamen Tokens verpflichtet haben, und selbst dort hängt die Durchsetzung davon ab, dass der jeweilige Crawler sich tatsächlich daran hält. Crawler von Unternehmen, die das Signal nicht übernommen haben, erfordern weiterhin eigene, namentlich benannte Regeln in der robots.txt, wenn man sie blockieren möchte.