KI-Modell-Distillation ist nicht illegal. Warum sprechen OpenAI und Anthropic trotzdem von Diebstahl?
KI-Modell-Distillation ist eine legale, weit verbreitete Trainingsmethode. Was bei DeepSeek, Moonshot AI und Qwen tatsächlich als Diebstahl gilt.

Alle paar Monate landet 2026 ein neues chinesisches KI-Modell an der Spitze eines Benchmark-Charts, der bis dahin OpenAI oder Anthropic gehörte. Und alle paar Monate folgt derselbe Vorwurf: Die amerikanischen Labs behaupten, das Modell in Frage sei trainiert worden, indem man still und leise Antworten aus den eigenen Produkten abgesaugt habe. Die Technik dahinter, KI-Modell-Distillation, ist nicht neu, nicht geheim und nicht illegal. Sie ist Standardpraxis in jedem großen KI-Labor, auch bei denen, die den Vorwurf erheben. Was eine legitime Trainingsmethode tatsächlich von einem Diebstahlsvorwurf trennt, ist viel enger gefasst, als es die Schlagzeilen nahelegen. Bis Mitte 2026 haben drei getrennte Fälle diese Grenze jeweils an einer etwas anderen Stelle gezogen: OpenAI gegen DeepSeek; Anthropic gegen DeepSeek, Moonshot AI und MiniMax; und Anthropic gegen Alibabas Qwen.
Was Distillation eigentlich ist
Wissens-Distillation wurde 2015 in einem Paper von Geoffrey Hinton und Kollegen bei Google formalisiert, Distilling the Knowledge in a Neural Network. Die Idee ist simpel, sobald man sie entpackt: Statt ein kleineres KI-Modell von Grund auf zu trainieren, bringt man ihm bei, die Ausgaben eines größeren, leistungsfähigeren Modells nachzuahmen. Das große Modell wird zum “Lehrer”, das kleine zum “Schüler”, und der Schüler lernt schneller und günstiger, indem er die Antworten des Lehrers studiert statt Rohdaten. Jedes große Labor, OpenAI, Anthropic, Google, Meta, macht das ständig und destilliert seine eigenen großen Flaggschiff-Modelle zu kleineren, günstigeren Versionen herunter, die es billiger verkaufen kann. An der Technik selbst ist nichts anrüchig. An der Methode Distillation war noch nie das Problem, und das bestreitet niemand, auch Anthropic und OpenAI nicht.
Wo “legal” aufhört
Die Trennlinie ist nicht die Technik selbst, sondern woher die Trainingsdaten für das Schüler-Modell stammen. Wenn ein Unternehmen sein eigenes Modell destilliert oder mit Daten trainiert, für die es eine Lizenz besitzt, ist das gewöhnliches Engineering. Problematisch wird es, wenn ein Unternehmen ein Konkurrenzmodell trainiert, indem es automatisiert und in großem Maßstab riesige Mengen an Antworten aus dem Open-Weight-Modell oder der kostenpflichtigen API eines Konkurrenten zieht und diese Antworten ohne Erlaubnis als Trainingsdaten nutzt. OpenAI, Anthropic, Mistral und xAI verbieten das alle ausdrücklich in den Nutzungsbedingungen, die zu jedem API-Konto gehören, dem Kleingedruckten, das fast niemand vor dem Klick auf “Akzeptieren” liest. Diese Klausel, kein Urheberrechtsgesetz, ist der eigentliche juristische Hebel hinter jedem der folgenden Vorwürfe. Sie macht den Streit zu einer Frage gebrochener Vertragsbedingungen, näher an einem Mietvertragsverstoß als an einem Gerichtsstreit ums Urheberrecht, und dieser Unterschied zählt mehr, als es klingt.
Februar 2026: Anthropics Bericht über 24.000 Konten
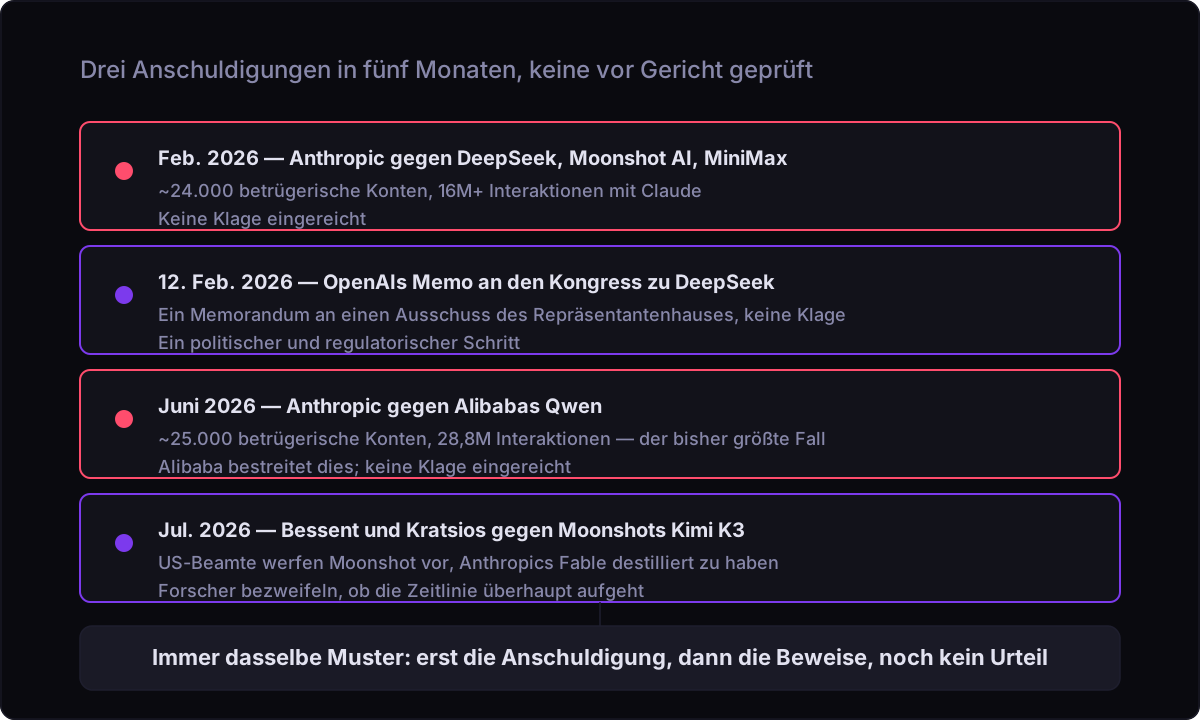
Der bislang am besten dokumentierte Fall kam zuerst. Ende Februar 2026 veröffentlichte Anthropic einen detaillierten Bericht, der DeepSeek, Moonshot AI und MiniMax vorwirft, eine industrielle Distillation-Kampagne gegen Claude betrieben zu haben, das eigene KI-Modell des Unternehmens. Das Unternehmen erklärte, es habe rund 24.000 betrügerische Konten identifiziert, verantwortlich für mehr als 16 Millionen Austausche mit Claude, alle darauf ausgelegt, Trainingsdaten zu sammeln. Der Traffic war nicht gleichmäßig verteilt: MiniMax stand laut Anthropic für den überwältigenden Großteil, mehr als 13 Millionen dieser Austausche; Moonshot AIs Anteil war kleiner, über 3,4 Millionen Austausche. DeepSeeks Anteil war der kleinste der drei und zugleich der gezielteste, rund 150.000 Austausche, die sich laut Anthropic speziell auf Reasoning und Alignment richteten, jenes Sicherheits-Finetuning, das ein Modell davon abhält, Anfragen zu beantworten, die es nicht sollte. Anders gesagt: Anthropic behauptete, DeepSeek habe Claudes Antworten nicht bloß pauschal kopiert, sondern gezielt getestet, wie Claudes Leitplanken funktionieren, um ähnliche Schutzmechanismen bei sich selbst zu umgehen. Der Bericht wurde binnen eines Tages von Bloomberg, CNBC, TechCrunch und CNN aufgegriffen. Keines der drei genannten Unternehmen wurde deswegen verklagt.
Der Fall OpenAI gegen DeepSeek: vor dem Kongress statt vor Gericht
Ein zweiter, separater Fall läuft parallel zum Anthropic-Bericht und wird oft mit ihm verwechselt, weil dasselbe chinesische Labor beteiligt ist. Am 12. Februar 2026 schickte OpenAI ein Memorandum an das Auswahlkomitee des US-Repräsentantenhauses zur Kommunistischen Partei Chinas, in dem argumentiert wird, DeepSeek nutze zunehmend ausgefeilte Distillation-Methoden, um seine Modelle zu trainieren. In diesem Memorandum beschrieb OpenAI programmierten Code und sogenannte “obfuscated third-party router”, Software, die verschleiern soll, woher automatisierte Anfragen an amerikanische KI-Modelle tatsächlich stammten. OpenAI gehörte nicht zu den Zeugen, die bei der Anhörung des Komitees am 16. April zur chinesischen Distillation-Kampagne aussagten. Das ist eine Anschuldigung gegenüber Gesetzgebern, keine Klage. OpenAI hat wegen dieses Vorwurfs bislang keine rechtlichen Schritte gegen DeepSeek eingeleitet. Es ist ein politischer und regulatorischer Schachzug, der beeinflussen soll, wie der Kongress über Exportkontrollen und den KI-Wettbewerb mit China denkt, und genau so sollte man ihn lesen, nicht als abgeschlossenes Urteil über ein Fehlverhalten.
Juni 2026: eine größere Kampagne, diesmal gegen Alibabas Qwen
Drei Monate später ging Anthropic erneut vor den Kongress, diesmal mit einem neuen Vorwurf, der den Februar-Bericht in den Schatten stellte. Im Juni 2026 teilte Anthropic Kongressausschüssen, darunter dem Bankenausschuss des Senats, mit, es habe eine Operation identifiziert, die mit Alibabas Qwen-Modellen in Verbindung steht und rund 25.000 betrügerische Konten und 28,8 Millionen Austausche mit Claude zwischen April und Juni 2026 umfasste, die größte derartige Kampagne, die das Unternehmen eigenen Angaben zufolge bislang dokumentiert hat. Anthropic erklärte, dieser Traffic habe sich stark auf Claudes Coding- und agentische Reasoning-Fähigkeiten konzentriert, jene Teile des Modells, die für einen Konkurrenten, der schnell aufholen will, am wertvollsten sind. Tom’s Hardware berichtete ausführlich über das Ausmaß des Vorwurfs. Alibaba hat die Anschuldigung zurückgewiesen. Wie schon beim Februar-Bericht wurde keine Klage eingereicht, und kein Gericht hat die Beweise für die Behauptung einer der beiden Seiten geprüft.
Juli 2026: Kimi K3 und derselbe Vorwurf von einem neuen Ankläger
Das Muster tauchte innerhalb weniger Wochen erneut auf, diesmal geäußert von der US-Regierung statt von einem konkurrierenden Labor. Im Juli 2026 sorgte Moonshot AIs neueste Veröffentlichung, Kimi K3, eines der größten je veröffentlichten Open-Weight-Modelle, für eine öffentliche Anschuldigung der US-Regierung. Finanzminister Scott Bessent warnte bereits am 21. Juli, Sanktionen könnten im Raum stehen, falls sich ein Verdacht auf Distillation US-amerikanischer Modelle bestätige. Am Tag darauf wurde Michael Kratsios, der oberste Wissenschaftsberater des Weißen Hauses, konkret. Kratsios erklärte auf Social Media, Moonshot habe Anthropics Fable-Modell, das Wochen zuvor gestartet war, destilliert, um Kimi K3 zu bauen. Moonshot war bereits eines der drei Unternehmen, die in Anthropics Februar-Bericht genannt wurden, verantwortlich für über 3,4 der damals gezählten 16 Millionen Austausche, was diesen Fall eher zu einem Wiederaufflammen desselben Streits unter neuem Ankläger macht als zu einem eigenständigen neuen Vorfall. Diese Runde brachte auch schärferen Widerspruch als die früheren: Unabhängige KI-Forscher bezweifelten, ob die Zeitschiene überhaupt aufging, da Fable zum Zeitpunkt von Kimi K3s Erscheinen erst rund zwei Wochen öffentlich verfügbar war. Nathan Lambert, Forscher am Allen Institute for AI, brachte die generelle Skepsis auf den Punkt: Distillation erkläre einen immer kleineren Teil der Leistung eines Modells, je besser die zugrunde liegenden Modelle würden. Jedes Mal, wenn ein chinesisches Labor ein Modell veröffentlicht, das unerwartet gut abschneidet, taucht derselbe Vorwurf wieder auf, und jedes Mal kommt er als Anschuldigung, nicht als Entscheid von jemandem mit der Autorität, die Frage zu klären.
Warum “Diebstahl” mehr rhetorische als juristische Arbeit leistet
Jeder dieser Fälle steckt in der Anschuldigungsphase. Anthropic hat zweimal detaillierte Zahlen veröffentlicht, OpenAI einmal eine Aussage vor dem Kongress eingereicht. Weder Anthropic noch OpenAI haben Klage erhoben, und keines der vier beschuldigten Labore, DeepSeek, Moonshot AI, MiniMax oder Alibaba, wurde von einem Gericht für schuldig befunden, irgendetwas getan zu haben. Alibaba hat den Vorwurf gegen sich aktiv zurückgewiesen. Das alles im strengen juristischen Sinn “Diebstahl” zu nennen, greift den Tatsachen voraus, wie sie derzeit stehen: Diebstahl setzt rechtlich meist voraus, dass überhaupt Eigentum vorlag und dass es unrechtmäßig weggenommen wurde, und der rechtliche Status der eigenen Ausgaben eines KI-Modells ist vor den meisten Gerichten noch ungeklärt, sodass derzeit niemand mit Sicherheit sagen kann, ob sie sich wie ein Foto oder ein Song überhaupt besitzen lassen. Worauf diese Unternehmen mit deutlich mehr Zuversicht verweisen können, ist ein Vertragsbruch: eine Klausel in den API-Nutzungsbedingungen, die automatisierte Massenentnahme von Ausgaben klar verbietet und angeblich in industriellem Maßstab gebrochen wurde. Das ist für sich genommen eine reale, potenziell teure rechtliche Angriffsfläche. Nur ist es eben nicht dasselbe wie ein Urteil wegen Diebstahls, und eine Anschuldigung wie eine bewiesene Tatsache zu behandeln, überspringt genau den Teil des Verfahrens, in dem Beweise von jemand anderem geprüft werden als von dem, der die Behauptung aufstellt.
Das Fazit

Die Technik, die immer wieder Schlagzeilen macht, war nie der eigentliche Streitpunkt. Distillation ist legal, im Kern jahrzehntealt und wird von jedem in diesen Geschichten genannten Labor genutzt, auch von denen, die die Beschwerden einreichen. Was gewöhnliches Engineering von einer Anschuldigung trennt, ist eine einzige vertragliche Linie: ob die Trainingsdaten aus dem Abgreifen der API eines Konkurrenten gegen dessen eigene Regeln stammten. Bis Mitte 2026 wurde diese Linie, den Anklägern zufolge, in drei sich überschneidenden Fällen überschritten, an denen DeepSeek, Moonshot AI, MiniMax und Alibaba beteiligt sind, jeder mehr oder weniger detailliert dokumentiert und keiner vor Gericht geprüft. Bis einer dieser Fälle tatsächlich vor einen Richter kommt, beschreibt “Diebstahl”, wie amerikanische Labs die Geschichte gerne gerahmt sähen, nicht eine Tatsache, die außerhalb dieser Unternehmen bislang jemand die Gelegenheit hatte zu überprüfen.
Häufig gestellte Fragen
Was ist KI-Modell-Distillation, und ist sie illegal?
KI-Modell-Distillation ist eine Trainingsmethode, bei der ein kleineres “Schüler”-Modell lernt, indem es die Ausgaben eines größeren “Lehrer”-Modells nachahmt, eine Technik, die 2015 von Google-Forschern formalisiert wurde. Die Methode selbst ist völlig legal und wird intern von jedem großen KI-Labor eingesetzt. Zum rechtlichen Problem kann werden, wie die Ausgaben des Lehrer-Modells beschafft wurden, nicht die Trainingstechnik an sich.
Warum sprechen OpenAI und Anthropic von Diebstahl, wenn noch kein Gericht entschieden hat?
KI-Distillation als Diebstahl zu bezeichnen ist eine Framing-Entscheidung, kein juristischer Befund. Anthropic und OpenAI haben dokumentiert, was ihrer Darstellung nach eine automatisierte, groß angelegte Entnahme der Ausgaben ihrer Modelle unter Verstoß gegen die eigenen Nutzungsbedingungen ist. Im Fall von Anthropic steckt eine reale Anschuldigung mit realen Zahlen dahinter, aber keines der beiden Unternehmen hat Klage eingereicht, also hat kein Gericht die Behauptung geprüft.
Was genau warf Anthropic DeepSeek, Moonshot AI und MiniMax vor?
Im Februar 2026 berichtete Anthropic von rund 24.000 betrügerischen Konten und über 16 Millionen Austauschen mit Claude, die zum Sammeln von Trainingsdaten genutzt worden seien: mehr als 13 Millionen über MiniMax, über 3,4 Millionen über Moonshot AI und rund 150.000 über DeepSeek, dessen kleinerer Anteil sich gezielt auf das Testen von Claudes Sicherheitsverhalten konzentriert habe. Anthropic nannte es eine industrielle Distillation-Kampagne; keines der drei Unternehmen wurde deswegen verklagt.
Ist der Fall Alibaba und Qwen der bisher größte?
Ja, Anthropics Vorwurf vom Juni 2026 gegen Akteure, die mit Alibabas Qwen-Modellen in Verbindung stehen, ist der bislang größte dokumentierte Fall, mit rund 25.000 betrügerischen Konten und 28,8 Millionen Austauschen mit Claude, mehr als beim Februar-Bericht gegen DeepSeek, Moonshot AI und MiniMax. Alibaba hat den Vorwurf zurückgewiesen, eine Klage ist bislang nicht gefolgt.
Könnte ein solcher Fall jemals tatsächlich vor Gericht landen?
Ein Prozess ist möglich, ist aber in keinem dieser Fälle bislang eingetreten. Dafür müsste eines der anklagenden Labore wegen des angeblichen Verstoßes gegen die Nutzungsbedingungen klagen, und ein Gericht müsste dann Fragen entscheiden, die das geltende Recht bisher nicht klar geregelt hat, etwa ob die Ausgaben eines KI-Modells als Eigentum gelten, das gestohlen werden kann. Bis das passiert, bleibt jeder hier beschriebene Fall eine Anschuldigung, kein Urteil.