La distillation de modèles IA n'est pas illégale. Alors pourquoi OpenAI et Anthropic parlent de vol ?
La distillation de modèles IA est une technique légale et courante. Voici ce qui franchit vraiment la ligne, et pourquoi OpenAI et Anthropic parlent de vol.

Tous les deux ou trois mois en 2026, un modèle d’IA venu de Chine vient détrôner un classement de référence qui appartenait jusque-là à OpenAI ou à Anthropic. Et presque à chaque fois, la même accusation suit. Les laboratoires américains affirment que ce nouveau venu a été entraîné en aspirant discrètement les réponses de leurs propres produits. La technique visée par cette accusation, la distillation de modèles d’IA, n’a rien de nouveau, de secret ni d’illégal en elle-même. C’est une pratique courante chez tous les grands laboratoires d’IA, y compris ceux qui portent l’accusation. Ce qui sépare vraiment une méthode d’entraînement légitime d’un vol reproché est beaucoup plus étroit que ne le laissent penser les gros titres. Mi-2026, trois affaires distinctes ont chacune tracé cette limite un peu différemment : OpenAI contre DeepSeek, Anthropic contre DeepSeek, Moonshot AI et MiniMax, et Anthropic contre Qwen, le modèle d’Alibaba.
Ce qu’est vraiment la distillation
La distillation de connaissances a été formalisée en 2015 dans un article de Geoffrey Hinton et de ses collègues chez Google, Distilling the Knowledge in a Neural Network. L’idée est simple une fois expliquée : au lieu d’entraîner un petit modèle d’IA depuis zéro, on l’entraîne à imiter les réponses d’un modèle plus grand et plus performant. Le grand modèle devient un « professeur », le petit un « élève », et l’élève apprend plus vite et moins cher en étudiant les réponses du professeur plutôt que des données brutes. Tous les grands laboratoires, OpenAI, Anthropic, Google, Meta, font cela en permanence : ils distillent leurs propres modèles phares en versions plus petites et moins chères à vendre. La technique elle-même n’a rien de répréhensible. La distillation comme méthode n’a jamais été le problème, et personne, pas même Anthropic ni OpenAI, ne prétend le contraire.
Où s’arrête le « légal »
La ligne de partage n’est pas la technique en elle-même, mais l’origine des données d’entraînement de ce modèle élève. Si une entreprise distille son propre modèle, ou entraîne sur des données qu’elle a le droit d’utiliser, c’est de l’ingénierie ordinaire. Le problème commence quand une entreprise pompe automatiquement, à grande échelle, d’énormes volumes de réponses depuis le modèle open weight d’un concurrent, un modèle dont les poids entraînés sont publics, ou depuis son API payante. Elle réutilise ensuite ces réponses comme données d’entraînement, sans autorisation, pour construire son propre modèle concurrent. OpenAI, Anthropic, Mistral et xAI interdisent tous explicitement cette pratique dans les conditions d’utilisation attachées à chaque compte API, les petites lignes que presque personne ne lit avant de cliquer sur accepter. Cette clause, et non une quelconque loi sur le droit d’auteur, est le véritable levier juridique derrière chacune des accusations décrites plus bas. Cela fait du litige une affaire de rupture de conditions contractuelles, plus proche d’un manquement à un bail que d’un procès pour droits d’auteur, et cette nuance compte plus qu’elle n’en a l’air.
Février 2026 : le rapport d’Anthropic sur 24 000 comptes
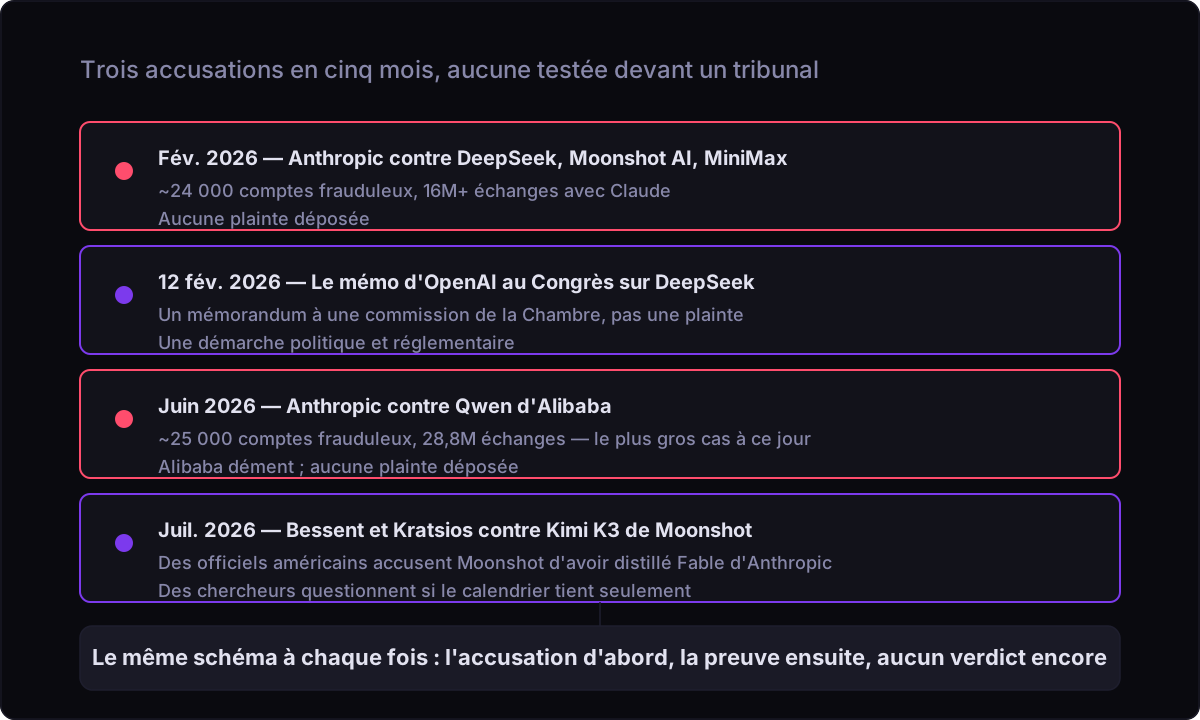
L’affaire la mieux documentée à ce jour est arrivée en premier. Fin février 2026, Anthropic a publié un rapport détaillé accusant DeepSeek, Moonshot AI et MiniMax d’avoir mené une campagne de distillation à l’échelle industrielle contre Claude, son propre modèle d’IA. L’entreprise a affirmé avoir identifié environ 24 000 comptes frauduleux, responsables de plus de 16 millions d’échanges avec Claude, tous destinés à récolter des données d’entraînement. Le trafic n’était pas réparti à parts égales. MiniMax en représentait l’écrasante majorité, plus de 13 millions de ces échanges selon Anthropic. La part de Moonshot AI était plus réduite, un peu plus de 3,4 millions d’échanges. Celle de DeepSeek était la plus petite des trois, mais aussi la plus ciblée : environ 150 000 échanges, qu’Anthropic dit avoir concentrés spécifiquement sur le raisonnement et l’alignement, le réglage de sécurité qui empêche un modèle de répondre à des demandes qu’il ne devrait pas satisfaire. En clair, Anthropic n’accuse pas seulement DeepSeek d’avoir copié les réponses de Claude en bloc : l’entreprise dit que DeepSeek sondait le fonctionnement des garde-fous de Claude pour contourner ses propres restrictions de sécurité de façon similaire. Le rapport a été relayé en moins d’une journée par Bloomberg, CNBC, TechCrunch et CNN. Aucune des trois entreprises citées n’a été poursuivie en justice pour cette affaire.
L’affaire OpenAI-DeepSeek, direction le Congrès plutôt que le tribunal
Une deuxième affaire, distincte, se déroule en parallèle du rapport d’Anthropic, et les deux sont souvent confondues parce qu’elles impliquent le même laboratoire chinois. Le 12 février 2026, OpenAI a envoyé un mémorandum à la commission spéciale de la Chambre des représentants américaine sur le Parti communiste chinois, affirmant que DeepSeek utilise des méthodes de distillation de plus en plus sophistiquées pour entraîner ses modèles. Dans ce mémorandum, OpenAI a décrit du code programmatique et ce qu’elle appelle des « routeurs tiers obfusqués », des logiciels conçus pour dissimuler d’où venaient réellement les requêtes automatisées adressées aux modèles d’IA américains. OpenAI ne figurait pas parmi les témoins entendus lors de l’audition du 16 avril de la commission, consacrée à la campagne de distillation chinoise. Il s’agit d’une allégation présentée à des élus, pas d’une plainte. OpenAI n’a engagé aucune action en justice contre DeepSeek sur la base de cette accusation. C’est une démarche politique et réglementaire, destinée à orienter la façon dont le Congrès envisage les contrôles à l’exportation et la concurrence dans l’IA face à la Chine, et elle doit être lue comme telle plutôt que comme une conclusion établie de faute avérée.
Juin 2026 : une campagne plus large, cette fois contre Qwen d’Alibaba
Trois mois plus tard, Anthropic est retourné devant le Congrès avec une nouvelle accusation, et celle-ci éclipsait le rapport de février. En juin 2026, Anthropic a déclaré devant des commissions du Congrès, dont la commission bancaire du Sénat, avoir identifié une opération liée aux modèles Qwen d’Alibaba faisant tourner environ 25 000 comptes frauduleux et 28,8 millions d’échanges avec Claude entre avril et juin 2026, la plus grande campagne de ce type que l’entreprise dit avoir documentée à ce jour. Anthropic a précisé que ce trafic se concentrait fortement sur les capacités de Claude en code et en raisonnement agentique, les compétences les plus précieuses pour un concurrent qui cherche à rattraper son retard rapidement. Tom’s Hardware a rapporté l’ampleur de cette accusation en détail. Alibaba a démenti l’accusation. Comme pour le rapport de février, aucune plainte n’a été déposée, et aucun tribunal n’a examiné les preuves avancées par l’une ou l’autre partie.
Juillet 2026 : Kimi K3, et la même accusation portée par un nouvel accusateur
Le même schéma est réapparu quelques semaines plus tard, porté cette fois par le gouvernement américain plutôt que par un laboratoire concurrent. En juillet 2026, la dernière sortie de Moonshot AI, Kimi K3, l’un des plus grands modèles open weight jamais publiés, a suscité une accusation publique venue du gouvernement américain. Le secrétaire au Trésor Scott Bessent avait averti le 21 juillet que des sanctions pourraient être envisagées en cas de distillation suspectée de modèles américains. Le lendemain, Michael Kratsios, le plus haut conseiller scientifique de la Maison-Blanche, a précisé l’accusation. Kratsios a affirmé sur les réseaux sociaux que Moonshot avait distillé le modèle Fable d’Anthropic, lancé quelques semaines plus tôt, pour construire Kimi K3. Moonshot faisait déjà partie des trois entreprises citées dans le rapport de février d’Anthropic, responsable de plus de 3,4 millions des 16 millions d’échanges recensés à l’époque, ce qui fait de cet épisode moins un nouvel incident que le même différend qui refait surface sous un nouvel accusateur. Ce round a aussi suscité une contestation plus vive que les précédents : des chercheurs indépendants en IA ont mis en doute le calendrier lui-même, Fable n’ayant été publiquement disponible qu’environ deux semaines avant la sortie de Kimi K3. Nathan Lambert, chercheur à l’Allen Institute for AI, a résumé ce scepticisme plus large : la distillation explique de moins en moins la performance d’un modèle à mesure que les modèles sous-jacents progressent. Chaque fois qu’un laboratoire chinois publie un modèle qui performe de façon inattendue, la même accusation resurgit, et chaque fois, elle arrive comme une accusation, pas comme un verdict rendu par une autorité compétente pour trancher la question.
Pourquoi « vol » fait plus de travail rhétorique que juridique
Chacune de ces affaires en est au stade de l’accusation. Anthropic a publié des chiffres détaillés à deux reprises. OpenAI a soumis un témoignage au Congrès une fois. Ni Anthropic ni OpenAI n’a déposé de plainte, et aucun des quatre laboratoires accusés, DeepSeek, Moonshot AI, MiniMax ou Alibaba, n’a été reconnu coupable de quoi que ce soit par un tribunal. Alibaba a activement démenti l’accusation portée contre elle. Qualifier l’un de ces cas de « vol » au sens juridique strict va plus vite que les faits actuels ne le permettent : en droit, le vol suppose en général d’établir qu’une chose constituait bien une propriété, puis qu’elle a été prise sans droit, et le statut juridique des réponses générées par un modèle d’IA reste, dans la plupart des tribunaux, une question non tranchée. Personne ne peut donc encore affirmer avec certitude si elles peuvent être possédées comme le sont une photographie ou une chanson. Ce que ces entreprises peuvent invoquer avec plus d’assurance, c’est une rupture de contrat : une clause des conditions d’utilisation de leur API qui interdit clairement l’extraction automatisée en masse de leurs réponses, une clause prétendument enfreinte à l’échelle industrielle. C’est une exposition juridique réelle, potentiellement coûteuse, en soi. Ce n’est simplement pas la même chose qu’un verdict de vol, et traiter une accusation comme un fait avéré revient à sauter l’étape où la preuve est examinée par quelqu’un d’autre que l’entreprise qui porte l’accusation.
L’idée à retenir

La technique qui fait les gros titres n’a jamais été le vrai sujet du différend. La distillation est légale, ancienne dans son principe, et utilisée par chaque laboratoire cité dans ces affaires, y compris ceux qui portent plainte. Ce qui sépare l’ingénierie ordinaire d’une accusation tient à une seule ligne contractuelle : la question de savoir si les données d’entraînement viennent d’un pompage automatisé de l’API d’un concurrent, en violation de ses propres règles. Mi-2026, cette ligne a été franchie, selon les accusateurs, dans trois affaires qui se chevauchent et impliquent DeepSeek, Moonshot AI, MiniMax et Alibaba, chacune documentée avec plus ou moins de détails, et aucune testée devant un tribunal. Tant qu’une de ces affaires n’aura pas atteint un juge, « vol » décrit la façon dont les laboratoires américains veulent voir l’histoire racontée, pas un fait que quiconque en dehors de ces entreprises a eu l’occasion de vérifier.
FAQ
Qu’est-ce que la distillation de modèles d’IA, et est-ce illégal ?
La distillation de modèles d’IA est une méthode d’entraînement où un petit modèle « élève » apprend en imitant les réponses d’un modèle « professeur » plus grand, une technique formalisée par des chercheurs de Google en 2015. La méthode elle-même est parfaitement légale et utilisée en interne par tous les grands laboratoires d’IA. Ce qui peut devenir un problème juridique, c’est comment les réponses du professeur ont été obtenues, pas la technique d’entraînement en tant que telle.
Pourquoi OpenAI et Anthropic parlent-ils de vol si aucun tribunal n’a tranché ?
Qualifier la distillation de vol relève d’un choix de communication, pas d’une conclusion juridique. Anthropic et OpenAI ont documenté ce qu’elles décrivent comme une extraction automatisée à grande échelle des réponses de leurs modèles, en violation de leurs propres conditions d’utilisation. C’est une accusation sérieuse, appuyée par des chiffres précis dans le cas d’Anthropic, mais ni l’une ni l’autre entreprise n’a déposé plainte, donc aucun tribunal n’a testé cette accusation.
Qu’a exactement reproché Anthropic à DeepSeek, Moonshot AI et MiniMax ?
En février 2026, Anthropic a rapporté environ 24 000 comptes frauduleux et plus de 16 millions d’échanges avec Claude utilisés pour récolter des données d’entraînement : plus de 13 millions via MiniMax, plus de 3,4 millions via Moonshot AI et environ 150 000 via DeepSeek, dont la part la plus faible visait spécifiquement le sondage des comportements de sécurité de Claude. Anthropic a qualifié cela de campagne de distillation à l’échelle industrielle. Aucune des trois entreprises n’a été poursuivie en justice pour cette affaire.
L’affaire Alibaba et Qwen est-elle la plus grosse à ce jour ?
Oui, l’accusation portée par Anthropic en juin 2026 contre des opérateurs liés aux modèles Qwen d’Alibaba est la plus grande documentée à ce jour, avec environ 25 000 comptes frauduleux et 28,8 millions d’échanges avec Claude cités, davantage que le rapport de février contre DeepSeek, Moonshot AI et MiniMax. Alibaba a démenti l’accusation, et aucune plainte n’a suivi.
Une affaire de distillation d’IA comme celle-ci pourrait-elle un jour vraiment aller devant un tribunal ?
Un procès reste possible dans ces affaires de distillation entre laboratoires d’IA, mais aucun n’a encore eu lieu à ce jour. Il faudrait qu’un des laboratoires accusateurs porte plainte pour rupture des conditions d’utilisation, et un tribunal devrait alors trancher des questions que le droit actuel n’a pas clairement réglées, comme celle de savoir si les réponses générées par un modèle d’IA comptent comme une propriété qui peut être volée. Tant que cela n’arrive pas, chaque affaire décrite ici reste une accusation, pas un verdict.