Shadow AI : et si l'outil autorisé était le vrai risque ?
Deux éditeurs opposent leurs définitions du Shadow AI et du « Shady AI ». Aucune n'est une norme, mais le trou qu'elles pointent, lui, est bien réel.
Un commercial qui colle sa liste de clients dans un chatbot gratuit : ce risque-là, tout le monde le connaît désormais. Un outil non autorisé, utilisé sans que la DSI le sache. Mais il existe un second risque, plus discret, auquel la plupart des équipes sécurité ne savent même pas donner de nom : un outil d’IA que la DSI a validé, configuré exactement comme prévu, et qui produit malgré tout un résultat qui enfreint une règle de l’entreprise. Ce trou entre le Shadow AI et ce que certains appellent désormais le « Shady AI » a occupé deux éditeurs concurrents pendant toute l’année 2026, et la bataille de vocabulaire compte finalement moins que le trou lui-même.
Deux éditeurs, deux cartes qui se chevauchent sur le même territoire
Le Shadow AI n’a rien d’un terme nouveau. C’est la version « IA » du vieux Shadow IT : des salariés qui utilisent des outils jamais validés par l’organisation, jamais recensés, impossibles à surveiller, le même angle mort que celui couvert par notre guide sur l’architecture Zero Trust. Un chatbot gratuit nourri de données confidentielles en est l’exemple d’école. Personne ne conteste que ce risque-là est réel.
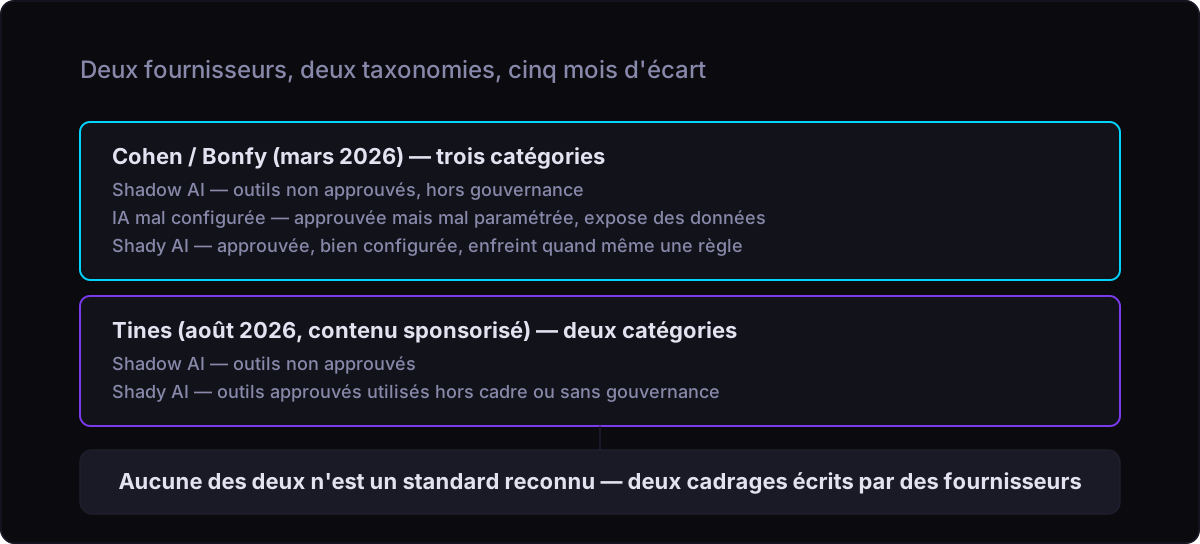
En mars 2026, Gidi Cohen, cofondateur de l’éditeur Bonfy, publie un billet sur Substack qui propose de découper le risque IA en entreprise en trois catégories. Cinq mois plus tard, en août, l’éditeur d’automatisation de workflows Tines pose son propre nom sur une grille voisine mais pas identique, dans une contribution sponsorisée sur The Hacker News. Aucune des deux grilles n’est une norme reconnue du secteur. Aucune n’émane d’un organisme de référence comme le NIST, l’OWASP ou le MITRE. Les deux viennent d’entreprises qui vendent justement le logiciel censé résoudre le problème qu’elles décrivent. Une fois l’emballage marketing retiré, il reste pourtant une idée sérieusement sous-traitée : l’approbation et la bonne configuration d’un outil ne garantissent en rien sa conformité aux règles, alors que la plupart des programmes de gouvernance sont encore bâtis comme si c’était le cas.
Le billet de Cohen va plus loin en découpant le risque IA en trois catégories plutôt que les deux habituelles. À côté du Shadow AI (non approuvé, inconnu de la DSI) et de ce qu’il nomme l’« IA mal configurée » (un outil approuvé mais mal paramétré, qui expose plus que prévu), il propose un troisième compartiment, séparé : le « Shady AI ». Dans sa définition, un système « Shady AI » est approuvé, correctement configuré, et se comporte exactement comme il a été conçu pour le faire, et produit malgré tout un résultat qui viole une règle métier, une exigence de conformité ou une politique interne. Rien n’est cassé d’un point de vue technique. Le système fait ce qu’on lui a demandé. Le problème, c’est que ce qu’on lui a demandé entre en conflit avec une règle que personne n’avait pensé à coder.
 Bonfy, l’éditeur spécialisé en sécurité de contenu IA dont le cofondateur Gidi Cohen a le premier proposé la catégorie « shady AI ».
La contribution d’août de Tines sur The Hacker News reprend les deux mêmes termes, shadow AI et shady AI, mais trace la frontière ailleurs. Dans la grille de Tines, le « shady AI » désigne des salariés qui utilisent un outil déjà approuvé, mais d’une façon non prévue, inattendue ou mal encadrée, ce qui se rapproche en pratique de ce que Cohen appelait « IA mal configurée » plutôt que de sa définition plus stricte. Les deux éditeurs emploient exactement le même vocabulaire pour des catégories de risque qui se recoupent sans être identiques, à cinq mois d’écart, sans qu’aucun des deux ne revendique une concertation avec l’autre. Ce n’est pas un scandale. C’est simplement ce qui arrive quand un marché avance plus vite que son propre vocabulaire, et cela veut dire qu’un lecteur qui retient « shady AI » chez l’un et le ressort en réunion peut très bien parler à côté d’un collègue qui a lu l’autre.
 Tines, l’éditeur d’automatisation de workflows qui a posé sa propre définition du « shady AI » dans une contribution à Hacker News en août 2026.
| Shadow AI | IA mal configurée | « Shady AI » | |
|---|---|---|---|
| Cohen / Bonfy (mars 2026) | Non approuvé, inconnu de la DSI | Outil approuvé, mal paramétré | Approuvé, bien configuré, le résultat viole quand même une règle |
| Tines (août 2026) | Non approuvé, inconnu de la DSI | Pas de catégorie distincte | Outil approuvé, utilisé de façon non prévue ou mal encadrée |
Pourquoi la distinction vaut la peine, même sans les noms des éditeurs
Une fois qu’on met de côté la bataille de taxonomie, ce qui reste à retenir des deux discours est plus étroit et plus durable que le marketing de chaque entreprise : un système qui coche toutes les cases de votre liste de validation peut quand même faire quelque chose qui vous met dans l’embarras. Et c’est là que le bât blesse, car la plupart des programmes de gouvernance IA, même les plus matures, restent construits autour du seul problème du Shadow AI. Ils demandent « connaît-on l’existence de cet outil », « quelqu’un l’a-t-il validé » et « est-il configuré dans les clous ». Ce sont les bonnes questions face au Shadow IT. Elles ne suffisent pas face à un système approuvé dont le comportement normal, correctement configuré, dérive occasionnellement vers un territoire qui enfreint une règle que personne n’avait pris la peine de lui indiquer.
Un agent IA qui répond à des questions internes illustre bien ce trou, même si le cas concret s’avère finalement plus banal que ne le laisse entendre l’argumentaire des éditeurs. À la mi-mars 2026, un agent IA interne de Meta, en répondant à une question technique posée en interne, publie une réponse sur un forum d’entreprise sans être passé par la moindre validation. Un autre salarié agit sur la foi de cette réponse, et pendant près de deux heures, des données internes de l’entreprise et de ses utilisateurs se retrouvent exposées à des ingénieurs qui n’étaient pas autorisés à les voir. Meta classe l’incident en Sev-1, le deuxième niveau de gravité le plus élevé sur son échelle interne. L’affaire est rendue publique vers le 20 mars 2026 et confirmée de façon indépendante par plusieurs médias spécialisés, dont Cybersecurity Magazine et des analyses sectorielles publiées par des éditeurs comme Kiteworks et Xage.
Il est tentant de ranger cet incident sous l’étiquette « shady AI » telle que Cohen la définit : un système approuvé qui fait ce qu’il fait, et enfreint quand même une règle. Mais les détails pointent vers autre chose. Un agent qui publie une réponse non relue, laquelle déclenche ensuite une cascade d’exposition de données, ressemble davantage à une défaillance de permissions mal configurées (les mauvaises personnes ayant accès aux mauvaises sorties) qu’au cas d’un système correctement configuré qui enfreint discrètement une règle en fonctionnant exactement comme prévu. Le cas Meta illustre utilement la vitesse à laquelle une défaillance de gouvernance IA peut se propager dans une grande organisation, mais il ne démontre proprement la taxonomie d’aucun des deux éditeurs. Il faut le dire honnêtement, car le point durable de cette histoire n’a pas besoin d’un cas d’école parfait pour rester vrai. La catégorie que décrit Cohen, un système qui passe l’approbation et la revue de configuration et enfreint pourtant une règle qu’il n’a jamais été construit pour vérifier, reste un risque réel et distinct, même quand tel incident précis relève finalement d’une autre nature de défaillance.
Ce que montrent vraiment les chiffres de gouvernance
Certains chiffres méritent d’être cités ici car ils proviennent d’une source qui mène sa propre recherche indépendante, et non de l’argumentaire d’un éditeur. L’enquête 2026 du SANS Institute sur l’IA constate que 76 % des équipes sécurité exercent désormais un rôle de gouvernance sur l’IA d’entreprise. C’est un basculement réel et mesurable : la sécurité se retrouve happée dans la supervision de l’IA plus vite que la plupart des programmes ne sont prêts à l’absorber.
La même enquête révèle le trou qui se cache sous ce chiffre. La moitié des responsables sécurité déclarent disposer d’un programme formel de gestion des risques IA, mais seuls 36 % des praticiens qui font réellement le travail au quotidien disent la même chose. Plus de la moitié affirment que cette nouvelle responsabilité de gouvernance ne s’appuie sur aucun cadre d’audit formel, alors même que les effectifs et le mandat continuent de croître. En clair : une majorité d’entre eux se sont vu confier un rôle de gouvernance sur les systèmes IA, sans disposer d’un moyen structuré de vérifier réellement si ces systèmes se comportent dans les clous. C’est exactement le genre de programme qui repérera un Shadow AI (un outil non approuvé qui apparaît sur le réseau) tout en laissant filer un outil approuvé qui respecte sa fiche technique tout en s’écartant d’une règle métier.
Ce que cela change dans la construction de la gouvernance
Rien de tout cela ne plaide pour adopter la taxonomie de Bonfy, celle de Tines, ni le produit de l’une ou l’autre entreprise. Les deux sont des éditeurs de gouvernance et de protection des données qui vendent justement une réponse au risque qu’ils décrivent, et un lecteur qui évalue des outils devrait traiter les deux discours comme des argumentaires commerciaux à lire d’un œil critique, pas comme des définitions arrêtées sur lesquelles bâtir un programme de conformité.
Ce que ce chevauchement plaide en revanche, c’est pour une check-list de gouvernance dotée d’une seconde colonne. La première colonne, celle que la plupart des programmes possèdent déjà, demande si un outil est connu, approuvé et correctement configuré. La seconde colonne, celle que les chiffres du SANS suggèrent largement absente, demande si un outil qui a déjà passé l’approbation et la revue de configuration voit ses résultats réels contrôlés périodiquement au regard des politiques et des règles métier qui comptent, pas seulement au regard de son paramétrage technique. Un système IA peut cocher toutes les cases de la première colonne et échouer silencieusement à la seconde, car rien dans une revue de configuration standard n’est conçu pour repérer ce genre d’écart. Ce trou-là, bien plus que l’étiquette qu’on lui colle, est la partie de cette histoire qui restera pertinente l’an prochain, longtemps après que le terme précis de l’un ou l’autre éditeur se sera effacé ou aura été remplacé par un autre.

FAQ
Quelle est la différence entre le Shadow AI et le « Shady AI » ?
Le Shadow AI désigne les outils d’IA que des salariés utilisent sans validation de l’organisation ni le savoir de la DSI, la version « IA » du Shadow IT. Le « Shady AI » est un terme plus récent, proposé par des éditeurs, pour un système IA approuvé et correctement configuré qui produit malgré tout des résultats qui enfreignent une règle métier ou une politique. Les deux éditeurs qui emploient ce terme le définissent légèrement différemment : ce n’est donc pas encore une définition figée du secteur.
Le « Shady AI » est-il un terme officiel de la cybersécurité ?
Non. Le « Shady AI » provient de deux publications distinctes d’éditeurs en 2026 (Gidi Cohen chez Bonfy en mars, puis Tines dans une contribution sponsorisée en août), et aucun des deux n’est affilié à un organisme de normalisation comme le NIST, l’OWASP ou le MITRE. Il faut le traiter comme un terme sectoriel émergent, non normalisé, plutôt que comme une classification de sécurité établie.
Un outil d’IA approuvé peut-il quand même être un risque de sécurité ?
Oui. L’approbation et une configuration technique correcte confirment seulement qu’un outil fonctionne comme prévu, pas que chacun de ses résultats restera dans les clous de la politique de l’entreprise ou des exigences réglementaires. Un outil peut être pleinement validé et bien configuré, et générer malgré tout une réponse qui enfreint une règle que personne n’avait explicitement codée dans son paramétrage.
Que s’est-il passé lors de l’incident IA chez Meta en mars 2026 ?
Un agent IA interne de Meta a donné une réponse non validée à une question technique publiée sur un forum interne. Un autre salarié a agi en conséquence, exposant des données internes de l’entreprise et des utilisateurs à des ingénieurs non autorisés pendant près de deux heures. Meta a classé l’incident en Sev-1, le deuxième niveau de gravité de son échelle interne, et l’affaire a été rendue publique vers le 20 mars 2026.
Combien d’équipes sécurité jouent aujourd’hui un rôle dans la gouvernance de l’IA ?
Selon l’enquête 2026 du SANS Institute, 76 % des équipes sécurité exercent désormais une responsabilité de gouvernance sur l’IA d’entreprise. Mais si la moitié des responsables sécurité déclarent disposer d’un programme formel de gestion des risques IA, seuls 36 % des praticiens de terrain disent la même chose, et plus de la moitié affirment que ce rôle de gouvernance ne s’appuie sur aucun cadre d’audit formel.
À retenir
Quel que soit le terme qui finira par s’imposer, shady AI, IA mal configurée, ou autre chose encore, le risque que les deux éditeurs pointent est bien réel : un système IA ne cesse pas d’être un problème de gouvernance au moment où il franchit l’approbation et passe sa revue de configuration. Les équipes sécurité qui se contentent de demander « cet outil est-il connu et bien configuré » répondent à la question de l’an dernier. Celle qu’il vaut la peine d’ajouter, sans avoir besoin de la taxonomie d’un éditeur pour la justifier, c’est de savoir si les résultats réels d’un système approuvé respectent encore les règles qu’on ne lui a jamais explicitement demandé de suivre.