Mac mini M6 et Mac Studio M5 Ultra : Apple vend enfin l'IA locale
Apple mise sur l'IA locale avec ses puces M6 et M5 Ultra. Ce qui change vraiment pour le Mac mini et le Mac Studio, et pour qui c'est utile.
Mac mini M6 et Mac Studio M5 Ultra : Apple vend enfin l’IA locale
Apple vient de présenter de nouvelles versions du Mac mini et du Mac Studio. Et pour la première fois, l’argument de vente n’est pas la rapidité du montage vidéo. L’argument, c’est la taille du modèle d’IA que la machine peut faire tourner entièrement chez vous, sans envoyer le moindre prompt vers le cloud. Les puces qui équipent ces machines, baptisées M6 et M5 Ultra, restent de l’Apple Silicon classique, tournent toujours sous macOS, et ressemblent aux Mac que la marque vend depuis des années. Ce qui a changé, c’est le discours commercial. Et ce glissement en dit long sur la direction que prend l’informatique de bureau.
Ce qu’Apple a réellement annoncé
Le nouveau Mac mini embarque la puce M6, la première d’Apple gravée en 2 nanomètres (une mesure de la finesse des transistors : plus c’est petit, plus on peut caser de calcul dans le même espace, pour moins d’énergie consommée). La configuration de base associe un CPU 12 cœurs à un GPU 12 cœurs doté d’accélérateurs neuronaux dans chaque cœur, plus un Neural Engine double 16 cœurs — un bloc de silicium à part, conçu spécifiquement pour exécuter des tâches d’IA plutôt que du calcul généraliste. Ce Mac mini d’entrée de gamme démarre à 16 Go de mémoire partagée, configurable jusqu’à 32 Go, avec un stockage entre 256 Go et 2 To.
Une autre déclinaison du Mac mini, plus chère, utilise une puce M5 Pro, qui va de 15 cœurs CPU / 16 cœurs GPU jusqu’à 18 cœurs CPU / 20 cœurs GPU, avec 24 à 64 Go de mémoire. C’est une puce fondamentalement différente, dans une tranche de prix fondamentalement différente du Mac mini M6 de base, et les deux se retrouvent sans cesse mélangés dans les articles rapides. Si un titre dit juste « Mac mini » sans préciser la puce, il peut s’agir de l’une ou l’autre machine.
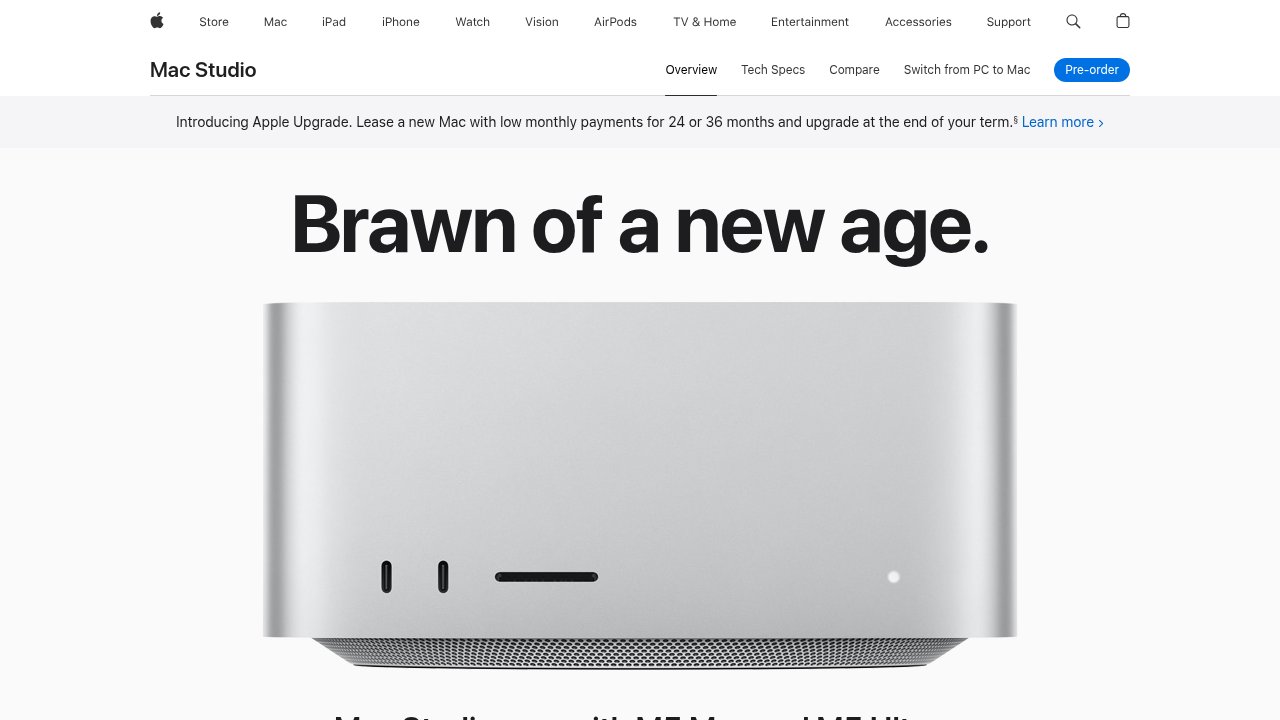
En haut de gamme, le Mac Studio se décline en deux versions. La version intermédiaire utilise une puce M5 Max (CPU 18 cœurs, jusqu’à 40 cœurs GPU, jusqu’à 128 Go de mémoire). Le haut de gamme utilise la M5 Ultra, un type de puce vraiment nouveau pour Apple : elle est fabriquée en soudant quatre puces distinctes grâce à la technologie UltraFusion, la technique d’interconnexion maison qui assemble plusieurs puces pour qu’elles se comportent comme un seul processeur. Apple avait déjà fabriqué des puces Ultra à deux puces ; c’est la première fois qu’elle passe à quatre. La M5 Ultra va d’un CPU 30 cœurs et d’un GPU 64 cœurs avec 96 Go de mémoire en entrée de gamme, jusqu’à 36 cœurs CPU et 80 cœurs GPU au sommet.
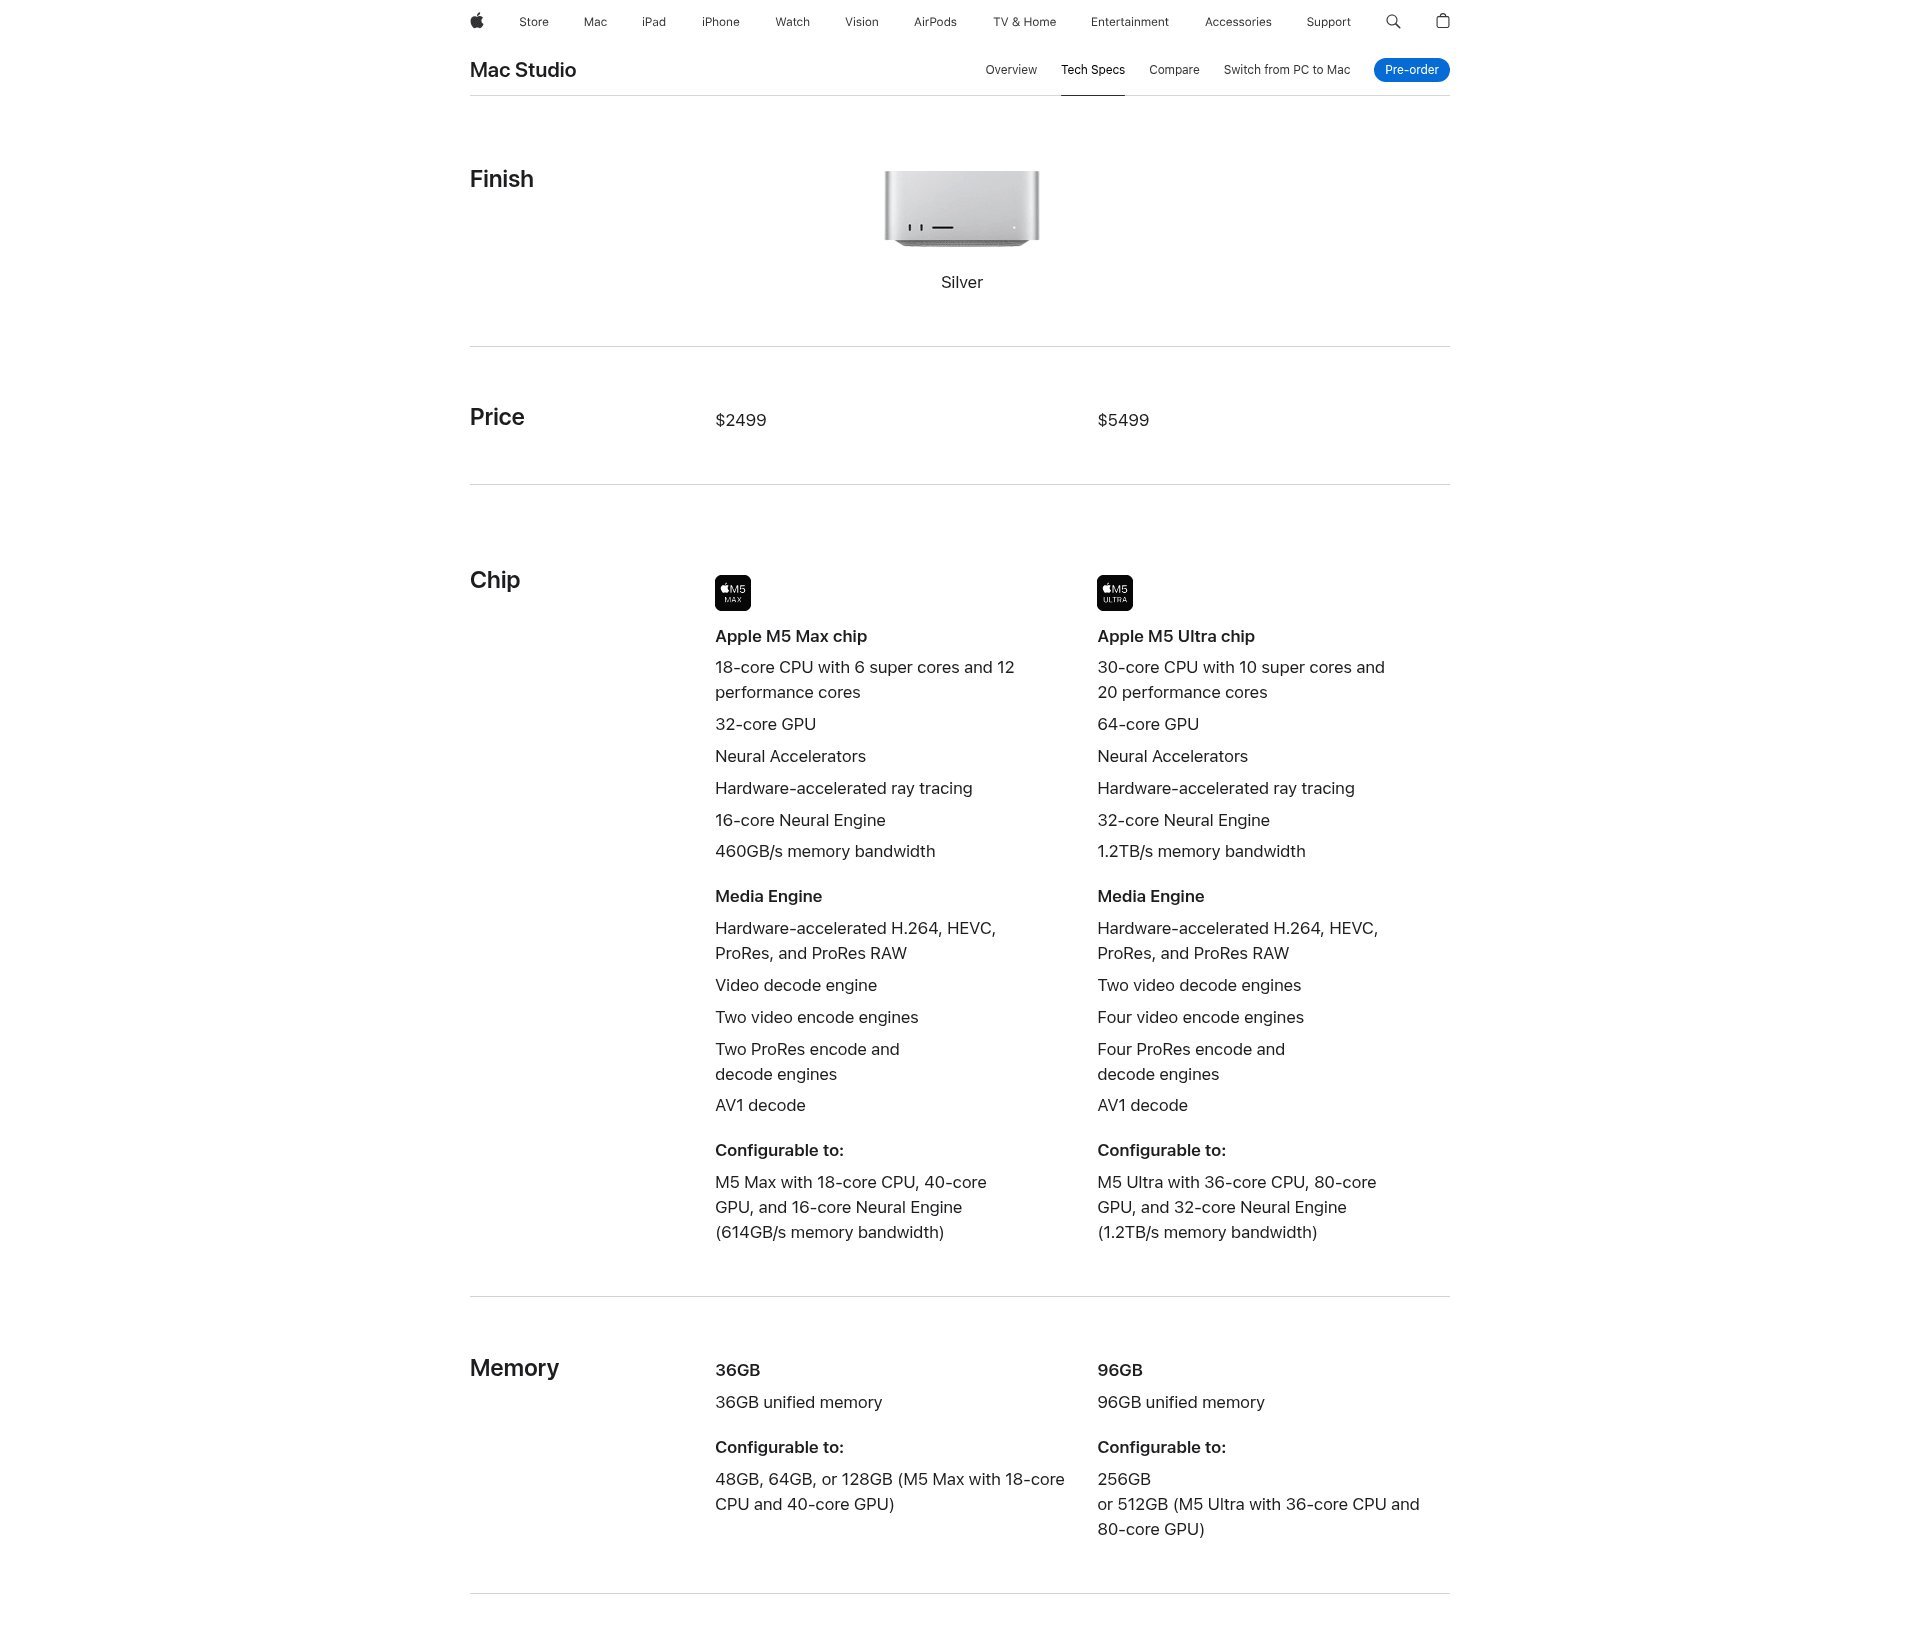
Mac Studio — la page officielle des spécifications techniques d’Apple pour les configurations M5 Max et M5 Ultra du Mac Studio.
Un détail mérite qu’on s’y arrête : même la configuration phare n’est pas totalement disponible au lancement. Le palier de 512 Go de mémoire pour le Mac Studio M5 Ultra n’arrive que fin octobre, plusieurs semaines après le lancement général. Apple a ouvert les précommandes autour de l’annonce, mais la disponibilité générale de la gamme est fixée au 22 septembre 2026. Aucune de ces machines n’est encore en rayon, et la version avec le plus de mémoire ne sera livrée que deux mois plus tard. Apple n’a pour l’instant publié aucun prix de vente officiel sur des pages vérifiables : tout chiffre en euros ou en dollars qui circule dans les premiers articles doit être lu comme une estimation de la presse, pas comme un tarif confirmé par Apple, tant que les pages d’achat ne sont pas en ligne.
Pourquoi Apple présente ça comme une machine à IA, pas juste un Mac plus rapide
Le discours marketing d’Apple pour ce lancement s’appuie fortement sur des comparaisons propres à l’IA, plutôt que sur les scores de performance généralistes utilisés depuis des années. Pour le M6, Apple annonce un GPU délivrant près de 30 % de calcul IA en plus par rapport à la puce M5 précédente, une génération plus tôt dans la même famille. C’est une revendication précise sur le calcul GPU dédié à l’IA, pas un score de performance globale, et elle compare le M6 à son propre prédécesseur direct, pas au matériel d’un concurrent.
Séparément, le marketing d’Apple pour le Mac mini avance aussi jusqu’à 4 fois plus de performance IA pour le nouveau Mac mini M6, comparé à l’ancien Mac mini construit autour de la puce M4. Il vaut la peine d’être précis sur ce que cela signifie en pratique : ce chiffre est produit par Apple sur son propre produit, mesuré face à sa propre génération précédente, pas un benchmark indépendant validé par un laboratoire ou un testeur. Il se lit donc comme une revendication commerciale, pas comme un fait établi.
La M5 Ultra a son propre multiplicateur, et c’est une comparaison totalement différente. Apple annonce que la M5 Ultra délivre jusqu’à 4,3 fois plus de calcul IA au pic par rapport à la M3 Ultra, la génération d’il y a deux crans, et non face à la M5 Max qui se trouve juste en dessous dans la gamme actuelle. Confondre la puce de référence d’un multiplicateur est une erreur facile à faire en lisant un communiqué de presse en diagonale — et c’est exactement le genre de détail qui transforme un chiffre en titre erroné.
Côté mémoire, Apple avance deux chiffres de bande passante réellement différents, eux aussi souvent confondus. Le M6 du Mac mini offre jusqu’à 170 Go/s de bande passante de mémoire unifiée (une mesure de la vitesse à laquelle la puce peut lire et écrire dans son réservoir de mémoire partagée). La M5 Ultra, une puce complètement différente dans une classe de machine complètement différente, affiche une bande passante inter-puces de plus de 4,4 To/s qui relie ses quatre puces fusionnées entre elles, et une bande passante de mémoire unifiée séparée de 1,2 To/s, qu’Apple annonce 50 % supérieure à celle de la M3 Ultra précédente. Ce sont trois chiffres distincts qui décrivent trois réalités différentes sur deux puces différentes. Aucun de ces chiffres n’est audité de façon indépendante : ce sont les chiffres publiés par Apple sur son propre matériel.
Mémoire unifiée contre VRAM : pourquoi la comparaison n’est pas si simple
Avant de comparer tout ça au matériel local d’IA de Nvidia, il vaut la peine de relire l’article de DecodeStack sur l’exécution de modèles d’IA sur du matériel GPU dédié, qui pose l’arbitrage sur lequel repose toute cette catégorie de machines.
Chaque puce Apple Silicon, de la plus petite MacBook Air jusqu’à la M5 Ultra, utilise ce qu’Apple appelle la mémoire unifiée : un seul réservoir de mémoire partagé par le CPU, le GPU et le Neural Engine, au lieu d’une mémoire réservée séparément à chaque composant. Sur une carte graphique classique, de jeu ou de station de travail, le GPU dispose de sa propre mémoire dédiée, communément appelée VRAM, soudée physiquement sur la carte et invisible pour le reste du système. Si une tâche a besoin de plus de mémoire que ce que porte la carte, elle ne peut tout simplement pas tourner sur ce GPU, quelle que soit la mémoire système disponible ailleurs dans l’ordinateur.
Cette distinction explique précisément pourquoi l’approche Apple Silicon devient compétitive pour les gros modèles d’IA en local, spécifiquement grâce à la capacité mémoire, pas à la vitesse brute. Un grand modèle de langage qui a besoin, disons, de 90 Go de mémoire rien que pour se charger peut tenir dans une machine M5 Ultra configurée avec assez de mémoire unifiée, parce que la totalité du réservoir est disponible pour la tâche. Ce même modèle serait hors de portée d’une carte graphique dont la VRAM plafonne bien en dessous de ce chiffre, à moins de le découper, de le décharger vers une mémoire système plus lente, ou de faire des compromis.
C’est la comparaison honnête avec le DGX Spark de Nvidia, que DecodeStack avait traité dans une comparaison face à l’ASUS Ascent GX10, une machine rivale bâtie sur la même puce Nvidia. Les petits systèmes IA de bureau de Nvidia utilisent eux aussi une forme de mémoire partagée, embarquée sur le module, plutôt qu’un réservoir de VRAM dédié séparé — c’est en partie ce qui justifie l’existence de cette catégorie : permettre à des développeurs isolés ou à de petites équipes de faire tourner des modèles qui exigeraient autrement toute une baie de GPU de datacenter. Mais un réservoir de mémoire partagée n’est pas automatiquement l’option la plus rapide ou la meilleure : c’est un arbitrage différent. L’écosystème de Nvidia, bâti autour de sa plateforme logicielle CUDA (la boîte à outils sur laquelle la majorité du code d’entraînement et de recherche en IA est écrite), reste la référence par défaut pour quiconque entraîne sérieusement des modèles ou cherche le débit brut maximal. Un GPU dédié comme une RTX 5090 dépassera généralement un Mac à mémoire unifiée sur les tâches qui tiennent confortablement dans sa VRAM, parce qu’une bande passante mémoire dédiée par cœur, pensée pour ça, a un avantage réel quand la capacité n’est pas le facteur limitant.
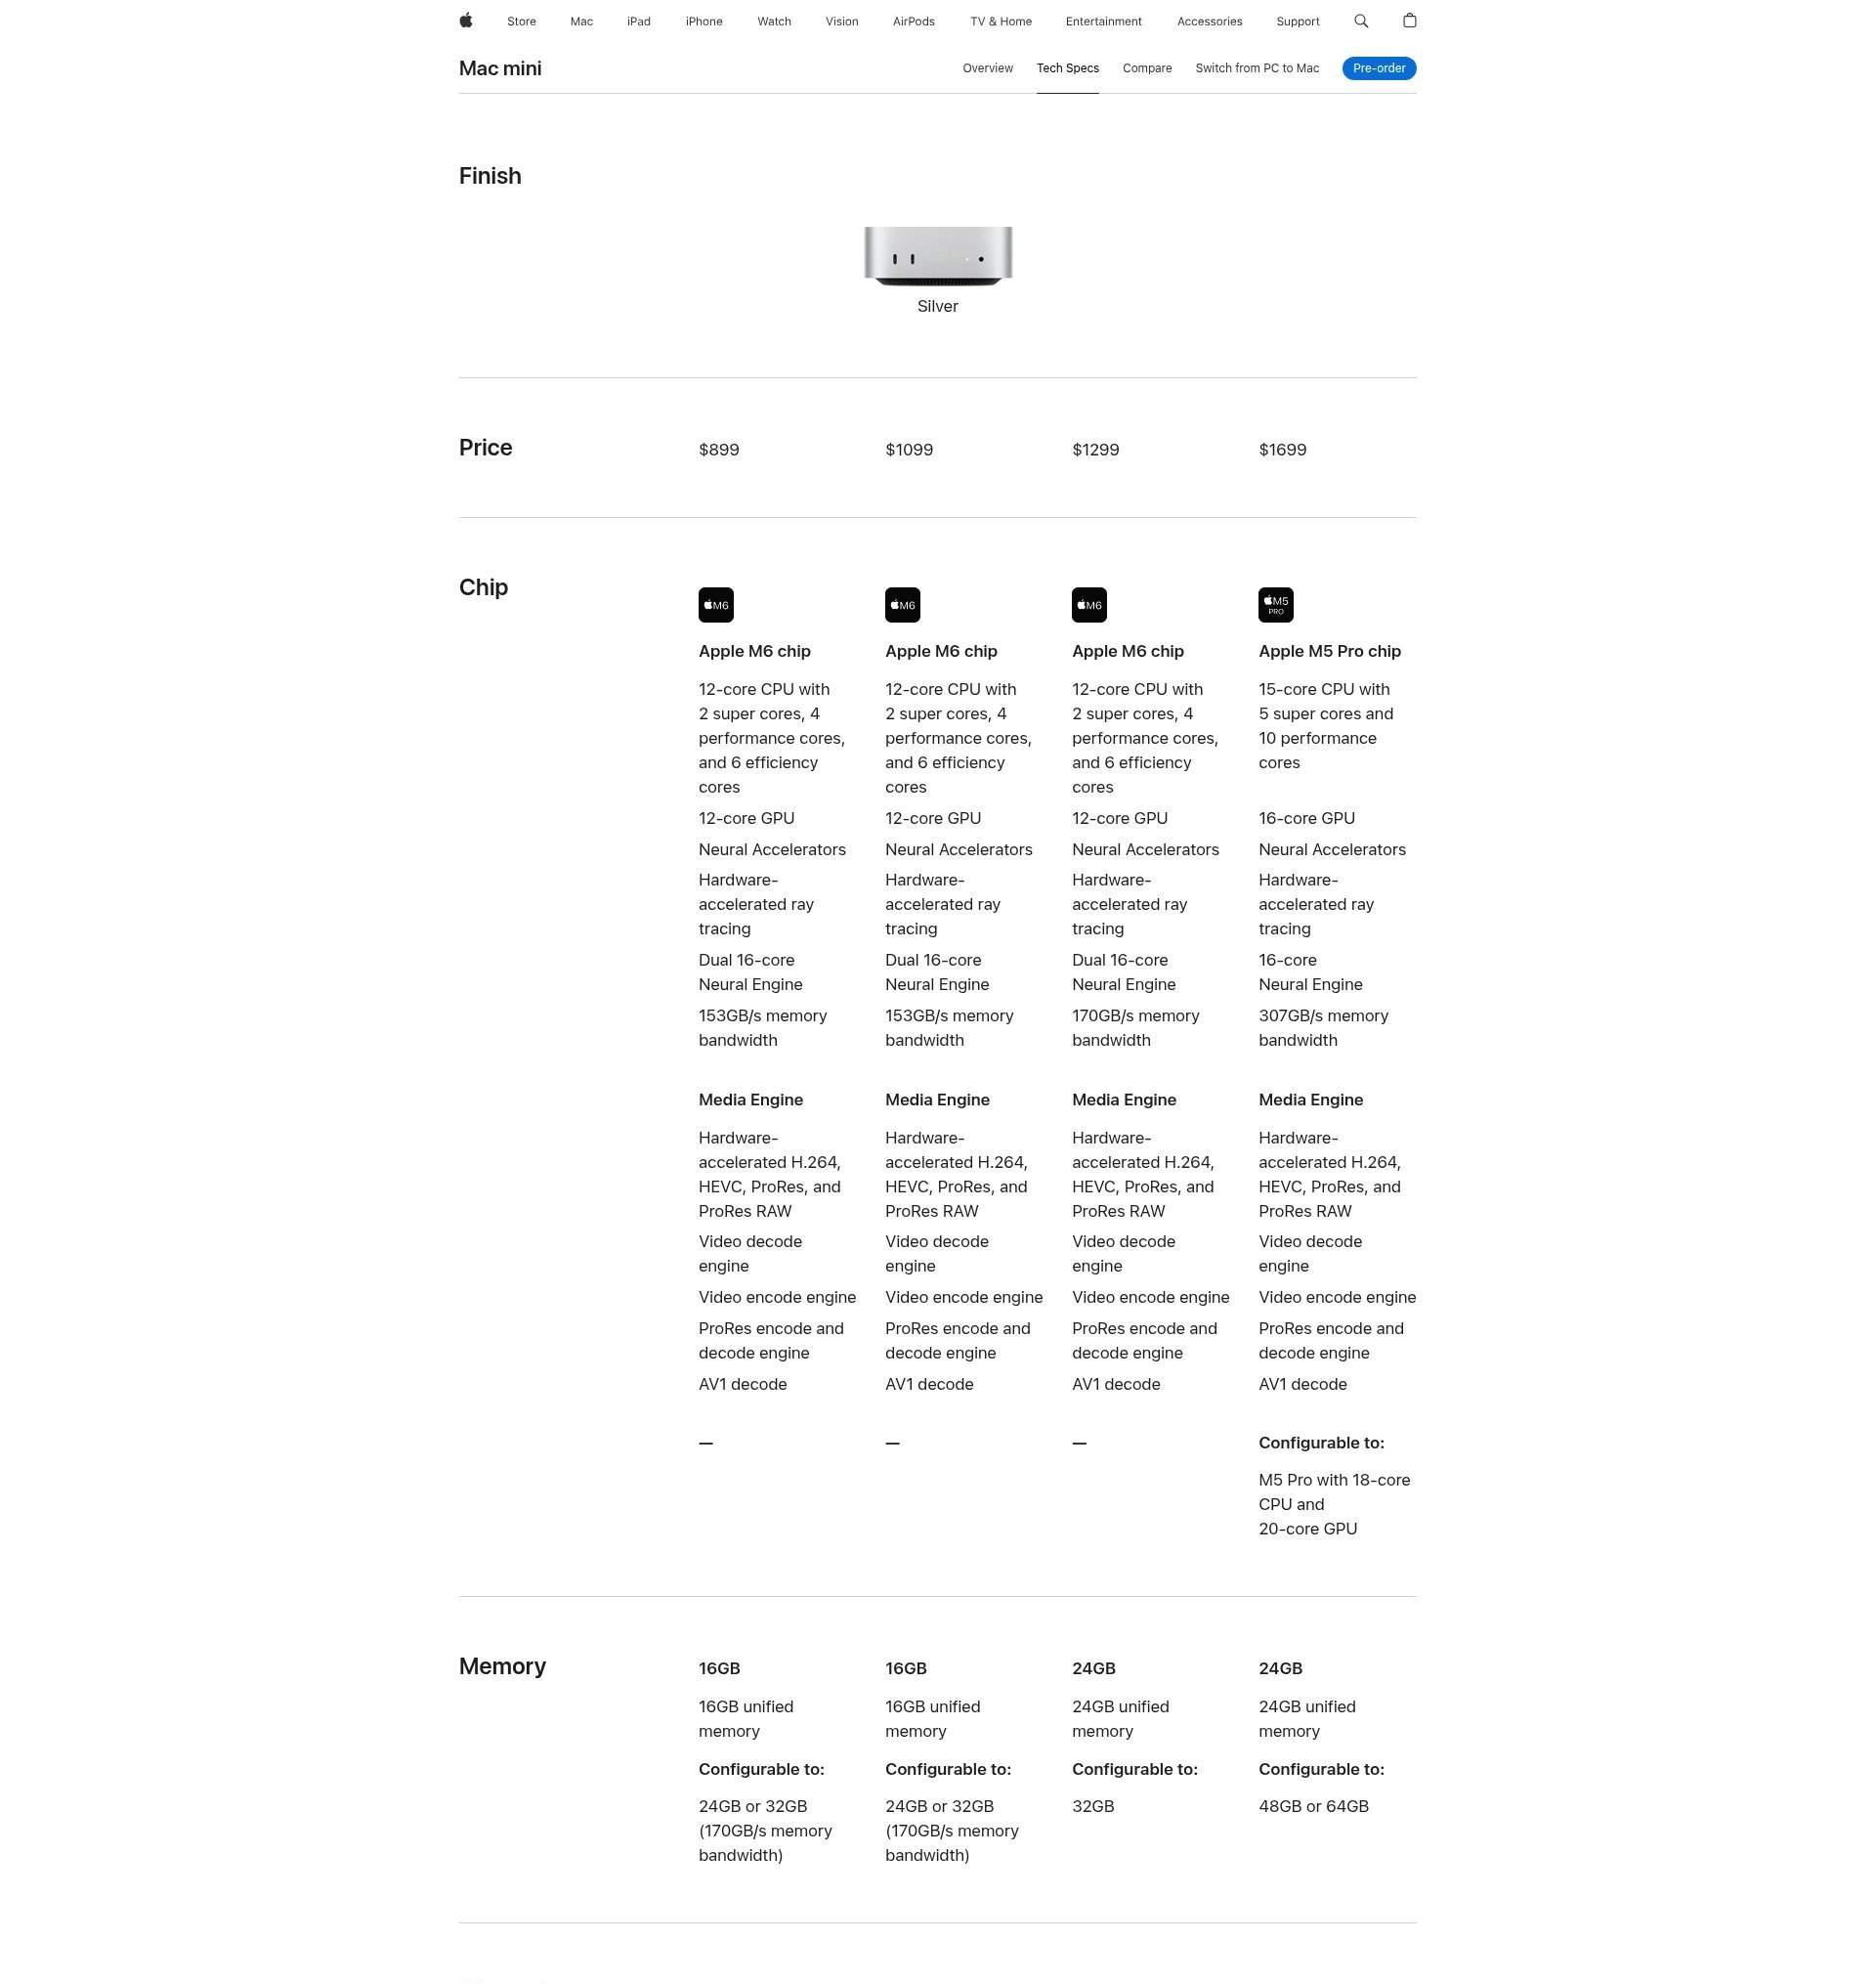
Mac mini — la page officielle des spécifications techniques d’Apple pour les configurations M6 et M5 Pro du Mac mini.
Le cadrage honnête n’est donc pas qu’Apple bat Nvidia, ni l’inverse. C’est que la capacité mémoire et le débit de calcul brut sont deux goulots d’étranglement différents, et que ces machines sont optimisées pour des côtés différents de cet arbitrage. Un réservoir de mémoire partagée plus grand permet de charger un modèle plus gros, tout simplement. Un GPU dédié, avec moins de mémoire totale mais un écosystème logiciel mature et largement soutenu, fait souvent tourner ce modèle plus vite une fois chargé, à condition qu’il rentre dedans.
À qui ça sert vraiment
Rien de tout cela n’appelle un verdict tranché, parce que la bonne machine dépend entièrement de ce que chacun veut réellement faire en local.
Si l’objectif est de faire tourner un grand modèle de langage open weight (un modèle dont le fabricant publie les poids, gratuitement, pour qu’on le fasse tourner soi-même) sur son propre matériel — pour la confidentialité, pour l’usage hors ligne, ou simplement pour éviter un abonnement — et que ce modèle est assez volumineux pour que la mémoire d’un GPU grand public devienne le facteur limitant, alors le plafond de mémoire unifiée du Mac Studio M5 Ultra (jusqu’à 512 Go une fois ce palier livré fin octobre) constitue un avantage réel qu’une configuration GPU à prix comparable ne peut pas égaler en pure capacité. Le guide de DecodeStack pour choisir un modèle open weight est un bon point de départ pour bien calibrer ce choix, puisque c’est la taille du modèle, pas la marque, qui détermine le besoin en mémoire.
Si le travail consiste plutôt à entraîner des modèles depuis zéro, faire du fine-tuning lourd, ou utiliser des outils déjà bâtis autour de CUDA, l’écosystème Nvidia reste le choix le plus mature et le mieux soutenu, et basculer vers Apple Silicon reviendrait à se battre contre le logiciel plutôt que contre le matériel.
Pour la majorité des gens qui hésitent entre le Mac mini M6 d’entrée de gamme et le Mac Studio M5 Max intermédiaire, tout ce marketing autour du calcul IA est largement hors sujet. Ce sont de solides machines de bureau généralistes, dont les progrès du Neural Engine aident surtout les tâches du quotidien — traitement photo, transcription vocale, fonctions embarquées dans macOS — pas les grands modèles de langage en local. Les multiplicateurs IA qu’Apple met en avant concernent avant tout le haut de gamme M5 Ultra, là où la marge de mémoire disponible devient réellement significative.

FAQ
Quelle est la différence entre la puce Apple M6 et la M5 Ultra ?
La M6 est une puce unique, gravée sur un nouveau procédé plus fin, et équipe le Mac mini d’entrée de gamme. La M5 Ultra, elle, est composée de quatre puces distinctes soudées ensemble pour former un processeur plus large, réservé au Mac Studio haut de gamme. Elles équipent des machines différentes, à des tranches de prix très différentes, et ne doivent jamais être traitées comme deux versions d’un même produit.
Le nouveau Mac Studio peut-il remplacer un GPU Nvidia dédié pour l’IA ?
Ça dépend de la tâche. La mémoire unifiée du Mac Studio lui permet de charger des modèles d’IA trop volumineux pour la mémoire dédiée d’une seule carte graphique, ce qui est un avantage réel pour faire tourner de gros modèles en local. Pour l’entraînement de modèles ou les travaux liés aux outils logiciels CUDA de Nvidia, une configuration GPU dédiée reste généralement le choix le plus solide et le mieux soutenu.
La mémoire unifiée, c’est la même chose que la VRAM ?
Non. La mémoire unifiée est un réservoir unique partagé par le CPU, le GPU et le Neural Engine ensemble, commun à toutes les puces Apple Silicon. La VRAM est une mémoire réservée exclusivement à une carte graphique, invisible pour le reste de l’ordinateur. La mémoire unifiée échange un peu de vitesse graphique brute contre la capacité à charger des tâches bien plus grandes sans se heurter à un plafond fixe.
Quand peut-on réellement acheter le nouveau Mac mini ou le Mac Studio ?
La disponibilité générale de la nouvelle gamme Mac mini M6 et Mac Studio M5 Ultra d’Apple est fixée au 22 septembre 2026, après une annonce le 25 août 2026. La configuration du Mac Studio la plus riche en mémoire, avec 512 Go de mémoire unifiée, n’est livrée que fin octobre, plusieurs semaines après le reste de la gamme.
Les chiffres de performance IA d’Apple sont-ils vérifiés de façon indépendante ?
Non. Des chiffres comme les presque 30 % de calcul GPU en plus pour le M6, ou le jusqu’à 4,3 fois pour la M5 Ultra, viennent directement des documents marketing d’Apple, qui compare ses nouvelles puces à ses propres puces précédentes. Ils n’ont pas été confirmés par des tests indépendants et doivent se lire comme des revendications de l’entreprise, pas comme des résultats établis et vérifiés par un tiers.
Ce qu’il faut retenir
Les multiplicateurs précis qu’Apple annonce cette semaine paraîtront datés dans un an ou deux, comme tous les chiffres de génération de puce finissent par l’être. Ce qui ne changera pas aussi vite, c’est l’arbitrage de fond que ce lancement rend explicite : un réservoir de mémoire partagée qui fait sauter un plafond dur sur la taille des modèles, au prix d’un peu de débit brut et de maturité logicielle qu’un GPU Nvidia dédié continue d’offrir. Cet arbitrage, plus que le nom de cette puce précise, est ce qu’il vaut la peine de retenir la prochaine fois qu’une nouvelle machine d’IA locale sera annoncée avec un gros multiplicateur accroché au communiqué.