Apple M6 und M5 Ultra: Warum der neue Mac auf lokale KI zielt
Apple bewirbt Mac mini und Mac Studio erstmals mit KI-Rechenleistung statt nur Tempo. Was M6 und M5 Ultra wirklich ändern – und für wen.
Apple M6 und M5 Ultra: Warum der neue Mac auf lokale KI zielt
Apple hat neue Versionen von Mac mini und Mac Studio vorgestellt. Diesmal geht es in der Werbung kaum noch darum, wie schnell ein Videoexport läuft. Die zentrale Frage lautet: Wie groß darf ein KI-Modell sein, das komplett auf dem eigenen Schreibtisch läuft, ohne dass eine einzige Anfrage in die Cloud geht? Die neuen Chips heißen M6 und M5 Ultra, bleiben aber Apple Silicon, laufen weiter unter macOS und sehen aus wie die Mac-Rechner der letzten Jahre. Verändert hat sich das Verkaufsargument. Und genau diese Verschiebung sagt etwas Dauerhaftes darüber aus, wohin sich Desktop-Computer entwickeln.
Was Apple konkret angekündigt hat
Der neue Mac mini kommt mit dem M6-Chip, dem ersten Apple-Prozessor im 2-Nanometer-Verfahren – ein Maß dafür, wie klein die Transistoren sind. Kleiner heißt in der Regel: mehr Rechenleistung auf gleicher Fläche, bei niedrigerem Stromverbrauch. Die Basisversion des M6 kombiniert eine 12-Kern-CPU mit einer 12-Kern-GPU, in der jeder Kern einen eigenen Neural Accelerator besitzt, dazu eine 16-Kern Neural Engine in doppelter Ausführung – ein separater Chipblock, der gezielt für KI-Aufgaben gebaut ist statt für allgemeine Rechenlast. Dieser Einstiegs-Mac-mini startet mit 16 GB gemeinsamem Speicher, lässt sich bis 32 GB konfigurieren, der Speicherplatz reicht von 256 GB bis 2 TB.
Eine zweite, teurere Mac-mini-Variante nutzt stattdessen den M5 Pro, von 15 CPU-Kernen und 16 GPU-Kernen bis zu 18 CPU-Kernen und 20 GPU-Kernen, mit 24 bis 64 GB Speicher. Das ist ein grundlegend anderer Chip in einer anderen Preisklasse als der Basis-M6 – und beide werden in flüchtiger Berichterstattung ständig vermischt. Steht in einer Überschrift nur „Mac mini” ohne Chip-Namen, kann damit jedes der beiden Geräte gemeint sein.
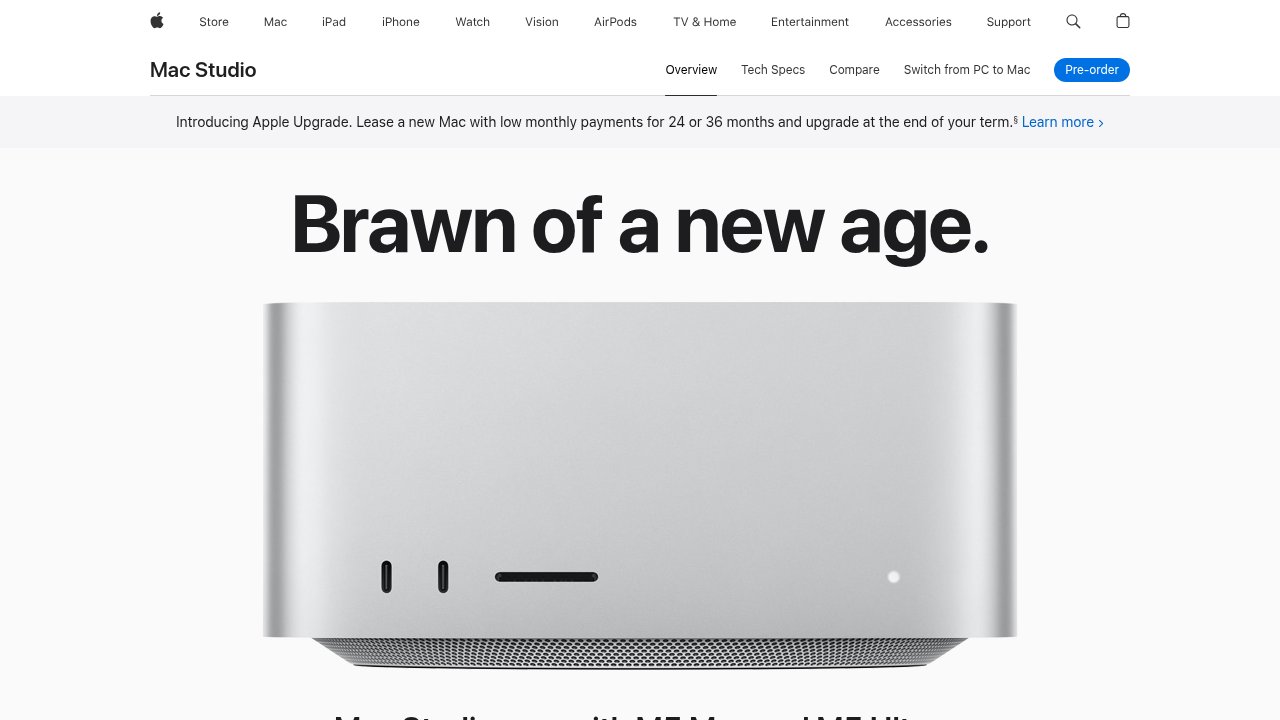
An der Spitze steht der Mac Studio, in zwei Varianten. Die mittlere Stufe nutzt einen M5 Max (18-Kern-CPU, bis zu 40-Kern-GPU, bis zu 128 GB Speicher). Das Topmodell trägt den M5 Ultra – für Apple technisch eine echte Neuheit: Er entsteht, indem vier separate Chip-Dies über UltraFusion verschmolzen werden, Apples Verbindungstechnik, die mehrere Chips zu einem einzigen Prozessor zusammenschaltet, der sich wie ein einziger Chip verhält. Zwei-Die-Ultra-Chips gab es bei Apple schon; vier Dies in einem Chip sind neu. Der M5 Ultra beginnt bei einer 30-Kern-CPU und 64-Kern-GPU mit 96 GB Speicher und geht bis zu 36 CPU-Kernen und 80 GPU-Kernen hoch.
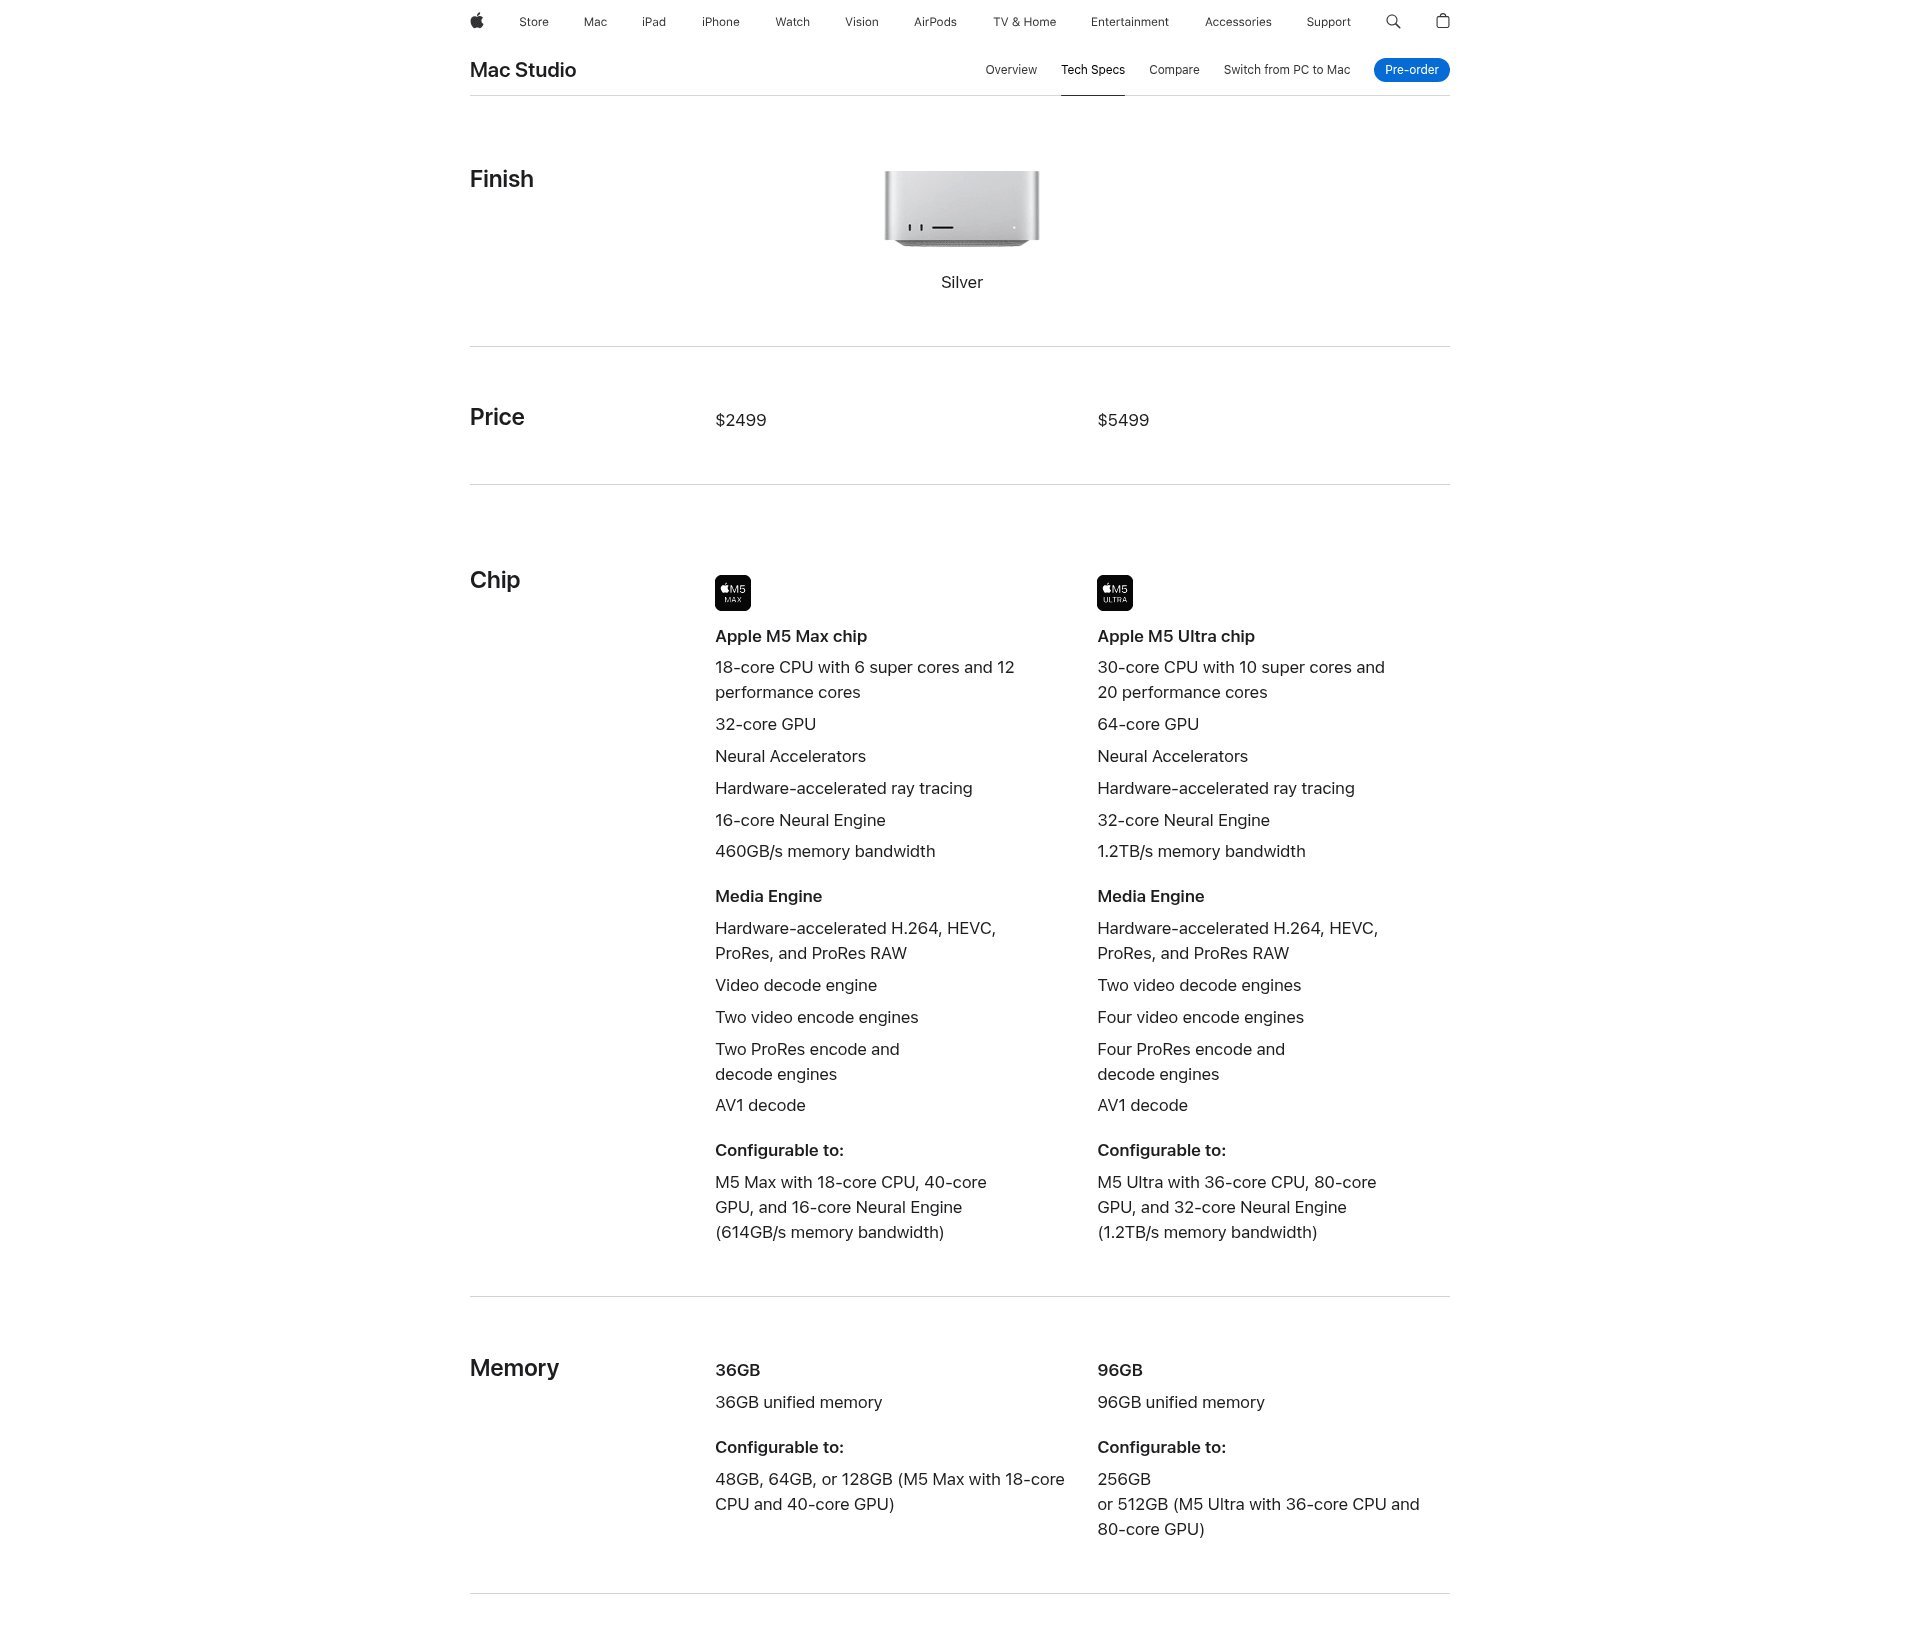
Mac Studio – Apples offizielle Techdaten-Seite zu den M5-Max- und M5-Ultra-Konfigurationen.
Eine Feinheit lohnt einen zweiten Blick: Selbst das Topmodell ist zum Marktstart nicht komplett verfügbar. Die 512-GB-Speicherstufe des M5-Ultra-Mac-Studio kommt erst Ende Oktober, Wochen nach dem regulären Verkaufsstart. Apple hat Vorbestellungen rund um die Ankündigung geöffnet, doch die allgemeine Verfügbarkeit der gesamten Reihe liegt erst am 22. September 2026. Keines dieser Geräte steht bislang im Regal, und die Version mit dem meisten Speicher folgt erst zwei Monate später. Verbindliche Preise hat Apple zum Zeitpunkt dieses Artikels auf offiziell einsehbaren Seiten noch nicht veröffentlicht – jede in frühen Berichten kursierende Euro- oder Dollarzahl ist eine Presseschätzung, kein bestätigter Apple-Preis, solange die Bestellseiten nicht live sind.
Warum Apple das als KI-Rechner verkauft, nicht nur als schnelleren Mac
Apples eigene Werbesprache für diesen Launch setzt stark auf KI-spezifische Vergleiche statt auf die allgemeinen Leistungsversprechen der vergangenen Jahre. Für den M6 gibt Apple an, dass die GPU rund 30 Prozent mehr Spitzen-Rechenleistung für KI liefert – verglichen mit dem M5, also der direkten Vorgängergeneration derselben Chipfamilie. Das ist ausdrücklich eine Aussage zur GPU-Rechenleistung für KI-Aufgaben, kein allgemeiner Leistungswert, und sie vergleicht den M6 nur mit seinem eigenen Vorgänger, nicht mit Konkurrenzhardware.
Getrennt davon wirbt Apple beim Mac mini zusätzlich mit bis zu viermal schnellerer KI-Leistung des neuen M6-Mac-mini – gemessen gegen das auslaufende, auf dem M4 basierende Modell. Hier lohnt Genauigkeit: Diese Zahl stammt von Apple, gemessen an Apples eigener Vorgängergeneration, nicht von einem unabhängigen Labor oder Test. Sie ist eine Marketingaussage, kein feststehender Fakt.
Der M5 Ultra bekommt einen eigenen Multiplikator, mit einem völlig anderen Vergleichspunkt. Apple gibt an, der M5 Ultra liefere bis zu 4,3-mal so viel KI-Spitzenleistung – im Vergleich zum M3 Ultra, also zur Chipfamilie von vor zwei Generationen, nicht zum aktuellen M5 Max eine Stufe darunter. Diese beiden Vergleichsbasen zu verwechseln, passiert beim schnellen Überfliegen einer Pressemitteilung leicht – und genau das führt zu falschen Schlagzeilen.
Bei der Speicherbandbreite nennt Apple zwei tatsächlich unterschiedliche Werte, die ebenfalls oft durcheinandergeraten. Der M6 im Mac mini bietet bis zu 170 GB/s an gemeinsamer Speicherbandbreite – ein Maß dafür, wie schnell der Chip auf seinen gemeinsamen Speicherpool zugreifen kann. Der M5 Ultra, ein völlig anderer Chip in einer völlig anderen Geräteklasse, hat eine Zwischen-Die-Bandbreite von über 4,4 TB/s, die seine vier verschmolzenen Dies miteinander verbindet, sowie eine separate Speicherbandbreite von 1,2 TB/s, laut Apple 50 Prozent mehr als beim M3 Ultra. Das sind drei unabhängige Zahlen zu drei unterschiedlichen Dingen in zwei unterschiedlichen Chips. Keine dieser Zahlen ist unabhängig geprüft – es sind Apples eigene Angaben zu Apples eigener Hardware.
Unified Memory versus VRAM: kein direkter Vergleich
Bevor man das mit Nvidias Hardware für lokale KI vergleicht, lohnt ein Blick auf DecodeStacks früheren Artikel zum Betrieb von KI-Modellen auf dedizierter GPU-Hardware, der den Kompromiss erklärt, um den sich diese ganze Geräteklasse dreht.
Jeder Apple-Silicon-Chip, vom kleinsten MacBook Air bis zum M5 Ultra, nutzt Unified Memory: einen einzigen Speicherpool, den sich CPU, GPU und Neural Engine teilen, statt separater Speicherbereiche für jede Komponente. Bei einer klassischen Gaming- oder Workstation-Grafikkarte hat die GPU dagegen ihren eigenen, fest auf die Karte gelöteten Speicher, meist VRAM genannt, unsichtbar für den Rest des Systems. Braucht eine Aufgabe mehr Speicher, als die Karte besitzt, läuft die Aufgabe auf dieser GPU schlicht nicht – egal, wie viel regulärer Arbeitsspeicher sonst im Rechner steckt.
Genau dieser Unterschied macht Apple Silicon konkurrenzfähig für große lokale KI-Modelle – und zwar wegen der Speicherkapazität, nicht wegen roher Geschwindigkeit. Ein Sprachmodell, das etwa 90 GB Speicher allein zum Laden braucht, passt in eine entsprechend konfigurierte M5-Ultra-Maschine, weil der gesamte Pool für die Aufgabe zur Verfügung steht. Dasselbe Modell wäre für eine Grafikkarte, deren VRAM deutlich darunterliegt, schlicht unerreichbar – es sei denn, man teilt es auf, lagert Teile in den langsameren Systemspeicher aus oder geht anderweitig Kompromisse ein.
Das ist der faire Vergleichspunkt zu Nvidias DGX Spark, den DecodeStack bereits im Vergleich mit dem ASUS Ascent GX10 eingeordnet hat, einem Konkurrenzgerät auf demselben Nvidia-Chip. Auch Nvidias kleine KI-Desktopsysteme nutzen eine Form von gemeinsamem, direkt auf dem Package sitzendem Speicher statt eines separaten VRAM-Pools – genau deshalb existiert diese Geräteklasse überhaupt: damit einzelne Entwickler und kleine Teams Modelle betreiben können, für die sonst ein ganzes Rack an Rechenzentrums-GPUs nötig wäre. Doch ein gemeinsamer Speicherpool ist nicht automatisch die schnellere oder bessere Option – es ist ein anderer Kompromiss. Nvidias Ökosystem rund um die CUDA-Softwareplattform (das Toolkit, für das der Großteil des KI-Forschungs- und Trainingscodes geschrieben wird) bleibt der Standard für alles, was ernsthaftes Modelltraining oder maximalen rohen Durchsatz verlangt. Eine dedizierte GPU wie die RTX 5090 schlägt einen Unified-Memory-Mac in der Regel bei Aufgaben, die bequem in ihren VRAM passen, weil zweckgebundene Speicherbandbreite pro Kern echte Vorteile hat, sobald Kapazität nicht der limitierende Faktor ist.
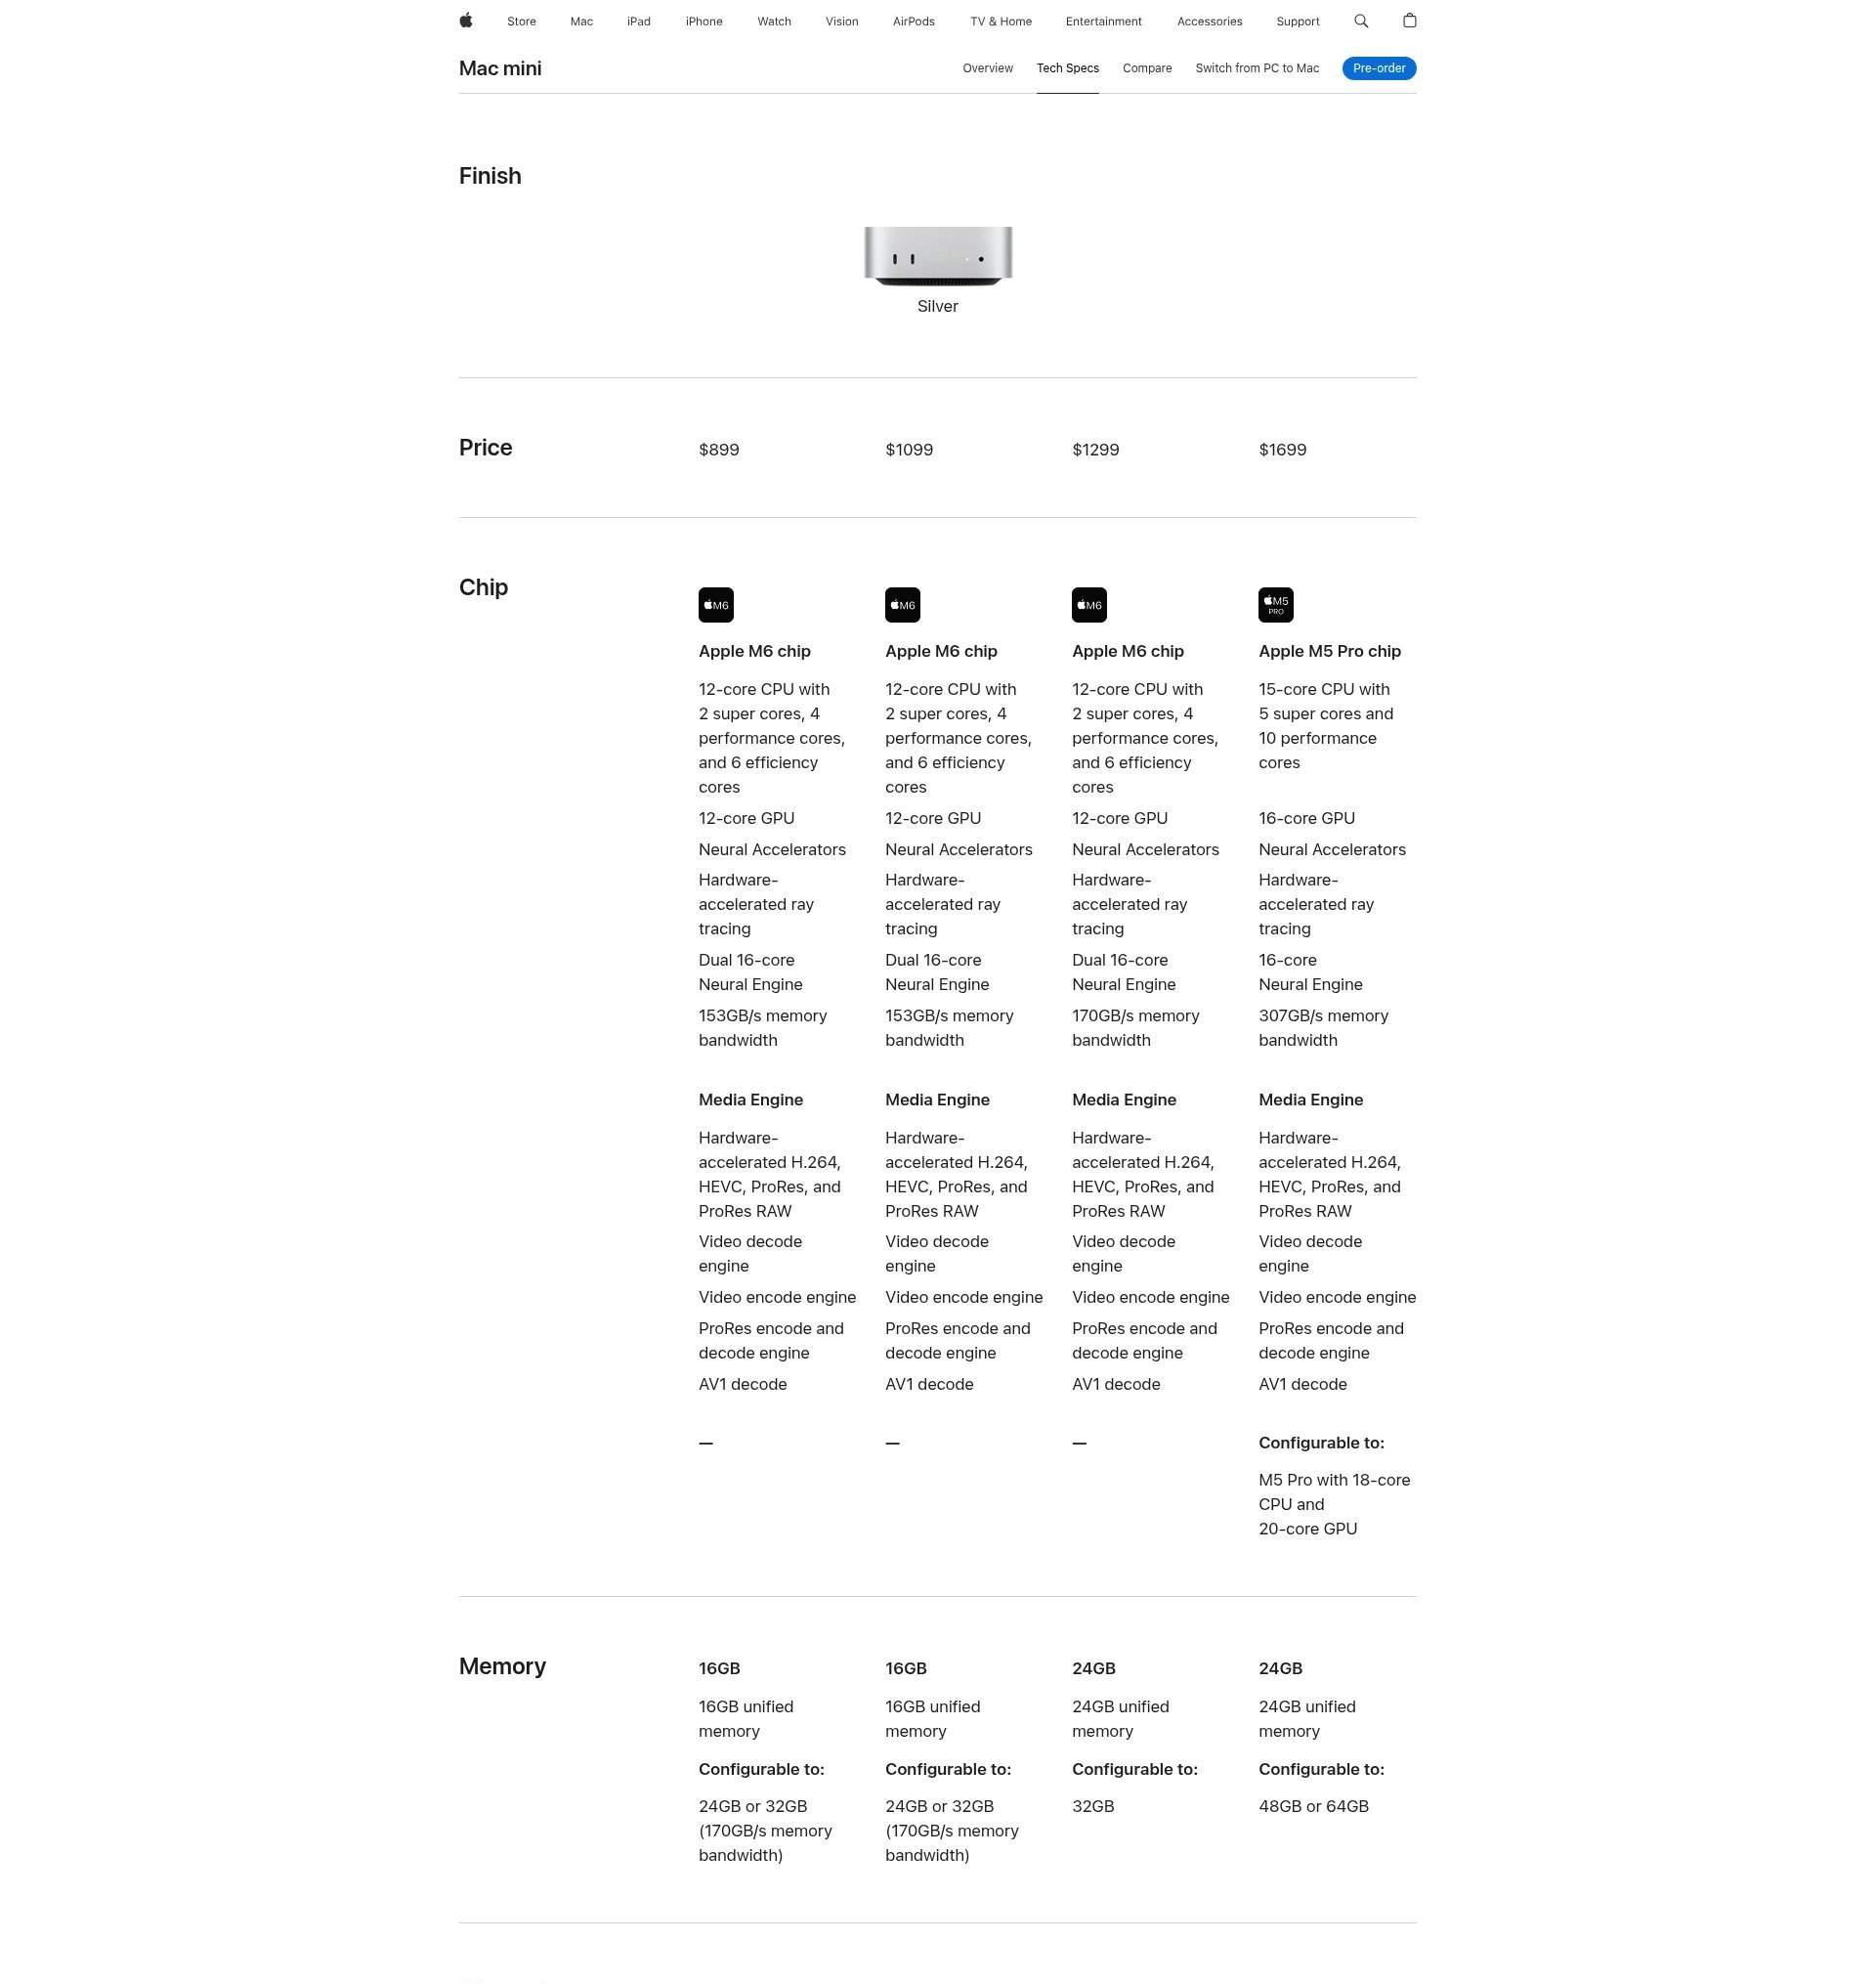
Mac mini – Apples offizielle Techdaten-Seite zu den M6- und M5-Pro-Konfigurationen.
Die ehrliche Einordnung lautet also nicht, dass Apple Nvidia schlägt oder umgekehrt. Sie lautet: Speicherkapazität und rohe Rechenleistung sind zwei unterschiedliche Engpässe, und diese Geräte sind für unterschiedliche Seiten dieses Kompromisses optimiert. Ein größerer gemeinsamer Speicherpool bedeutet, dass ein größeres Modell überhaupt erst geladen werden kann. Eine dedizierte GPU mit weniger Gesamtspeicher, aber einem ausgereiften, breit unterstützten Software-Ökosystem, lässt dasselbe Modell nach dem Laden oft schneller laufen – vorausgesetzt, es passt hinein.
Für wen sich das wirklich lohnt
Ein pauschales Urteil verbietet sich, weil die richtige Maschine ganz davon abhängt, was jemand lokal tatsächlich vorhat.
Wer ein großes Open-Weight-Sprachmodell auf eigener Hardware betreiben will – aus Datenschutzgründen, für den Offline-Einsatz oder einfach um ein Abo zu vermeiden – und das Modell groß genug ist, dass der Speicher üblicher Consumer-GPUs zum limitierenden Faktor wird, dem bietet die Speicherobergrenze des M5-Ultra-Mac-Studio (bis zu 512 GB, sobald diese Stufe Ende Oktober ausgeliefert wird) einen echten Vorteil, den ein vergleichbar teures GPU-Setup allein bei der Kapazität nicht erreicht. DecodeStacks Leitfaden zur Wahl eines Open-Weight-Modells hilft, diese Entscheidung richtig zu dimensionieren, denn die Modellgröße bestimmt den Speicherbedarf – nicht die Marke.
Geht es dagegen um Training von Modellen von Grund auf, intensives Fine-Tuning oder Workloads, die bereits fest an CUDA-spezifische Werkzeuge gebunden sind, bleibt das Nvidia-Ökosystem die ausgereiftere, besser unterstützte Wahl. Ein Wechsel zu Apple Silicon würde hier bedeuten, gegen die Software statt gegen die Hardware anzukämpfen.
Für die meisten, die zwischen dem Einstiegs-M6-Mac-mini und dem mittleren M5-Max-Mac-Studio schwanken, ist die KI-Werbung ohnehin ziemlich nebensächlich. Das sind solide Desktop-Rechner für den Alltag, deren verbesserte Neural Engine vor allem alltäglichen Aufgaben zugutekommt – Fotobearbeitung, Sprachtranskription, in macOS eingebaute On-Device-Funktionen – nicht großen lokalen Sprachmodellen. Die KI-Multiplikatoren, mit denen Apple wirbt, gelten in erster Linie für das Topmodell M5 Ultra, wo der Speicherspielraum tatsächlich groß genug ist, um etwas zu bewirken.

FAQ
Was unterscheidet den Apple M6 vom M5 Ultra?
Der M6 ist ein einzelner Chip, gefertigt in einem neuen, kleineren Herstellungsverfahren, und steckt im Einstiegs-Mac-mini. Der M5 Ultra besteht aus vier separaten Chip-Dies, die zu einem größeren Prozessor verschmolzen werden, gedacht für den High-End-Mac-Studio. Beide bedienen unterschiedliche Geräte in sehr unterschiedlichen Preisklassen und sollten nie als Versionen derselben Produktstufe behandelt werden.
Kann der neue Mac Studio eine dedizierte Nvidia-GPU für KI-Arbeit ersetzen?
Das hängt von der Aufgabe ab. Der Unified Memory des Mac Studio erlaubt das Laden von KI-Modellen, die zu groß für den dedizierten Speicher einer einzelnen Grafikkarte sind – ein echter Vorteil, um große Modelle lokal auszuführen. Für das Training von Modellen oder Arbeit, die an Nvidias CUDA-Werkzeuge gebunden ist, bleibt ein dediziertes GPU-Setup in der Regel die stärkere, besser unterstützte Option.
Ist Unified Memory dasselbe wie VRAM?
Nein. Unified Memory ist ein gemeinsamer Speicherpool, den sich CPU, GPU und Neural Engine teilen, üblich bei allen Apple-Silicon-Chips. VRAM ist Speicher, der ausschließlich einer Grafikkarte vorbehalten und für den Rest des Rechners unsichtbar ist. Unified Memory tauscht etwas rohe Grafikleistung gegen die Fähigkeit ein, deutlich größere Aufgaben zu laden, ohne an eine feste Speichergrenze zu stoßen.
Wann kann ich den neuen Mac mini oder Mac Studio kaufen?
Die allgemeine Verfügbarkeit der neuen Apple-M6-Mac-mini- und M5-Ultra-Mac-Studio-Reihe liegt beim 22. September 2026, nach einer Ankündigung am 25. August 2026. Die speicherstärkste Mac-Studio-Konfiguration mit 512 GB Unified Memory kommt erst Ende Oktober, mehrere Wochen nach dem Rest der Reihe.
Sind Apples KI-Leistungsangaben unabhängig geprüft?
Nein. Zahlen wie die rund 30 Prozent mehr GPU-Rechenleistung beim M6 oder der bis zu 4,3-fache Wert beim M5 Ultra stammen direkt aus Apples eigenem Marketingmaterial und vergleichen die neuen Chips mit Apples eigenen älteren Chips. Sie sind nicht durch unabhängige Benchmark-Tests bestätigt und sollten als Herstellerangaben gelesen werden, nicht als feststehende, extern verifizierte Ergebnisse.
Die Quintessenz
Die konkreten Multiplikatoren, die Apple diese Woche nennt, werden in ein, zwei Jahren veraltet wirken – so wie jede Chip-Generationszahl irgendwann. Was sich nicht so schnell ändert, ist der zugrunde liegende Kompromiss, den dieser Launch offenlegt: ein gemeinsamer Speicherpool, der eine harte Obergrenze für Modellgröße aufhebt, auf Kosten des rohen Durchsatzes und der Softwarereife, die eine dedizierte Nvidia-GPU weiterhin bietet. Dieser Kompromiss, nicht der konkrete Chip-Name, ist es, was man sich merken sollte, wenn beim nächsten lokalen KI-Rechner wieder ein großer Multiplikator in der Ankündigung steht.