Le Shadow AI expliqué : l'usage d'IA non autorisé qui aspire les données de l'entreprise
Le Shadow AI, c'est l'IA non sanctionnée en entreprise. Comment les données fuient vraiment, ce que ça coûte, et pourquoi la gouvernance bat l'interdiction.
En mars 2023, trois incidents distincts en vingt jours voient des ingénieurs de la division semi-conducteurs de Samsung coller du code source propriétaire, un compte-rendu de réunion interne et des données de test de puces dans ChatGPT. Samsung interdit les chatbots dans toute l’entreprise dès le mois de mai, avant de se mettre à construire son propre outil IA interne pour ses salariés. Cet incident est devenu le cas de référence d’un problème qui a désormais un nom : le Shadow AI, l’usage d’outils IA par des salariés sans que les équipes informatiques ou sécurité en aient connaissance ou donné leur accord. Le rapport IBM Cost of a Data Breach 2025 chiffre ce que ce problème coûte aujourd’hui : une organisation sur cinq a déjà subi une brèche liée à de l’IA non sanctionnée, et chacune coûte 670 000 dollars de plus qu’une brèche classique.
Ce qu’est vraiment le Shadow AI
Le Shadow AI prolonge un problème connu, le Shadow IT, l’usage de technologies hors du cadre approuvé, mais le risque sous-jacent est structurellement différent. Un fichier posé sur le Dropbox personnel de quelqu’un est exposé si ce service se fait pirater. Le même fichier collé dans un chatbot public est exposé à tout autre chose : un modèle capable de le traiter, d’en garder des traces, d’apprendre dessus lors d’un réentraînement, et parfois de le restituer à un autre utilisateur dans une autre session, le tout régi par une politique de conservation fixée par un fournisseur qui ne respecte peut-être ni le RGPD ni les règles sectorielles de l’entreprise.
La catégorie dépasse largement les chatbots. Elle couvre les assistants de code utilisés sur des comptes personnels (GitHub Copilot, Amazon CodeWhisperer), les extensions de navigateur dopées à l’IA, les outils de rédaction et de traduction, les modèles open source exécutés localement sur un ordinateur de l’entreprise, et les fonctionnalités IA activées discrètement à l’intérieur de logiciels SaaS que personne à la DSI n’a validées. Tout ce qui traite des données de l’entreprise en dehors d’un périmètre de gouvernance sanctionné entre dans cette case.
Pourquoi ça a explosé aussi vite
L’ampleur n’a rien de marginal. Palo Alto Networks mesure une moyenne de 66 applications GenAI utilisées par organisation, dont 6,6 signalées à haut risque, et les incidents de prévention de fuite de données (DLP) liés à la GenAI ont bondi de 250 %, représentant désormais 14 % de tous les incidents DLP suivis par la firme. Le Netskope Cloud and Threat Report 2026, qui couvre la période d’octobre 2024 à octobre 2025, constate que le nombre d’utilisateurs de SaaS GenAI a triplé et que le volume mensuel de prompts a été multiplié par six, passant de 3 000 à 18 000 par organisation ; le quart le plus actif des organisations en envoie désormais plus de 70 000 par mois.
Trois forces alimentent cette croissance. La pression de la productivité pousse les gens vers l’outil le plus rapide disponible. L’absence d’alternative sanctionnée les pousse encore plus loin : dans une enquête menée dans le secteur de la santé, 27 % des utilisateurs ont déclaré que l’outil non approuvé fonctionnait tout simplement mieux que ce que l’entreprise proposait. Et la gouvernance est largement absente au départ : le rapport IBM 2025 constate que seules 37 % des organisations disposent d’une politique de gouvernance IA, laissant 63 % sans aucun cadre. Les comptes personnels font le reste du travail, avec 47 % des utilisateurs de GenAI qui passent encore par l’un d’eux, contre 78 % l’année précédente, mais ça reste près d’un sur deux.
Une interdiction ne referme pas la faille. Samsung en a tenté une avant de construire une alternative approuvée plutôt que de s’en remettre à l’interdiction seule ; un schéma plus large, documenté par plusieurs enquêtes, montre que près de la moitié des salariés continuent d’utiliser leurs comptes IA personnels même après une interdiction formelle. L’interdiction ne supprime pas le comportement, elle supprime la visibilité dessus.
Ces chiffres d’adoption tiennent la route sur plusieurs enquêtes indépendantes, pas seulement la télémétrie d’un seul fournisseur. Le State of Shadow AI Report 2025 d’UpGuard, basé sur 1 500 répondants répartis entre responsables sécurité et salariés, trouve que 81 % des salariés et 88 % des professionnels de la sécurité utilisent des outils IA que leur employeur n’a jamais approuvés, y compris les personnes payées pour empêcher ça. Le Work Trend Index de Microsoft situe le chiffre à 75 % des salariés utilisant l’IA au travail en 2025 ; un an plus tôt, 78 % des utilisateurs d’IA disaient déjà apporter leurs propres outils plutôt que d’attendre une solution approuvée, un schéma qui se retrouve de la génération Z aux baby-boomers avec seulement de légères variations selon l’âge. Le recoupement entre « connaît le risque » et « utilise l’outil quand même » est la partie inconfortable : les données d’UpGuard montrent que la conscience du risque lié aux données ne réduit quasiment pas l’usage des comptes personnels.
Tous les outils IA ne se valent pas côté risque
OpenAI, Google et Anthropic tracent tous une ligne claire entre leurs produits grand public et leurs offres entreprise. Par défaut, OpenAI n’entraîne pas ses modèles sur les conversations, fichiers ou codes soumis via ChatGPT Enterprise, ChatGPT Team, ChatGPT Business ou son API. La version grand public de ChatGPT entraîne sur les conversations par défaut, et désactiver ça demande un détour manuel dans des réglages de confidentialité que la plupart des gens n’ouvrent jamais. Le Shadow AI, par définition, signifie que les salariés ne sont pas sur l’offre qui bénéficie de cette protection contractuelle. Un ingénieur qui crée un compte ChatGPT personnel pour y coller un extrait de code confie par défaut cet extrait à un pipeline d’entraînement que l’entreprise n’a jamais accepté et n’aurait pas validé.
 Source : openai.com/enterprise-privacy
Le pays d’origine du fournisseur ajoute une seconde couche qui dépasse les conditions d’utilisation. DeepSeek, le laboratoire chinois dont le modèle open weight R1 a déclenché une vague d’adoption début 2025, fait transiter les données de son application de chat par des serveurs soumis au droit chinois. L’autorité italienne de protection des données, le Garante, a ordonné le blocage de DeepSeek sur tout le marché italien en janvier 2025, après que l’entreprise a échoué à expliquer ses pratiques sur les données au regard du RGPD. La Corée du Sud a interdit l’application sur les appareils gouvernementaux et son régulateur de la vie privée a suspendu les nouveaux téléchargements en attendant un contrôle de conformité ; l’Australie et Taïwan ont suivi avec des interdictions pures et simples sur les systèmes gouvernementaux. Aucun de ces gestes n’était symbolique. Ce sont des décisions réglementaires et de sécurité nationale en bonne et due forme, et elles montrent que l’écart de risque entre fournisseurs d’IA n’est plus théorique : le pays d’origine d’un outil et ses conditions de traitement des données par défaut pèsent désormais autant dans le calcul que sa catégorie. Une politique Shadow AI qui traite « outil IA » comme un seul bloc indifférencié rate complètement cette distinction.
Deux façons bien distinctes dont les données fuient vraiment
La première passe par ce que l’utilisateur saisit lui-même. Un salarié colle un document dans un chatbot, envoie un fichier, connecte un outil SaaS à un service IA via une API, ou accorde un jeton OAuth qui donne à un agent IA un accès permanent aux systèmes de l’entreprise. Ce trafic passe par du HTTPS ordinaire, indiscernable au niveau réseau de n’importe quelle autre requête web, ce qui explique pourquoi les outils DLP à base de règles, conçus pour repérer des motifs connus, le ratent le plus souvent : ils n’ont jamais été conçus pour interpréter l’intention à l’intérieur d’une conversation en langage naturel. L’analyse par Harmonic Security de 22,4 millions de prompts d’entreprise a recensé 665 outils GenAI distincts en usage actif, dont seulement 40 % rattachés à un abonnement officiel de l’entreprise ; près de 17 % des expositions de données sensibles qu’elle a détectées, soit près de 98 000 cas, provenaient de comptes personnels gratuits totalement invisibles pour la DSI. Les données les plus souvent impliquées, selon le rapport 2026 de Netskope, sont les données réglementées, personnelles, financières ou de santé, qui représentent à elles seules 54 % des violations de politique GenAI signalées, devant le code source à 15 % et les mots de passe ou clés API à 8 %.
La seconde est structurellement différente : elle tient à la mémorisation à l’intérieur du modèle lui-même. Des chercheurs de l’Université de Hong Kong ont construit 900 prompts à partir de fragments de code GitHub publics et les ont utilisés pour extraire 2 702 identifiants valides de GitHub Copilot et 129 d’Amazon CodeWhisperer, dont au moins 200 étaient de vrais secrets encore traçables sur GitHub. Rien ici ne dépend de ce qu’un salarié a tapé. Un assistant de code entraîné sur des dépôts contenant des secrets codés en dur peut mémoriser ces secrets et les restituer dans une suggestion à un utilisateur totalement différent.
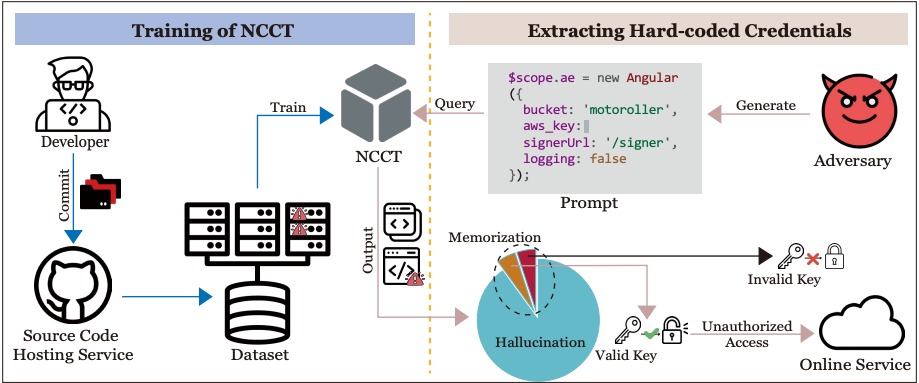 Source : GitGuardian
GitGuardian a recensé plus de 1 200 secrets divulgués sur un échantillon de 20 000 dépôts où Copilot était actif, soit un taux de 6,4 %, 40 % plus élevé que la référence sur l’ensemble des dépôts publics ; les dépôts privés laissaient fuiter des secrets en clair huit fois plus souvent que les dépôts publics.
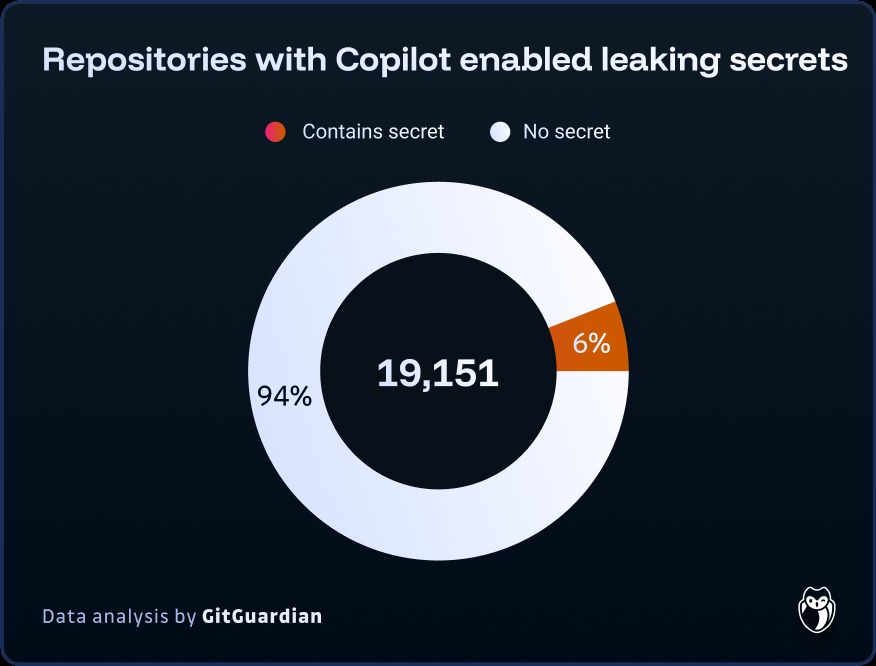 Source : GitGuardian
Un attaquant n’a besoin que de construire des prompts ciblant un type d’identifiant, clés AWS, tokens GitHub, secrets OAuth Google, de filtrer les suggestions par entropie et par motif de validation, et de repartir avec de quoi ouvrir un vrai système.
Ce que le Shadow AI coûte vraiment
Les chiffres financiers convergent d’une source à l’autre. Le rapport IBM 2025, bâti sur 600 organisations réparties dans 17 secteurs et 16 pays, situe la brèche moyenne à 4,63 millions de dollars pour les organisations fortement exposées au Shadow AI, contre 3,96 millions pour celles peu ou pas exposées, soit un écart de 670 000 dollars. Vingt pour cent des organisations de l’étude avaient déjà été touchées, 63 % n’avaient aucune gouvernance IA, et parmi celles ayant subi un incident lié à l’IA, 97 % ne disposaient pas de contrôles d’accès IA adéquats.
Les dégâts ne s’arrêtent pas à la facture. Quatre-vingt-six pour cent des organisations touchées dans l’étude IBM ont signalé une perturbation opérationnelle : traitement des commandes, service client, chaînes de production. Les incidents Shadow AI avaient, plus que les autres types d’incidents IA, tendance à disperser les données sensibles sur plusieurs environnements à la fois, élargissant le rayon d’impact d’un seul outil non surveillé. La détection prend en moyenne 247 jours, soit environ une semaine de plus que la moyenne globale du rapport, un délai qui laisse à un intrus, ou simplement à un tiers curieux, une longue marge avant d’être repéré.
Le rapport 2026 du Ponemon Institute sur le coût des risques internes, mené avec DTEX, situe le coût annuel du risque interne à 19,5 millions de dollars par organisation, dont 53 %, soit 10,3 millions, imputables à des acteurs non malveillants : le plus souvent des salariés dont le seul tort a été de choisir l’outil le plus rapide. Pour un responsable sécurité qui construit un dossier budgétaire, le calcul est direct : un programme de gouvernance coûtant moins de 670 000 dollars par an se rembourse dès qu’il évite une seule brèche.
L’exposition qui compte le plus : ce qui fuit finit par être volé deux fois
Les catégories de données qui fuient le plus souvent via le Shadow AI, code source, propriété intellectuelle, fichiers clients, données réglementées, sont exactement celles qui ont la plus forte valeur de revente et d’extorsion une fois sorties de l’entreprise. Le rapport IBM 2025 chiffre directement ce recoupement : les brèches impliquant du Shadow AI exposent des données personnelles clients (PII) dans 65 % des cas contre 53 % pour les brèches sans Shadow AI, et de la propriété intellectuelle dans 40 % des cas contre 33 %.
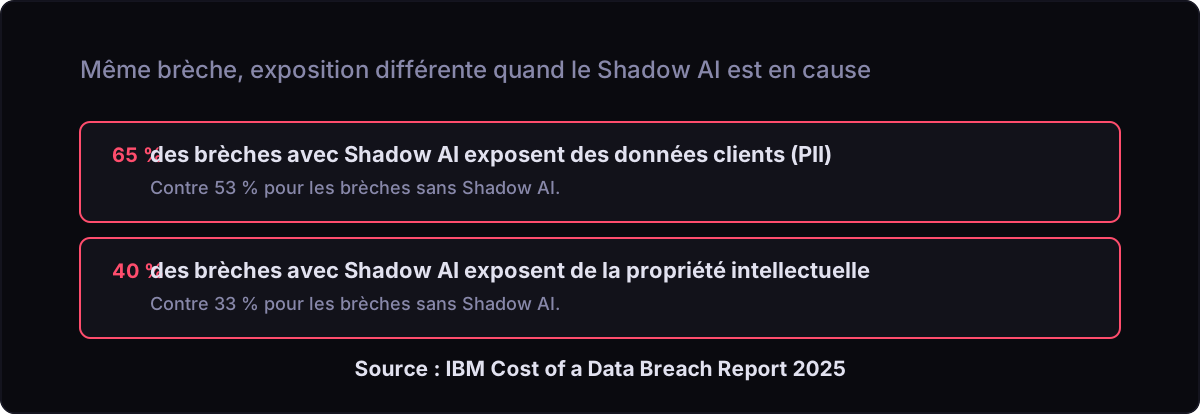
Cet écart n’a rien d’une coïncidence, et il n’a rien de théorique. Les groupes de ransomware qui pratiquent la double extorsion, chiffrer les données tout en menaçant de les publier, traitent tout inventaire de données sensibles exposées comme une ressource à exploiter, quelle que soit la façon dont elles sont sorties de l’entreprise. Une fuite Shadow AI n’a pas besoin d’être ciblée pour devenir utile à un attaquant : un salarié colle une liste de clients dans un chatbot non approuvé sans la moindre intention malveillante, cette donnée se retrouve sur un serveur tiers hors du périmètre de sécurité de l’entreprise, et un attaquant qui compromet ce service, hameçonne directement le salarié, ou achète simplement l’accès à un compte fuité, hérite d’un actif d’extorsion prêt à l’emploi. Le rapport du T3 2025 de Coveware sur l’économie du ransomware a constaté la présence d’exfiltration de données dans 76 % des cas suivis, alors même que la part de victimes qui payent est tombée à 23 %, un basculement qui pousse certains opérateurs de ransomware à recruter directement des complices en interne plutôt qu’à se limiter à l’exploitation de failles techniques ; le rapport cite un affilié du groupe Medusa qui a tenté de soudoyer directement un salarié pour déployer le ransomware de l’intérieur, exactement le profil de personne qu’une faille de politique Shadow AI expose. DecodeStack a détaillé le fonctionnement de ce modèle chiffrement-plus-fuite dans un article consacré à une véritable campagne de ransomware en double extorsion. Les propres prévisions de Gartner, tirées d’une enquête menée auprès de 302 responsables sécurité, projettent que plus de 40 % des entreprises subiront d’ici 2030 une brèche ou un incident de conformité lié au Shadow AI ; 69 % des personnes interrogées soupçonnaient déjà leurs salariés d’utiliser des outils GenAI interdits.
Rien de tout cela ne constitue un cas documenté où des enquêteurs auraient remonté une brèche ransomware précise jusqu’à une fuite Shadow AI précise et nommée. Ce qui existe, c’est un recoupement statistique et mécanique, les mêmes catégories de données, la même absence de visibilité, pas une chaîne de causalité publiquement confirmée qui irait d’un document collé jusqu’à une demande de rançon. L’analyse forensique des brèches commence tout juste à vérifier systématiquement les journaux des outils IA, et cet écart pourrait se combler à mesure qu’elle progresse. En attendant, l’affirmation exacte est que le Shadow AI crée les conditions dont se nourrit la double extorsion, pas qu’une brèche nommée ait été prouvée comme point de départ.
Le ransomware est la version la plus aiguë de cette exposition, pas la seule. Le même code source et les mêmes contrats fuités se retrouvent dans des amendes réglementaires, des pertes d’avantage concurrentiel et de simples dégâts de confiance client, bien avant qu’un groupe d’extorsion n’entre en jeu. Réduire le Shadow AI à un « signe avant-coureur du ransomware » sous-estime son coût du quotidien ; le réduire à « un problème d’hygiène informatique » sous-estime son plafond.
Il vaut la peine de séparer tout cela d’une tendance liée mais différente : les outils IA construits et déployés par les attaquants eux-mêmes, pas par des salariés négligents. ESET a documenté PromptLock, présenté comme le premier ransomware à utiliser de l’IA générative à l’exécution, et a par ailleurs suivi PromptSpy, un malware Android qui fait appel à Gemini de Google à l’exécution pour mener de la surveillance à distance. IBM X-Force a documenté Slopoly, une porte dérobée au code probablement généré par IA, liée aux attaques par ransomware Interlock du groupe Hive0163, et Check Point Research a suivi HexStrike-AI, un framework de test d’intrusion open source légitime que des attaquants ont détourné quelques heures après sa publication pour automatiser l’exploitation de vulnérabilités tout juste révélées. Aucun de ces outils n’est du Shadow AI au sens strict, un salarié n’est pas aux commandes, mais ils montrent que l’IA générative se retrouve désormais aux deux bouts du même problème : l’usage non sanctionné à l’intérieur de l’entreprise crée l’exposition, et l’outillage assisté par IA à l’extérieur de l’entreprise l’exploite de plus en plus.
Le prochain problème : des agents autonomes que personne n’a validés
Le Shadow AI dépasse désormais les simples conversations avec un chatbot pour glisser vers des agents autonomes qui agissent seuls, à la vitesse d’une machine, avec un accès permanent aux systèmes de l’entreprise et aucun humain qui vérifie chaque étape. Une interaction Shadow AI classique, c’est une personne qui colle un document, une fois. Un agent non sanctionné est différent par nature : il détient des identifiants API, enchaîne des actions sur plusieurs services, tourne en continu, et décide sans que personne ne valide chaque action individuelle. La télémétrie 2026 de Netskope montre ce basculement déjà en cours : les deux tiers des organisations se connectent directement à api.openai.com, le motif d’accès typique des workflows automatisés et des agents plutôt que d’un humain qui tape dans un navigateur ; 33 % passent par OpenAI via Azure, 27 % par Amazon Bedrock, 10 % par Google Vertex AI. Le nombre d’utilisateurs de Bedrock et son trafic ont triplé en un an ; l’usage de Vertex AI a été multiplié par six, son trafic par dix.
Les vecteurs de risque spécifiques sont nouveaux : les serveurs MCP (Model Context Protocol, le protocole qui laisse un agent IA appeler des API internes) qui exposent des API internes, les extensions de navigateur dotées de capacités agentiques, les agents connectés via OAuth qui détiennent un accès persistant, et une prolifération de tokens API qui crée des chaînes d’accès que personne ne surveille de bout en bout. Tout cela s’ajoute aux attaques par injection de prompt, capables de détourner un agent shadow non sécurisé pour lui faire exfiltrer des données sans qu’on le lui ait jamais demandé. Gartner s’attend à ce que 40 % des applications d’entreprise intègrent des agents IA spécialisés d’ici fin 2026, contre moins de 5 % en 2025, un bond d’un ordre de grandeur en dix-huit mois, indépendamment de la politique de gouvernance en place ou non à ce moment-là.
Le rapport Unit 42 Global Incident Response 2026 de Palo Alto Networks donne un nom à ce basculement : LOTAIL, vivre de la terre de l’IA, les attaquants qui se servent des propres plateformes IA internes d’une organisation comme outil d’attaque plutôt que d’apporter un malware extérieur. Unit 42 a documenté des attaquants exploitant des permissions Google Vertex AI mal configurées pour élever leurs privilèges et installer un modèle malveillant en cheval de Troie pour exfiltrer des données, et a mesuré à quel point l’exfiltration s’est accélérée dès que l’IA entre en jeu : le quart le plus rapide des intrusions fait désormais sortir des données volées en 1,2 heure, contre 4,8 heures l’année précédente. Quatre-vingt-neuf pour cent des intrusions du rapport remontent à une défaillance d’identité d’une forme ou d’une autre, exactement le même mode de défaillance qui sous-tend la plupart des expositions Shadow AI : un token, une connexion, une clé API que personne ne surveillait. Le rapport IBM 2025 sur les brèches détaille les causes des incidents liés à l’IA dans des termes similaires : la compromission de la chaîne d’approvisionnement (applications, API, plug-ins) représente 30 % des cas, devant l’inversion de modèle à 24 % et l’évasion de modèle à 21 % ; ces incidents de chaîne d’approvisionnement ont provoqué une compromission de données étendue dans 60 % des cas et une perturbation opérationnelle dans 31 % des cas.
Ce schéma n’a rien d’hypothétique. Les chercheurs en sécurité de Wiz ont documenté Shai-Hulud et la campagne s1ngularity qui lui est liée, un malware à thématique IA qui détournait les outils en ligne de commande des développeurs pour exfiltrer des tokens GitHub, ainsi qu’une brèche surnommée Moltbook : une application développée en mode « vibe coding » dont le développeur n’avait jamais activé la sécurité au niveau ligne (row-level security) de sa base de données Supabase, exposant environ 1,5 million de clés API d’autres utilisateurs, dont des identifiants OpenAI, Anthropic, AWS, GitHub et Google Cloud, à quiconque interrogeait directement la base. Les deux cas montrent les mêmes mécaniques que la recherche sur les identifiants Copilot vue plus haut, mais un cran plus loin : le Shadow AI ne se contente pas de faire fuiter un document, il peut ouvrir un chemin direct dans la chaîne d’approvisionnement logicielle d’une entreprise.
La gouvernance bat l’interdiction
La tendance de l’industrie pointe dans une seule direction. Samsung est passé d’une interdiction générale à la construction de son propre outil interne. Un établissement de santé qui a déployé DAX Copilot de Nuance comme alternative approuvée a constaté que l’outil sanctionné réduisait l’usage non autorisé plus efficacement que la répression seule. Les deux cas donnent la même leçon : une interdiction sans rien pour la remplacer ne supprime pas le Shadow AI, elle le pousse simplement hors de vue.
La première vraie étape consiste à cartographier ce qui reste invisible aujourd’hui : le trafic réseau vers les points d’accès API GenAI connus (api.openai.com, generativelanguage.googleapis.com, les domaines d’Anthropic), la surveillance DNS des domaines liés à l’IA, une couche CASB (Cloud Access Security Broker, un intermédiaire qui repère les logiciels SaaS utilisés dans l’ombre) pour découvrir le SaaS IA, un audit des tokens OAuth et des connexions API que les agents utilisent déjà, et un inventaire des modèles open weight installés localement (Llama, Mistral) qui contournent par construction tout contrôle réseau.
Vient ensuite une politique à trois niveaux : les outils approuvés sans restriction, les outils autorisés sous conditions précises (un assistant de code validé pour du code non propriétaire mais pas pour les systèmes de production), et les outils purement interdits. La politique doit dire clairement quelles catégories de données peuvent ou non aller dans un outil IA, et prévoir un vrai chemin d’approbation pour une demande de nouvel outil, pas un trou noir. Les DLP à base de règles ne suffiront pas seuls à porter cette politique : les contrôles d’exfiltration doivent fonctionner en temps réel quelle que soit la destination, et être capables de lire une interaction en langage naturel avec des outils GenAI, pas seulement repérer des signatures de fichiers connues. Un DLP au niveau du navigateur, capable de repérer des données sensibles qui partent vers une application IA, combiné à une surveillance des actions copier-coller au niveau des postes, forment les deux couches qui referment la faille laissée ouverte par les outils à base de règles.
Pour les équipes d’ingénierie en particulier, la diffusion des assistants de code IA rend l’hygiène des secrets non négociable : scan automatique des secrets sur chaque dépôt, gestion centralisée des identifiants plutôt que des valeurs codées en dur, et revue obligatoire de tout code généré par IA avant sa fusion en production. Le taux de 6,4 % de GitGuardian pour les dépôts actifs sous Copilot qui laissent fuiter au moins un secret suffit à lui seul à justifier ces contrôles, indépendamment de toute politique de gouvernance IA plus large.
Les régulateurs ont déjà montré ce qu’ils font d’un canal non surveillé que les salariés utilisent quand même. Entre décembre 2021 et février 2024, la SEC et la CFTC ont infligé des amendes à plus d’une douzaine de grandes banques, dont JPMorgan Chase, Bank of America, Morgan Stanley et Goldman Sachs, pour avoir laissé leur personnel traiter des affaires via WhatsApp et d’autres applications de messagerie que la conformité ne pouvait ni archiver ni contrôler. Le plus gros lot d’amendes, en septembre 2022, a coûté à onze établissements 1,8 milliard de dollars au total ; les pénalités cumulées de la SEC, de la CFTC et de la FINRA sur l’ensemble de la vague dépassent depuis 3,5 milliards de dollars. Le constat était le même dans chaque accord : les établissements n’avaient aucune archive de ce que leurs salariés se disaient sur ces canaux, une défaillance de tenue de dossiers que les régulateurs traitent comme une infraction en soi, indépendamment du fait que quelque chose d’inapproprié ait été dit ou non. Un chatbot IA non approuvé crée exactement le même type de faille, un canal que les salariés utilisent tous les jours et que l’entreprise ne peut ni voir, ni archiver, ni produire sur demande. Le secteur financier est celui où ce précédent s’applique le plus directement aujourd’hui, mais l’exposition sous-jacente, un canal actif hors de toute trace, n’est pas propre à un secteur.
Le volet juridique et conformité rattrape la même tendance. Les régulateurs et les tribunaux attendent désormais qu’une organisation produise la preuve des contrôles en place avant un incident, pas seulement un récit de ce qui s’est passé pendant. Un programme de gouvernance construit autour de la visibilité et d’une liste d’outils approuvés réaliste constitue, par construction, exactement cette preuve.
Par où commencer
Le Shadow AI n’est pas un risque futur, c’est un coût qui court déjà. Une organisation sur cinq a déjà subi une brèche à cause de ça, avec une prime moyenne de 670 000 dollars et une fenêtre de détection de 247 jours, et les données qu’il fait fuiter, code source, propriété intellectuelle, dossiers réglementés, sont exactement ce qui alimente les campagnes les plus dévastatrices de l’économie du ransomware. L’IA agentique s’apprête à élargir cette exposition plus vite que la plupart des programmes de gouvernance ne pourront suivre. L’interdiction pousse le problème hors de vue sans le supprimer ; la visibilité sur ce qui sort réellement de l’entreprise, associée à un outil sanctionné assez bon pour que les salariés n’aient pas besoin de le contourner, voilà ce qui referme vraiment la faille. Les organisations qui attendent encore qu’une brèche les force à agir paieront la prime de 670 000 dollars pour apprendre cette leçon à leurs dépens.

Foire aux questions
Qu’est-ce que le Shadow AI ?
Le Shadow AI désigne l’usage d’outils IA, chatbots, assistants de code, extensions de navigateur ou agents, par des salariés sans l’approbation ni la supervision des équipes informatique ou sécurité de leur entreprise. Il prolonge le Shadow IT mais porte un risque différent : les données ne restent pas simplement quelque part sans surveillance, un modèle peut les traiter, les conserver, et parfois les restituer plus tard à quelqu’un d’autre.
En quoi le Shadow AI diffère-t-il du Shadow IT ?
Le Shadow IT, c’est l’usage d’un service non approuvé, un espace cloud personnel ou une messagerie, où le risque principal est que ce service se fasse pirater. Le Shadow AI, c’est confier des données à un système capable d’apprendre dessus, de les mémoriser, et de se voir demander par quelqu’un d’autre de les reproduire, une exposition différente et souvent moins visible.
Interdire les outils IA au travail suffit-il vraiment à arrêter le Shadow AI ?
Interdire les outils IA au travail suffit rarement, à lui seul, à arrêter le Shadow AI. Samsung a interdit ChatGPT dans toute l’entreprise en mai 2023, après que des salariés y avaient collé du code propriétaire, avant de se mettre à construire un outil IA interne plutôt que de s’en remettre à la seule interdiction. Les enquêtes menées auprès des salariés après une interdiction formelle trouvent systématiquement que près de la moitié continuent d’utiliser leurs comptes IA personnels quand même ; l’interdiction supprime surtout la visibilité, pas le comportement sous-jacent.
Le Shadow AI est-il lié aux attaques par ransomware ?
Le Shadow AI peut être lié aux attaques par ransomware. Les types de données qui fuient le plus souvent via l’usage non sanctionné de l’IA, code source, fichiers clients, contrats, sont exactement les catégories que les groupes de ransomware valorisent pour leurs campagnes de double extorsion, qui associent chiffrement et menace de publication des données volées. Une fuite Shadow AI n’a pas besoin d’être ciblée pour finir par alimenter une de ces campagnes ; il suffit qu’un attaquant tombe ensuite sur les données exposées.
Quelle est la première étape concrète pour réduire le risque Shadow AI ?
La première étape concrète consiste à cartographier ce qui reste invisible aujourd’hui, avant même d’écrire la moindre politique : le trafic réseau et DNS vers les points d’accès IA connus, une couche CASB pour découvrir le SaaS utilisé, un audit des tokens OAuth et des connexions API déjà actives, et un inventaire de tout modèle IA qui tourne localement sur les ordinateurs de l’entreprise. Une politique ne fonctionne qu’une fois l’usage réel rendu visible.
L’outil IA précis utilisé par les salariés compte-t-il, ou le risque est-il le même partout ?
L’outil IA précis utilisé par les salariés compte considérablement. OpenAI, Google et Anthropic n’entraînent pas leurs modèles sur les données soumises via leurs offres entreprise par défaut, mais les comptes grand public, ceux que le Shadow AI implique le plus souvent, le font souvent sauf désactivation manuelle. Le pays d’origine du fournisseur ajoute une autre couche : l’échec de DeepSeek à expliquer ses pratiques sur les données a conduit l’Italie à le bloquer sur tout le territoire et la Corée du Sud, l’Australie et Taïwan à l’interdire sur les appareils gouvernementaux, ce qui montre que le profil de risque d’un outil IA dépend fortement duquel il s’agit, pas seulement du fait qu’il soit approuvé ou non.