Shadow AI erklärt: Wie unerlaubte KI-Nutzung die Daten deines Unternehmens abfließen lässt
Shadow AI ist nicht genehmigte KI-Nutzung im Unternehmen. Wie Daten dabei wirklich abfließen, was es kostet, und warum Governance besser wirkt als ein Verbot.
Im März 2023 fügen Ingenieure aus Samsungs Halbleitersparte innerhalb von zwanzig Tagen bei drei getrennten Vorfällen proprietären Quellcode, ein internes Sitzungsprotokoll und Chip-Testdaten in ChatGPT ein. Samsung verbietet daraufhin im Mai Chatbots im gesamten Unternehmen und beginnt stattdessen, ein eigenes internes KI-Tool für die Belegschaft zu bauen. Der Vorfall wird zum Referenzfall für ein Problem, das inzwischen einen Namen hat: Shadow AI, die Nutzung von KI-Tools durch Mitarbeitende ohne Wissen oder Freigabe der IT- und Security-Teams. Der IBM Cost of a Data Breach Report 2025 beziffert, was dieses Problem heute kostet: Jede fünfte Organisation hatte bereits eine Datenpanne im Zusammenhang mit nicht genehmigter KI, und jede davon kostet 670.000 Dollar mehr als eine gewöhnliche Datenpanne.
Was Shadow AI eigentlich ist
Shadow AI ist die Fortsetzung eines bekannten Problems, Shadow IT, der Nutzung von Technologie außerhalb der offiziellen Freigabe, aber das Risiko dahinter ist strukturell anders. Eine Datei auf dem privaten Dropbox von jemandem ist gefährdet, wenn dieser Dienst gehackt wird. Dieselbe Datei, in einen öffentlichen Chatbot eingefügt, ist etwas ganz anderem ausgesetzt: einem Modell, das sie verarbeiten, Spuren davon behalten, beim Nachtrainieren daraus lernen und sie in manchen Fällen einer anderen Person in einer anderen Sitzung wieder ausgeben kann, alles nach einer Aufbewahrungsregel, die ein Anbieter festlegt, der sich weder an die DSGVO noch an die branchenspezifischen Regeln des Unternehmens halten muss.
Die Kategorie reicht weit über Chatbots hinaus. Sie umfasst Code-Assistenten auf privaten Konten (GitHub Copilot, Amazon CodeWhisperer), KI-gestützte Browser-Erweiterungen, Schreib- und Übersetzungstools, lokal auf einem Firmenlaptop laufende Open-Source-Modelle und KI-Funktionen, die still in SaaS-Produkten aktiviert werden, ohne dass die IT-Abteilung je zugestimmt hat. Alles, was Unternehmensdaten außerhalb eines genehmigten Governance-Rahmens verarbeitet, zählt dazu.
Warum es so schnell explodiert ist
Das Ausmaß ist alles andere als marginal. Palo Alto Networks misst im Schnitt 66 GenAI-Anwendungen pro Organisation, 6,6 davon als hochriskant eingestuft, und die Zahl der Vorfälle bei der Verhinderung von Datenverlust (DLP), die mit GenAI zusammenhängen, ist um 250 Prozent gestiegen und macht inzwischen 14 Prozent aller vom Unternehmen erfassten DLP-Vorfälle aus. Der Netskope Cloud and Threat Report 2026, der den Zeitraum Oktober 2024 bis Oktober 2025 abdeckt, stellt fest, dass sich die Zahl der GenAI-SaaS-Nutzer verdreifacht und das monatliche Prompt-Volumen versechsfacht hat, von 3.000 auf 18.000 pro Organisation; das aktivste Viertel der Organisationen verschickt inzwischen mehr als 70.000 im Monat.
Drei Kräfte treiben dieses Wachstum an. Der Produktivitätsdruck treibt Menschen zum schnellsten verfügbaren Tool. Das Fehlen einer genehmigten Alternative treibt sie weiter: In einer Umfrage im Gesundheitswesen sagten 27 Prozent der Nutzer, das nicht genehmigte Tool funktioniere schlicht besser als alles, was das Unternehmen anbot. Und Governance fehlt von vornherein größtenteils: Der IBM-Report 2025 stellt fest, dass nur 37 Prozent der Organisationen überhaupt eine KI-Governance-Richtlinie haben, 63 Prozent bleiben ganz ohne Rahmen. Private Konten erledigen den Rest der Arbeit, 47 Prozent der GenAI-Nutzer laufen immer noch über eines, gegenüber 78 Prozent im Jahr davor, aber das bleibt fast die Hälfte.
Ein Verbot schließt die Lücke nicht. Samsung hat eines versucht und danach eine genehmigte Alternative gebaut, statt sich allein auf das Verbot zu verlassen; ein breiteres Muster, das mehrere Umfragen belegen, zeigt, dass fast die Hälfte der Mitarbeitenden auch nach einem formellen Verbot weiter private KI-Konten nutzt. Das Verbot entfernt nicht das Verhalten, es entfernt die Sichtbarkeit darauf.
Diese Adoptionszahlen halten sich über mehrere unabhängige Umfragen hinweg, nicht nur in der Telemetrie eines einzelnen Anbieters. Der State of Shadow AI Report 2025 von UpGuard, gestützt auf 1.500 Befragte aus Security-Verantwortlichen und Mitarbeitenden, findet, dass 81 Prozent der Beschäftigten und 88 Prozent der Sicherheitsfachleute KI-Tools nutzen, die ihr Arbeitgeber nie genehmigt hat, einschließlich der Leute, die dafür bezahlt werden, genau das zu verhindern. Der Work Trend Index von Microsoft beziffert den Anteil auf 75 Prozent der Beschäftigten, die 2025 KI bei der Arbeit einsetzen; ein Jahr zuvor gaben bereits 78 Prozent der KI-Nutzenden an, ihre eigenen Tools mitzubringen, statt auf ein genehmigtes zu warten, ein Muster, das sich von der Generation Z bis zu den Babyboomern zieht, mit nur geringen Unterschieden je nach Alter. Der Überschneidungspunkt zwischen „kennt das Risiko” und „nutzt das Tool trotzdem” ist der unangenehme Teil: Die Daten von UpGuard zeigen, dass das Wissen um das Risiko bei der Datenverarbeitung die Nutzung privater Konten kaum verringert.
Nicht jedes KI-Tool birgt dasselbe Risiko
OpenAI, Google und Anthropic ziehen alle eine klare Grenze zwischen ihren Consumer-Produkten und ihren Business-Angeboten. Standardmäßig trainiert OpenAI seine Modelle nicht mit Unterhaltungen, Dateien oder Code, die über ChatGPT Enterprise, ChatGPT Team, ChatGPT Business oder die API eingereicht werden. Die Consumer-Version von ChatGPT trainiert standardmäßig mit den Unterhaltungen, und das abzuschalten erfordert einen manuellen Umweg über Datenschutzeinstellungen, die die meisten Leute nie öffnen. Shadow AI bedeutet per Definition, dass Mitarbeitende nicht auf dem Tarif mit diesem vertraglichen Schutz sind. Ein Ingenieur, der sich ein privates ChatGPT-Konto anlegt, um einen Codeschnipsel einzufügen, übergibt diesen Schnipsel standardmäßig an eine Trainingspipeline, der das Unternehmen nie zugestimmt hat und die es nie genehmigt hätte.
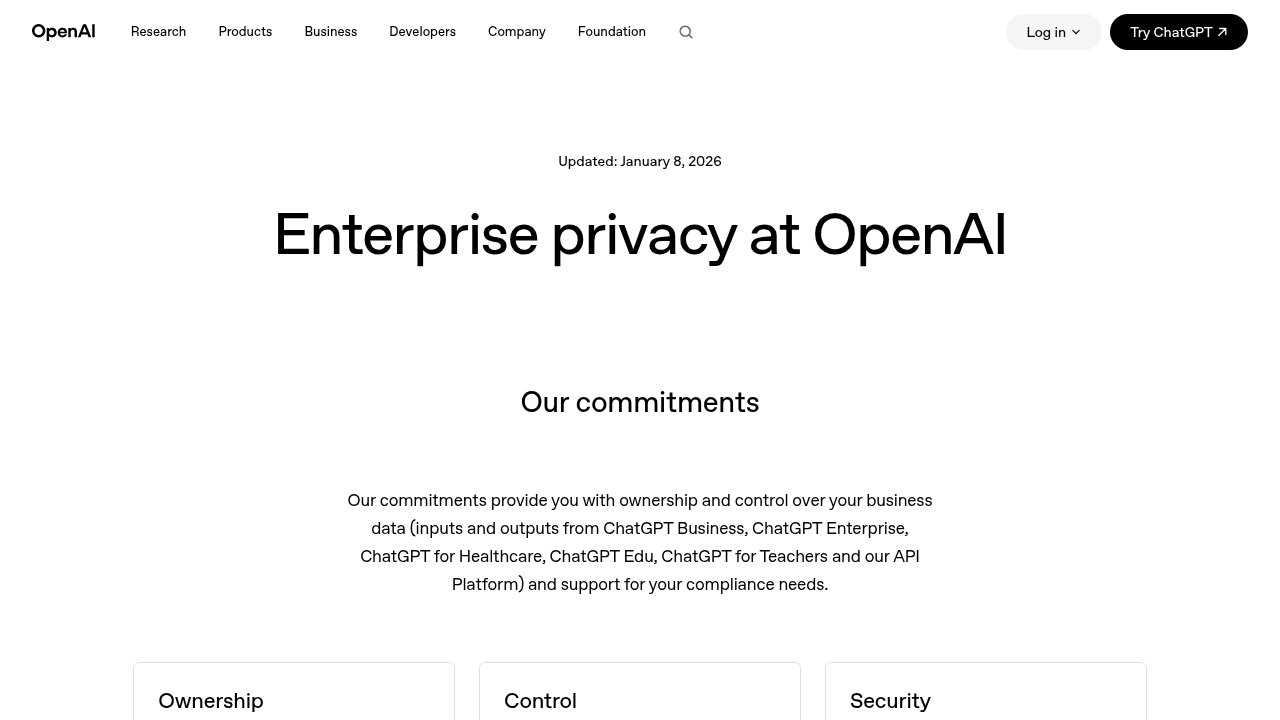 Quelle: openai.com/enterprise-privacy
Das Herkunftsland des Anbieters fügt eine zweite Ebene hinzu, die über die Nutzungsbedingungen hinausgeht. DeepSeek, das chinesische Labor, dessen Open-Weight-Modell R1 Anfang 2025 eine Adoptionswelle auslöste, leitet die Daten seiner gehosteten Chat-App auf Server, die chinesischem Recht unterliegen. Italiens Datenschutzbehörde, die Garante, ordnete im Januar 2025 die Sperrung von DeepSeek im gesamten italienischen Markt an, nachdem das Unternehmen es versäumt hatte, seine Datenpraktiken gemäß der DSGVO zu erklären. Südkorea untersagte die App auf Regierungsgeräten, und die dortige Datenschutzbehörde setzte neue Downloads aus, bis eine Compliance-Prüfung abgeschlossen ist; Australien und Taiwan folgten mit klaren Verboten auf Regierungssystemen. Keine dieser Maßnahmen war symbolisch. Es waren formelle regulatorische und sicherheitspolitische Entscheidungen, und sie zeigen, dass die Risikolücke zwischen KI-Anbietern längst nicht mehr theoretisch ist: Das Herkunftsland eines Tools und seine standardmäßigen Regeln zur Datenverarbeitung verändern die Rechnung inzwischen genauso stark wie die Kategorie des Tools selbst. Eine Shadow-AI-Richtlinie, die „KI-Tool” als einen einzigen, undifferenzierten Topf behandelt, übersieht diese Unterscheidung vollständig.
Zwei grundverschiedene Wege, auf denen Daten wirklich abfließen
Der erste Weg läuft über die Eingabe selbst. Ein Mitarbeiter fügt ein Dokument in einen Chatbot ein, lädt eine Datei hoch, verbindet ein SaaS-Tool über eine API mit einem KI-Dienst, oder erteilt ein OAuth-Token, das einem KI-Agenten dauerhaften Zugriff auf Unternehmenssysteme gibt. Dieser Datenverkehr läuft über gewöhnliches HTTPS, auf Netzwerkebene nicht von jeder anderen Web-Anfrage zu unterscheiden, weshalb regelbasierte DLP-Tools, die auf bekannte Muster ausgelegt sind, ihn meist übersehen: Sie wurden nie dafür gebaut, Absicht innerhalb einer Konversation in natürlicher Sprache zu erkennen. Die Analyse von 22,4 Millionen Unternehmens-Prompts durch Harmonic Security fand 665 unterschiedliche GenAI-Tools im aktiven Einsatz, davon nur 40 Prozent an ein offizielles Firmenabonnement gebunden; fast 17 Prozent der von ihr gefundenen Fälle mit sensiblen Datenlecks, knapp 98.000 Fälle, stammten aus kostenlosen privaten Konten, die für die IT-Abteilung völlig unsichtbar sind. Die am häufigsten betroffenen Daten sind laut Netskopes Report 2026 regulierte Daten, also personenbezogene, finanzielle oder medizinische Informationen, die allein 54 Prozent der gemeldeten GenAI-Richtlinienverstöße ausmachen, vor Quellcode mit 15 Prozent und Passwörtern oder API-Schlüsseln mit 8 Prozent.
Der zweite Weg ist strukturell anders: Er beruht auf Memorierung innerhalb des Modells selbst. Forscher der University of Hong Kong bauten 900 Prompts aus öffentlichen GitHub-Codefragmenten und extrahierten damit 2.702 gültige Zugangsdaten aus GitHub Copilot und 129 aus Amazon CodeWhisperer, mindestens 200 davon echte, auf GitHub noch nachweisbare Geheimnisse. Hier kommt es überhaupt nicht darauf an, was ein Mitarbeiter eingetippt hat. Ein Code-Assistent, der mit Repositories trainiert wurde, die fest codierte Geheimnisse enthalten, kann diese Geheimnisse memorieren und sie in einem Vorschlag an einen völlig anderen Nutzer zurückgeben.
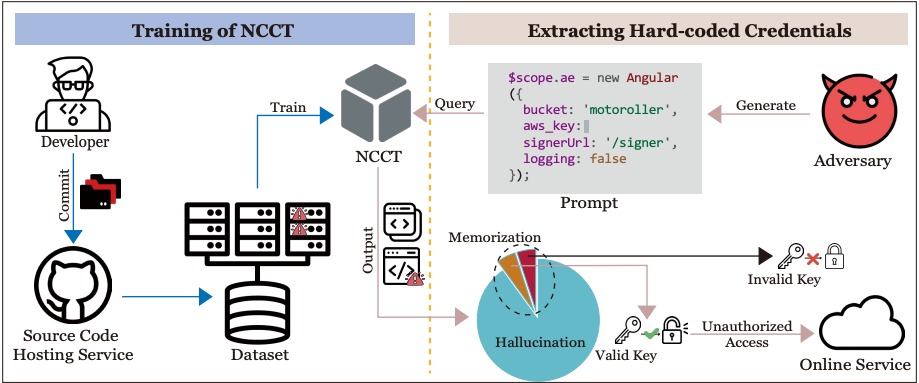 Quelle: GitGuardian
GitGuardian fand mehr als 1.200 durchgesickerte Geheimnisse in einer Stichprobe von 20.000 Repositories mit aktivem Copilot, eine Quote von 6,4 Prozent, 40 Prozent höher als der Grundwert über öffentliche Repositories insgesamt; private Repositories ließen Klartext-Geheimnisse achtmal häufiger durchsickern als öffentliche.
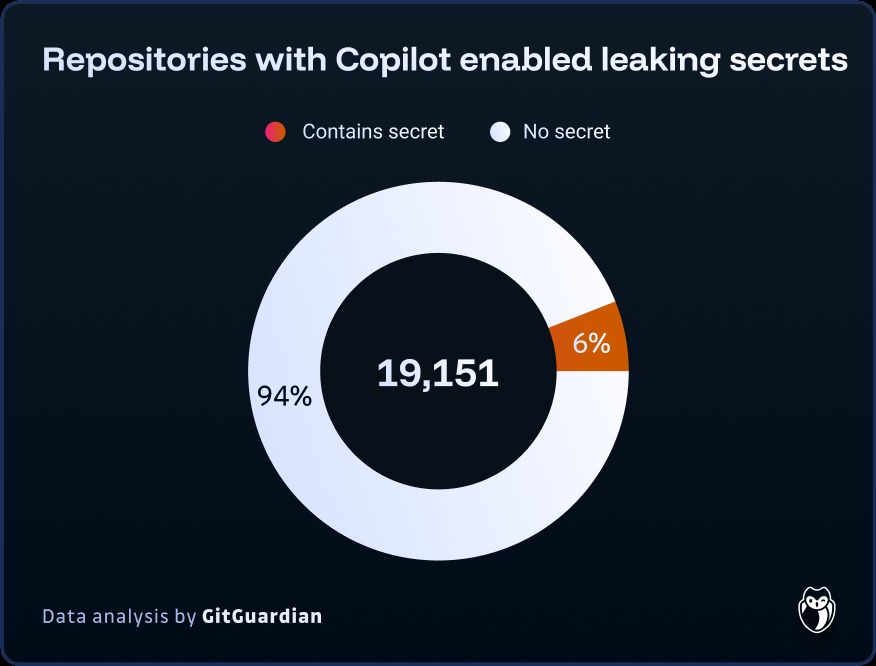 Quelle: GitGuardian
Ein Angreifer muss nur Prompts bauen, die auf einen bestimmten Typ von Zugangsdaten zielen, AWS-Schlüssel, GitHub-Token, Google-OAuth-Geheimnisse, die Vorschläge nach Entropie und Validierungsmuster filtern, und geht mit etwas nach Hause, das ein echtes System öffnet.
Was Shadow AI wirklich kostet
Die Finanzzahlen laufen aus mehreren Quellen zusammen. Der IBM-Report 2025, gestützt auf 600 Organisationen aus 17 Branchen und 16 Ländern, beziffert die durchschnittliche Datenpanne auf 4,63 Millionen Dollar bei Organisationen mit hoher Shadow-AI-Exposition, gegenüber 3,96 Millionen bei geringer oder keiner Exposition, eine Lücke von 670.000 Dollar. Zwanzig Prozent der Organisationen in der Studie waren bereits betroffen, 63 Prozent hatten keinerlei KI-Governance, und von jenen mit einem KI-bezogenen Vorfall fehlten 97 Prozent angemessene KI-Zugriffskontrollen.
Der Schaden endet nicht bei der Rechnung. Sechsundachtzig Prozent der betroffenen Organisationen in der IBM-Studie meldeten eine betriebliche Störung: Auftragsabwicklung, Kundenservice, Produktionslinien. Shadow-AI-Vorfälle streuten sensible Daten häufiger als andere KI-Vorfälle über mehrere Umgebungen hinweg und vergrößerten damit den Schadensradius eines einzigen unüberwachten Tools. Die Erkennung dauert im Schnitt 247 Tage, etwa eine Woche länger als der Gesamtdurchschnitt des Reports, ein Zeitfenster, das einem Eindringling, oder schlicht einem neugierigen Dritten, einen langen Vorlauf verschafft, bevor jemand etwas bemerkt.
Der 2026er-Report des Ponemon Institute zu den Kosten von Insider-Risiken, erstellt mit DTEX, beziffert die jährlichen Kosten von Insider-Risiken auf 19,5 Millionen Dollar pro Organisation, davon 53 Prozent, also 10,3 Millionen, auf nicht böswillige Akteure zurückzuführen: meist Mitarbeitende, deren einziger Fehler war, zum schnellsten Tool zu greifen. Für eine Security-Verantwortliche, die einen Budgetantrag aufbaut, ist die Rechnung einfach: Ein Governance-Programm, das weniger als 670.000 Dollar im Jahr kostet, zahlt sich beim ersten verhinderten Vorfall bereits aus.
Die Gefahr, die am meisten zählt: Was durchsickert, wird zweimal gestohlen
Die Datenkategorien, die am häufigsten über Shadow AI durchsickern, Quellcode, geistiges Eigentum, Kundendaten, regulierte Daten, sind genau jene mit dem höchsten Wiederverkaufs- und Erpressungswert, sobald sie das Unternehmen verlassen haben. Der IBM-Report 2025 beziffert diese Überschneidung direkt: Datenpannen mit Shadow-AI-Beteiligung legen personenbezogene Kundendaten (PII) in 65 Prozent der Fälle offen, gegenüber 53 Prozent ohne Shadow AI, und geistiges Eigentum in 40 Prozent der Fälle, gegenüber 33 Prozent.
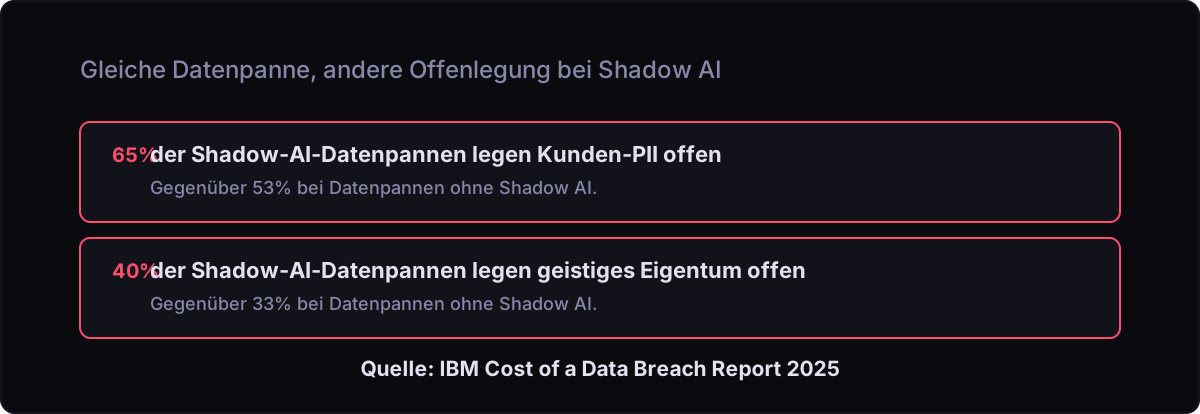
Diese Lücke ist kein Zufall und nichts Theoretisches. Ransomware-Gruppen, die doppelte Erpressung betreiben, also Daten verschlüsseln und gleichzeitig mit deren Veröffentlichung drohen, behandeln jeden Fundus offengelegter sensibler Daten als ausnutzbare Ressource, ganz gleich, wie diese das Unternehmen verlassen haben. Ein Shadow-AI-Leck muss nicht gezielt sein, um für einen Angreifer nützlich zu werden: Ein Mitarbeiter fügt ohne böse Absicht eine Kundenliste in einen nicht genehmigten Chatbot ein, diese Daten landen auf einem Drittanbieter-Server außerhalb des Sicherheitsperimeters des Unternehmens, und ein Angreifer, der diesen Dienst kompromittiert, den Mitarbeiter direkt phisht oder schlicht Zugang zu einem geleakten Konto kauft, erbt damit ein fertiges Erpressungsgut. Der Q3-2025-Report von Coveware zur Ransomware-Ökonomie fand Datenexfiltration in 76 Prozent der erfassten Fälle, selbst während der Anteil zahlender Opfer auf 23 Prozent fiel, eine Verschiebung, die manche Ransomware-Betreiber dazu treibt, gezielt Insider anzuwerben, statt sich nur auf technische Einfallstore zu verlassen; der Report zitiert einen Partner der Medusa-Gruppe, der versuchte, einen Mitarbeiter direkt zu bestechen, um Ransomware von innen zu platzieren, genau das Profil der Person, die eine Lücke in der Shadow-AI-Richtlinie exponiert. DecodeStack hat beschrieben, wie dieses Modell aus Verschlüsselung und Datenleck in der Praxis funktioniert, in einem Beitrag über eine reale Ransomware-Kampagne mit doppelter Erpressung. Gartners eigene Prognose, gestützt auf eine Befragung von 302 Security-Verantwortlichen, geht davon aus, dass mehr als 40 Prozent der Unternehmen bis 2030 eine Datenpanne oder einen Compliance-Vorfall im Zusammenhang mit Shadow AI erleiden werden; 69 Prozent der Befragten vermuteten schon jetzt, dass ihre Mitarbeitenden verbotene GenAI-Tools nutzen.
Nichts davon ist ein dokumentierter Fall, in dem Ermittler eine bestimmte Ransomware-Attacke auf ein bestimmtes, namentlich benanntes Shadow-AI-Leck zurückgeführt hätten. Was existiert, ist eine statistische und mechanische Überschneidung, dieselben Datenkategorien, dieselbe fehlende Sichtbarkeit, keine öffentlich belegte Kette vom eingefügten Dokument bis zur Lösegeldforderung. Die forensische Aufarbeitung von Datenpannen beginnt gerade erst, KI-Tool-Logs routinemäßig zu prüfen, und diese Lücke könnte sich mit der Zeit schließen. Bis dahin lautet die zutreffende Aussage, dass Shadow AI die Bedingungen schafft, von denen doppelte Erpressung lebt, nicht, dass eine namentlich benannte Datenpanne nachweislich dort ihren Anfang genommen hätte.
Ransomware ist die schärfste Ausprägung dieser Gefahr, nicht die einzige. Derselbe durchgesickerte Quellcode und dieselben Verträge tauchen in behördlichen Bußgeldern, verlorenem Wettbewerbsvorteil und ganz gewöhnlichem Vertrauensverlust bei Kunden auf, lange bevor eine Erpressergruppe überhaupt ins Spiel kommt. Shadow AI allein als „Vorstufe zur Ransomware” zu behandeln, unterschätzt die alltäglichen Kosten; es allein als „IT-Hygieneproblem” abzutun, unterschätzt die Obergrenze.
Es lohnt sich, das von einem verwandten, aber anderen Trend zu trennen: KI-Tools, die von Angreifern selbst gebaut und eingesetzt werden, nicht von unvorsichtigen Mitarbeitenden. ESET hat PromptLock dokumentiert, beschrieben als die erste Ransomware, die zur Laufzeit generative KI einsetzt, und daneben PromptSpy verfolgt, eine Android-Malware, die zur Laufzeit Googles Gemini aufruft, um Fernüberwachung zu betreiben. IBM X-Force hat Slopoly dokumentiert, eine Backdoor mit vermutlich KI-generiertem Code, die den Interlock-Ransomware-Angriffen der Gruppe Hive0163 zugeordnet wird, und Check Point Research hat HexStrike-AI verfolgt, ein legitimes Open-Source-Framework für Penetrationstests, das Angreifer innerhalb weniger Stunden nach seiner Veröffentlichung zweckentfremdeten, um die Ausnutzung frisch bekannt gewordener Schwachstellen zu automatisieren. Keines dieser Tools ist Shadow AI im engen Sinn, hier sitzt kein Mitarbeiter am Steuer, aber sie zeigen, dass generative KI inzwischen an beiden Enden desselben Problems steht: Nicht genehmigte Nutzung innerhalb des Unternehmens schafft die Gefahr, und KI-gestützte Werkzeuge außerhalb des Unternehmens nutzen sie zunehmend aus.
Das nächste Problem: autonome Agenten, die niemand freigegeben hat
Shadow AI bewegt sich über einzelne Chatbot-Gespräche hinaus zu autonomen Agenten, die eigenständig handeln, in Maschinengeschwindigkeit, mit dauerhaftem Zugriff auf Unternehmenssysteme und ohne dass ein Mensch jeden Schritt prüft. Eine klassische Shadow-AI-Interaktion ist eine Person, die einmal ein Dokument einfügt. Ein nicht genehmigter Agent ist etwas grundlegend anderes: Er besitzt API-Zugangsdaten, verkettet Aktionen über mehrere Dienste hinweg, läuft dauerhaft und entscheidet, ohne dass jemand die einzelne Aktion abzeichnet. Netskopes Telemetrie für 2026 zeigt diese Verschiebung bereits im Gange: Zwei Drittel der Organisationen verbinden sich direkt mit api.openai.com, das Zugriffsmuster automatisierter Workflows und Agenten statt eines Menschen, der im Browser tippt; 33 Prozent nutzen OpenAI über Azure, 27 Prozent Amazon Bedrock, 10 Prozent Google Vertex AI. Nutzerzahl und Datenverkehr von Bedrock haben sich binnen eines Jahres verdreifacht; die Nutzung von Vertex AI hat sich versechsfacht, der Datenverkehr verzehnfacht.
Die spezifischen Risikovektoren sind neu: MCP-Server (Model Context Protocol, das Protokoll, über das ein KI-Agent interne APIs ansprechen kann), die interne APIs offenlegen, Browser-Erweiterungen mit agentischen Fähigkeiten, über OAuth verbundene Agenten mit dauerhaftem Zugriff, und eine wuchernde Zahl von API-Token, die Zugriffsketten erzeugen, die niemand durchgängig überwacht. Dazu kommen Prompt-Injection-Angriffe, die einen ungesicherten Shadow-Agenten kapern können, um Daten zu exfiltrieren, ohne dass er je darum gebeten wurde. Gartner erwartet, dass bis Ende 2026 40 Prozent der Unternehmensanwendungen spezialisierte KI-Agenten einbetten werden, gegenüber unter 5 Prozent im Jahr 2025, ein Sprung um eine Größenordnung innerhalb von achtzehn Monaten, unabhängig davon, welche Governance-Richtlinie bis dahin steht oder eben nicht.
Der Unit-42-Global-Incident-Response-Report 2026 von Palo Alto Networks gibt dieser Verschiebung einen Namen: LOTAIL, das Leben von der KI-Landschaft, Angreifer, die sich die eigenen internen KI-Plattformen einer Organisation als Angriffswerkzeug zunutze machen, statt externe Malware mitzubringen. Unit 42 dokumentierte Angreifer, die falsch konfigurierte Google-Vertex-AI-Berechtigungen ausnutzten, um Privilegien zu eskalieren und ein bösartiges Modell als trojanisches Pferd für die Exfiltration zu platzieren, und maß, wie viel schneller die Exfiltration geworden ist, sobald KI im Spiel ist: Das schnellste Viertel der Angriffe schleust gestohlene Daten inzwischen in 1,2 Stunden hinaus, gegenüber 4,8 Stunden im Jahr zuvor. Neunundachtzig Prozent der Angriffe im Report gehen auf irgendeine Form von Identitätsversagen zurück, genau der Fehlermodus, der auch hinter den meisten Shadow-AI-Vorfällen steht: ein Token, ein Login, ein API-Schlüssel, den niemand im Blick hatte. Der IBM-Report 2025 schlüsselt die Ursachen KI-bezogener Vorfälle ähnlich auf: Kompromittierung der Lieferkette (Apps, APIs, Plug-ins) macht 30 Prozent aus, vor Modellinversion mit 24 Prozent und Modellumgehung mit 21 Prozent; diese Lieferketten-Vorfälle verursachten in 60 Prozent der Fälle eine breite Datenkompromittierung und in 31 Prozent eine betriebliche Störung.
Dieses Muster ist nicht hypothetisch. Sicherheitsforscher von Wiz haben Shai-Hulud und die verwandte s1ngularity-Kampagne dokumentiert, KI-thematisierte Malware, die Kommandozeilen-Tools von Entwicklern kaperte, um GitHub-Token zu exfiltrieren, sowie einen Vorfall namens Moltbook: eine per Vibe Coding entwickelte App, deren Entwickler die Row-Level-Security ihrer Supabase-Datenbank nie aktiviert hatte, wodurch rund 1,5 Millionen API-Schlüssel anderer Nutzer offenlagen, darunter Zugangsdaten für OpenAI, Anthropic, AWS, GitHub und Google Cloud, für jeden, der die Datenbank direkt abfragte. Beide Fälle zeigen dieselbe Mechanik wie die oben beschriebene Copilot-Forschung, nur eine Ebene weiter oben: Shadow AI lässt nicht nur ein Dokument durchsickern, es kann einen direkten Weg in die Software-Lieferkette eines Unternehmens öffnen.
Governance schlägt Verbot
Das Muster in der Branche zeigt einheitlich in eine Richtung. Samsung ist von einem pauschalen Verbot dazu übergegangen, ein eigenes internes Tool zu bauen. Ein Gesundheitsversorger, der Nuances DAX Copilot als genehmigte Alternative einführte, stellte fest, dass das sanktionierte Tool die nicht genehmigte Nutzung wirksamer eindämmte als reine Durchsetzung. Beide Fälle liefern dieselbe Lektion: Ein Verbot ohne Ersatz beseitigt Shadow AI nicht, es drängt es nur aus dem Blickfeld.
Der erste echte Schritt besteht darin, das derzeit Unsichtbare zu kartieren: Netzwerkverkehr zu bekannten GenAI-API-Endpunkten (api.openai.com, generativelanguage.googleapis.com, Anthropics Domains), DNS-Überwachung für KI-bezogene Domains, eine CASB-Schicht (Cloud Access Security Broker, ein Vermittler, der genutzte, aber nicht offiziell freigegebene SaaS-Dienste aufspürt) zur Entdeckung von SaaS-KI, ein Audit der OAuth-Token und API-Verbindungen, die Agenten bereits nutzen, sowie eine Bestandsaufnahme lokal installierter Open-Weight-Modelle (Llama, Mistral), die jede Netzwerkkontrolle von vornherein umgehen.
Darauf folgt eine dreistufige Richtlinie: Tools, die uneingeschränkt genehmigt sind, Tools, die unter bestimmten Auflagen erlaubt sind (ein Code-Assistent, freigegeben für nicht-proprietären Code, aber nicht für Produktionssysteme), und Tools, die komplett verboten sind. Die Richtlinie muss klar benennen, welche Datenkategorien in ein KI-Tool dürfen und welche nicht, und einen echten Freigabeweg für neue Tool-Anfragen bieten, kein schwarzes Loch. Regelbasiertes DLP allein trägt das nicht: Exfiltrationskontrollen müssen in Echtzeit arbeiten, unabhängig vom Ziel, und in der Lage sein, natürlichsprachliche Interaktion mit GenAI-Tools zu lesen, nicht nur bekannte Dateisignaturen abzugleichen. Browserseitiges DLP, das sensible Daten erkennt, die in eine KI-App abfließen, kombiniert mit Endpoint-Überwachung von Kopier-Einfüge-Aktionen, sind die beiden Schichten, die die Lücke schließen, die regelbasierte Tools offenlassen.
Für Entwicklungsteams speziell macht die Verbreitung von KI-Code-Assistenten Secrets-Hygiene nicht verhandelbar: automatisches Scannen nach Geheimnissen in jedem Repository, zentralisiertes Credential-Management statt fest codierter Werte, und verpflichtende Prüfung von KI-generiertem Code, bevor er in die Produktion gemerged wird. GitGuardians Quote von 6,4 Prozent für Copilot-aktive Repositories, die mindestens ein Geheimnis durchsickern lassen, rechtfertigt diese Kontrollen für sich allein, unabhängig von jeder umfassenderen KI-Governance-Richtlinie.
Regulierungsbehörden haben bereits gezeigt, was sie mit einem unüberwachten Kanal machen, den Mitarbeitende trotzdem nutzen. Zwischen Dezember 2021 und Februar 2024 verhängten die SEC und die CFTC Geldstrafen gegen mehr als ein Dutzend Großbanken, darunter JPMorgan Chase, Bank of America, Morgan Stanley und Goldman Sachs, weil sie ihrer Belegschaft erlaubt hatten, geschäftliche Kommunikation über WhatsApp und andere Messaging-Apps abzuwickeln, die die Compliance-Abteilung weder archivieren noch prüfen konnte. Die größte Einzelrunde, im September 2022, kostete elf Firmen zusammen 1,8 Milliarden Dollar; die kumulierten Strafen von SEC, CFTC und FINRA über die gesamte Prüfungswelle hinweg liegen inzwischen bei über 3,5 Milliarden Dollar. Der Befund war in jeder Einigung derselbe: Die Firmen hatten kein Archiv dessen, worüber ihre Mitarbeitenden auf diesen Kanälen sprachen, ein Versäumnis bei der Aufzeichnungspflicht, das Regulierungsbehörden für sich genommen als Verstoß werten, unabhängig davon, ob tatsächlich etwas Unangemessenes gesagt wurde. Ein nicht genehmigter KI-Chatbot erzeugt genau dieselbe Art von Lücke, einen Kanal, den Mitarbeitende täglich nutzen und den das Unternehmen weder sehen, noch archivieren, noch auf Anfrage vorlegen kann. Die Finanzbranche ist dort, wo dieser Präzedenzfall heute am direktesten greift, aber die zugrunde liegende Gefahr, ein aktiver Kanal außerhalb jeder Aufzeichnung, ist nicht branchenspezifisch.
Auch die rechtliche und regulatorische Seite zieht bei diesem Trend nach. Regulierungsbehörden und Gerichte erwarten zunehmend, dass eine Organisation nachweisen kann, welche Kontrollen vor einem Vorfall bestanden, nicht nur, was während des Vorfalls geschah. Ein Governance-Programm, das auf Sichtbarkeit und einer funktionierenden Liste genehmigter Tools aufbaut, ist schon durch seine Konstruktion genau dieser Nachweis.
Wo du anfängst
Shadow AI ist kein zukünftiges Risiko, es ist ein laufender Kostenfaktor. Jede fünfte Organisation wurde deswegen bereits kompromittiert, mit einem durchschnittlichen Aufpreis von 670.000 Dollar und einem Erkennungsfenster von 247 Tagen, und die Daten, die dabei durchsickern, Quellcode, geistiges Eigentum, regulierte Datensätze, sind genau das, was die schädlichsten Kampagnen der Ransomware-Ökonomie befeuert. Agentische KI wird diese Gefahr schneller ausweiten, als die meisten Governance-Programme mithalten können. Ein Verbot drängt das Problem aus dem Blickfeld, ohne es zu beseitigen; Sichtbarkeit darüber, was das Unternehmen tatsächlich verlässt, kombiniert mit einem sanktionierten Tool, das gut genug ist, dass Mitarbeitende es nicht umgehen müssen, schließt die Lücke wirklich. Organisationen, die noch darauf warten, dass eine Datenpanne sie zum Handeln zwingt, zahlen den Aufpreis von 670.000 Dollar, um diese Lektion am eigenen Leib zu lernen.

Häufig gestellte Fragen
Was ist Shadow AI?
Shadow AI ist die Nutzung von KI-Tools, Chatbots, Code-Assistenten, Browser-Erweiterungen oder Agenten, durch Mitarbeitende ohne Freigabe oder Aufsicht der IT- oder Security-Abteilung ihres Unternehmens. Es setzt Shadow IT fort, birgt aber ein anderes Risiko: Die Daten liegen nicht einfach unbeobachtet irgendwo, ein Modell kann sie verarbeiten, behalten und mitunter später jemand anderem wieder ausgeben.
Worin unterscheidet sich Shadow AI von Shadow IT?
Shadow IT bedeutet die Nutzung eines nicht genehmigten Dienstes, etwa eines privaten Cloud-Speichers oder Messengers, bei dem das Hauptrisiko darin liegt, dass dieser Dienst gehackt wird. Shadow AI bedeutet, Daten in ein System zu geben, das daraus lernen, sie memorieren und auf Aufforderung von jemand anderem reproduzieren kann, eine andere und oft weniger sichtbare Art von Gefahr.
Stoppt ein Verbot von KI-Tools am Arbeitsplatz Shadow AI tatsächlich?
Ein Verbot von KI-Tools am Arbeitsplatz stoppt Shadow AI selten allein. Samsung verbot ChatGPT 2023 unternehmensweit, nachdem Mitarbeitende proprietären Code eingefügt hatten, und begann danach, ein internes KI-Tool zu bauen, statt sich allein auf das Verbot zu verlassen. Umfragen unter Mitarbeitenden nach formellen Verboten finden durchweg, dass fast die Hälfte trotzdem weiter private KI-Konten nutzt; das Verbot beseitigt vor allem die Sichtbarkeit, nicht das zugrunde liegende Verhalten.
Hängt Shadow AI mit Ransomware-Angriffen zusammen?
Shadow AI kann mit Ransomware-Angriffen zusammenhängen. Die Datentypen, die am häufigsten über nicht genehmigte KI-Nutzung durchsickern, Quellcode, Kundendaten, Verträge, sind genau die Kategorien, die Ransomware-Gruppen für Kampagnen der doppelten Erpressung schätzen, die Verschlüsselung mit der Drohung verbinden, gestohlene Daten zu veröffentlichen. Ein Shadow-AI-Leck muss nicht gezielt sein, um am Ende eine solche Kampagne zu füttern; ein Angreifer muss die offengelegten Daten danach nur noch finden.
Was ist der erste praktische Schritt, um das Shadow-AI-Risiko zu senken?
Der erste praktische Schritt besteht darin, das derzeit Unsichtbare zu kartieren, bevor überhaupt eine Richtlinie geschrieben wird: Netzwerk- und DNS-Verkehr zu bekannten KI-Endpunkten, eine CASB-Schicht zur SaaS-Entdeckung, ein Audit bereits genutzter OAuth-Token und API-Verbindungen, sowie eine Bestandsaufnahme aller KI-Modelle, die lokal auf Firmenlaptops laufen. Eine Richtlinie funktioniert erst, sobald die tatsächliche Nutzung sichtbar ist.
Kommt es darauf an, welches konkrete KI-Tool Mitarbeitende nutzen, oder ist das Risiko überall gleich?
Es kommt erheblich darauf an, welches konkrete KI-Tool Mitarbeitende nutzen. OpenAI, Google und Anthropic trainieren standardmäßig nicht mit Daten, die über ihre Business-Tarife eingereicht werden, aber private Konten, die Shadow AI meist betrifft, tun das oft, sofern niemand manuell widerspricht. Das Herkunftsland des Anbieters fügt eine weitere Ebene hinzu: DeepSeeks Versäumnis, seine Datenpraktiken zu erklären, brachte Italien dazu, den Dienst landesweit zu sperren, und Südkorea, Australien sowie Taiwan dazu, ihn auf Regierungsgeräten zu verbieten, was zeigt, dass das Risikoprofil eines KI-Tools stark davon abhängt, um welches es sich handelt, nicht nur davon, ob es genehmigt ist.