Astra d'OpenAI a résolu dix problèmes de maths. Anthropic en a reproduit la moitié en un jour.
Le modèle non publié Astra d'OpenAI a produit dix preuves mathématiques vérifiées. Anthropic en a reproduit la moitié en 24 heures avec un modèle rival.
Le 1er août 2026, OpenAI a publié un billet de recherche annonçant qu’un modèle interne, non diffusé au public, avait produit dix preuves formelles et vérifiées par ordinateur pour des problèmes de mathématiques et d’informatique théorique restés ouverts pendant des années, dans un cas depuis 1999. Ce modèle s’appelle Astra. OpenAI ne l’a pas publié, ne dit pas quand il pourrait l’être, et n’a montré à presque personne en dehors de l’entreprise ce qu’il sait vraiment faire. Face à ce genre d’annonce, la couverture se scinde en général en deux camps, l’émerveillement sans nuance ou le rejet en bloc comme coup marketing, le même clivage qui avait accueilli les chiffres de benchmark de Kimi K3 quelques semaines plus tôt sur DecodeStack. Aucun des deux camps n’a posé la question la plus utile : quelle part de cette annonce est vérifiée, et quelle part relève de la seule parole d’OpenAI ? Le fait le plus passé sous silence répond en grande partie à cette question à lui seul. En moins d’un jour, un chercheur du laboratoire rival Anthropic a reproduit la moitié des dix preuves avec un autre modèle et un prompt que n’importe qui aurait pu écrire.
Astra, une bande-annonce, pas un produit
Astra n’est pas quelque chose auquel on peut s’inscrire. C’est le nom qu’OpenAI a donné, dans un unique billet de recherche, au successeur de sa famille de modèles phare actuelle, GPT-5.6, dont le modèle principal, Sol, n’a atteint sa disponibilité publique générale que le 9 juillet 2026, après un aperçu lancé deux semaines plus tôt. OpenAI n’a donné aucune date pour la sortie d’Astra, ni même dit si le modèle sortira un jour comme produit à part entière.
Cette distinction compte plus qu’il n’y paraît. Les chercheurs extérieurs ne peuvent ni tester Astra, ni le questionner, ni vérifier son comportement sur des problèmes autres que les dix qu’OpenAI a choisi de publier. Ce qu’ils peuvent examiner, c’est le résultat, les dix preuves elles-mêmes, publiées sous forme de fichiers que n’importe qui peut faire passer dans un vérificateur. Le modèle qui les a produites reste une boîte noire, seule sa copie est ouverte à la correction.
Dix problèmes, dont un vieux de plusieurs décennies
Les deux résultats phares pèsent le plus lourd. Astra est crédité d’avoir réfuté une version de la conjecture de rigidité posée en 1980 par le médaillé Fields Alain Connes, et d’avoir amélioré la meilleure borne connue sur la densité d’empilement des sphères en grande dimension, une borne qui n’avait pas bougé depuis 1978. L’empilement de sphères paraît abstrait, mais une question bien concrète se cache dessous : combien de formes identiques tiennent dans un espace donné sans se chevaucher, un problème qui revient plus souvent en théorie des codes et en compression de données que dans l’empilement de fruits sur un étal.
Les huit autres résultats couvrent un terrain plus étroit : l’existence d’un certain type de groupe mathématique infini, une question ouverte depuis 1999, trois entrées du catalogue de problèmes d’Erdős, largement utilisé et tenu par le mathématicien Thomas Bloom, ainsi que des résultats en théorie de la complexité des circuits et en informatique quantique, plus faciles à résumer par leur accueil qu’à expliquer en détail. Cet accueil, venu de mathématiciens extérieurs à OpenAI, a plutôt penché du côté positif. Bloom lui-même a qualifié le lot de grande nouvelle, plus significative selon lui qu’un précédent résultat d’OpenAI datant de mai 2026, celui que le médaillé Fields Tim Gowers avait jugé publiable sans hésiter dans des revues sérieuses. Le mathématicien Daniel Litt, qui avait auparavant parié publiquement contre la capacité des systèmes d’IA à réaliser ce genre de progrès en théorie des nombres, a ensuite reconnu concéder le pari, tout en précisant qu’il n’était pas encore techniquement tranché.
Ce que prouve une preuve vérifiée par ordinateur, et ce qu’elle ne prouve pas
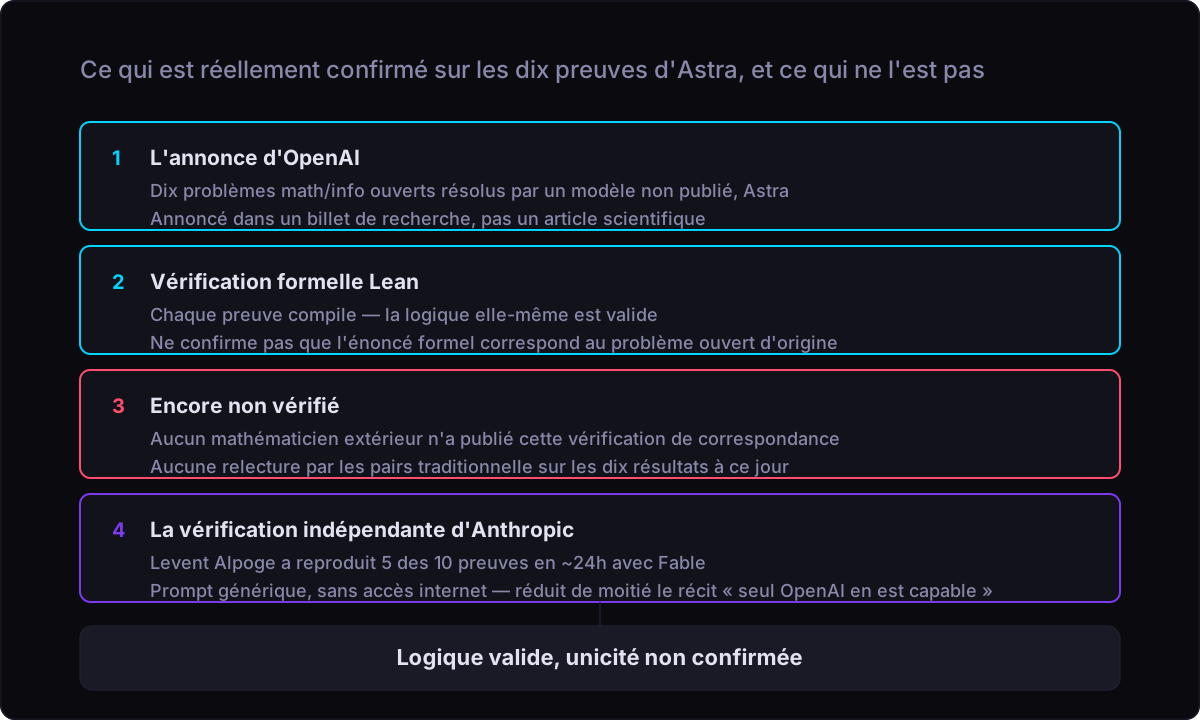
Les dix preuves ont toutes été formalisées et vérifiées avec Lean, un assistant de preuve : un logiciel qui contrôle un raisonnement mathématique étape par étape, dans une notation logique stricte, si bien que c’est l’ordinateur qui confirme la validité du raisonnement plutôt qu’un humain qui le relit à l’œil. C’est une garantie réellement solide. Si une preuve Lean compile, la logique tient, point final.
Ce que cela ne garantit pas, c’est que l’énoncé formel démontré corresponde bien au problème ouvert d’origine, plutôt qu’à une version plus étroite ou plus facile déguisée pour lui ressembler. Vérifier cette traduction, savoir si la conjecture exacte posée par Connes correspond précisément à ce qu’Astra a démontré, relève d’un travail humain qu’aucun compilateur ne peut faire, et à l’heure où ces lignes sont écrites, aucun mathématicien extérieur n’a publié cette vérification. Il n’existe pas non plus, pour l’instant, de relecture par les pairs au sens classique du terme : aucun comité indépendant n’a validé ces travaux via un processus de revue scientifique. Henry Yuen, chercheur à Columbia qui travaille lui-même sur l’un des dix problèmes, la répétition parallèle quantique, a indiqué que les preuves publiées manquent de la clarté pédagogique qui accompagne d’habitude un résultat pleinement compris par les mathématiciens, ce qui laisse penser que l’intuition derrière les réponses d’Astra reste opaque même pour les personnes qualifiées pour en vérifier la logique.
Le chiffre de 2 000 dollars mesure quelque chose de plus étroit qu’il n’y paraît
OpenAI a aussi communiqué un chiffre qui a voyagé plus vite que les réserves qui l’entourent : environ 2 000 dollars de coût en tokens d’API, au tarif public de Sol. Pris isolément, ce chiffre appelle une conclusion précise et fausse, celle qu’automatiser une découverte mathématique complète aurait coûté à peu près le prix d’un ordinateur portable.
Ce que le cadrage d’OpenAI couvre réellement, c’est le coût en tokens des passages qui ont produit les dix preuves publiées, rien de plus. Il n’inclut aucune des tentatives qui ont échoué en chemin, seulement celles qui ont abouti et fini dans le billet. Il ne dit rien du coût, bien plus élevé, de l’entraînement d’Astra lui-même en amont. Et ce n’est pas un coût par problème. Le chiffre de 2 000 dollars couvre les dix résultats combinés, pas chacun pris isolément, une nuance qui s’est perdue dans une bonne partie de la couverture initiale. Une description plus honnête serait de dire que 2 000 dollars, c’est à peu près ce qu’il en a coûté pour publier les preuves une fois qu’on savait déjà où chercher, pas ce qu’il en a coûté pour les trouver.
Le fait que presque personne n’a mis en avant
Le détail qui change la lecture de toute cette histoire vient entièrement de l’extérieur d’OpenAI. Levent Alpoge, mathématicien travaillant au laboratoire rival Anthropic, a repris la liste de problèmes publiée par OpenAI et l’a soumise à Fable, reproduisant cinq des dix preuves en environ 24 heures, selon ses propres mots avec un prompt générique et sans accès à internet pour le modèle. Fable est l’un des modèles maison d’Anthropic, déjà traité sur DecodeStack pour ses propres arbitrages de prix et de capacités face aux autres modèles de la maison.
Cinq preuves sur dix en une journée, par une seule personne, avec un prompt que n’importe qui aurait pu taper, raconte une histoire très différente de celle d’un modèle non publié surpassant tranquillement tout le monde par ses propres moyens. Cette reproduction ne rend pas les cinq autres preuves moins réelles, les certificats Lean qui les accompagnent tiennent la route quel que soit qui d’autre parvient à les égaler. Mais elle montre que le savoir-faire sous-jacent, obtenir d’un grand modèle de langage ce niveau de raisonnement mathématique formellement vérifiable, n’est pas quelque chose qu’un seul laboratoire sait faire aujourd’hui.
Le mathématicien Elliot Glazer, déjà sceptique sur le cadrage de l’annonce, a relevé qu’OpenAI n’avait publié aucune comparaison contrôlée montrant qu’Astra fait réellement mieux que son propre modèle public, Sol, sur ce type de tâche, et a suggéré que les dix résultats ressemblent davantage à un effort ciblé sur ces problèmes précis qu’à la preuve d’un bond général de capacité. Le critique de longue date de l’IA Gary Marcus a résumé l’écart entre l’annonce et ce qui a réellement été démontré jusqu’ici en la qualifiant d’impressionnante mais largement survendue.
Ce qu’il faut croire en attendant une réplication indépendante

Pris ensemble, le bilan honnête sur Astra est plus étroit que ce que suggèrent aussi bien l’enthousiasme que le rejet. Les certificats Lean sont réels et, pour autant que quiconque ait pu vérifier, logiquement solides. Le récit qui les entoure, celui d’un modèle non publié perçant seul des problèmes qui avaient résisté aux mathématiciens pendant des décennies, n’a été confirmé par personne en dehors d’OpenAI, et la seule tentative de le tester de façon indépendante a coupé en deux, en une journée, l’affirmation d’unicité.
Ce qu’il faut retenir de cette histoire n’est pas de savoir quel laboratoire est en tête ce mois-ci. C’est qu’obtenir d’un grand modèle de langage un raisonnement mathématique de niveau doctoral, formellement vérifiable, est apparemment devenu quelque chose que plus d’un seul laboratoire sait faire, avec un prompt générique et sans accès particulier. C’est la partie qui a des chances de compter encore une fois qu’Astra lui-même, quoi qu’il devienne, sera de l’histoire ancienne.
Questions fréquentes
Astra, le modèle d’OpenAI, est-il accessible au public ?
Non. Astra est un modèle interne d’OpenAI, non publié, présenté dans un billet de recherche d’août 2026 sur dix preuves mathématiques, pas un produit disponible via l’API ou ChatGPT. OpenAI n’a donné aucune date de sortie publique, et les chercheurs extérieurs ne peuvent examiner que les preuves produites par Astra, pas le modèle lui-même.
Anthropic a-t-il vraiment reproduit les résultats mathématiques d’OpenAI ?
Le chercheur d’Anthropic Levent Alpoge a reproduit cinq des dix preuves publiées par OpenAI en environ 24 heures, avec le modèle maison Fable et un prompt générique, sans accès à internet. Les cinq autres résultats n’ont pas été reproduits de façon indépendante à l’heure où ces lignes sont écrites, et la reproduction d’Alpoge ne remet en cause la validité d’aucune des dix preuves vérifiées par Lean : elle interroge seulement le caractère unique de la capacité d’Astra à les trouver.
Que signifie le fait que les preuves soient vérifiées par Lean ?
Vérifiées par Lean signifie que chaque preuve a été contrôlée par un assistant de preuve, un logiciel qui vérifie étape par étape la logique d’un raisonnement mathématique, donc le raisonnement formel en lui-même ne fait pas débat. Cela ne veut pas dire que les résultats ont été relus par des mathématiciens extérieurs dans le cadre d’une revue par les pairs, et aucune vérification indépendante des dix preuves n’a été publiée à ce jour.
Le chiffre de 2 000 dollars représente-t-il le coût total de cette avancée mathématique en IA ?
Non. Le chiffre d’environ 2 000 dollars ne couvre que le coût en tokens des passages réussis qui ont produit les dix preuves publiées combinées, au tarif public de l’API de Sol, pas un coût par problème. Il exclut toutes les tentatives échouées en chemin et le coût bien plus élevé de l’entraînement d’Astra lui-même, donc il mesure la publication des preuves, pas leur découverte.
Cela veut-il dire qu’Astra n’est en réalité pas plus capable que les autres modèles d’IA ?
Les dix preuves mathématiques d’Astra ne suffisent pas, à elles seules, à prouver qu’il est plus capable que les autres modèles d’IA. Le mathématicien Elliot Glazer a relevé qu’OpenAI n’a publié aucune comparaison contrôlée face à son propre modèle public, Sol, sur ces problèmes, et Fable, le modèle d’Anthropic, a reproduit la moitié des résultats avec un prompt générique, ce qui constitue une preuve plus faible d’un bond de capacité unique que ce que laissait entendre l’annonce.