Claude Opus 5 : moitié prix au token, ce que ça donne sur la facture
Claude Opus 5 est facturé moitié moins que Fable 5 au token. Deux testeurs ont suivi leur facture en dollars : l'écart réel se rapproche d'un tiers.
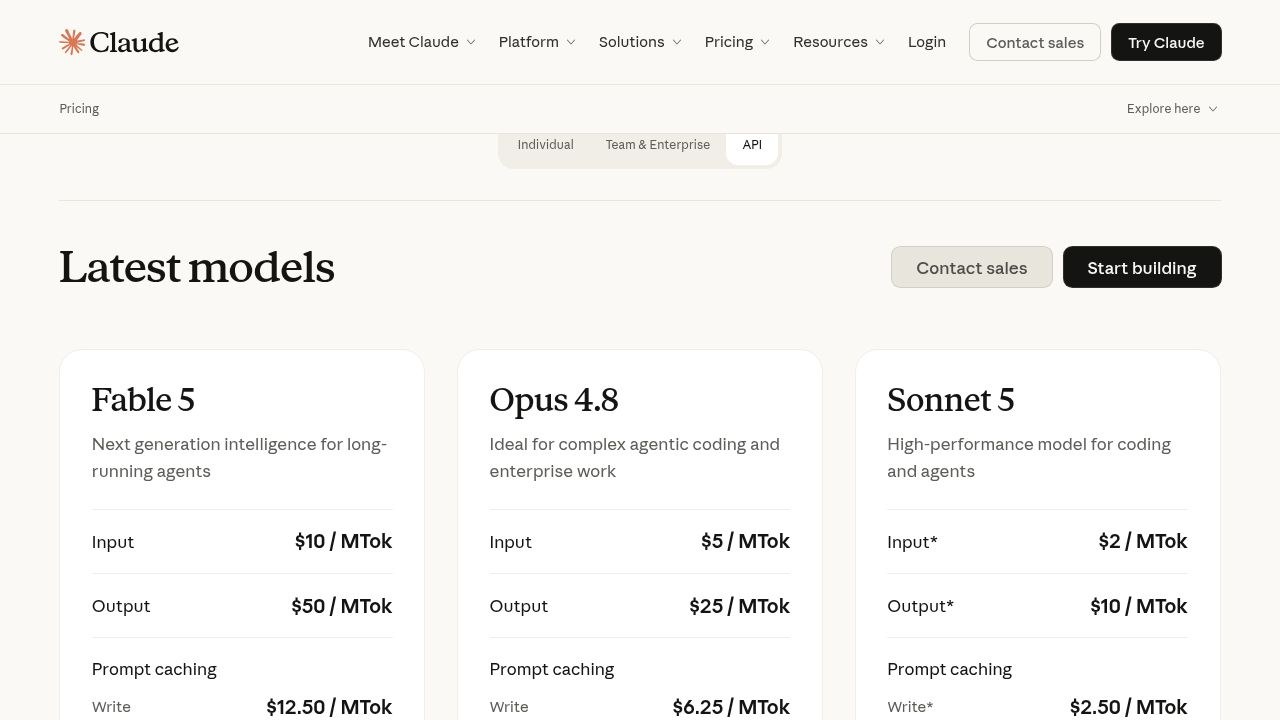
Anthropic a mis Claude Opus 5 en ligne le 24 juillet 2026, au tarif de 5 $ par million de tokens en entrée et 25 $ par million en sortie, soit environ la moitié de ce que coûte Fable 5, son modèle le plus performant. Un token est l’unité à laquelle un modèle d’IA facture son travail, à peu près les trois quarts d’un mot. Sur ses propres benchmarks, ces tests standardisés qui servent à comparer les modèles, Opus 5 arrive tout près du plafond de Fable 5 à ce tarif réduit : c’est le titre qu’a repris l’essentiel de la couverture du jour. Reste une question que les graphiques de lancement ne tranchent pas : ce que le modèle coûte réellement à faire tourner.
Ce qu’Anthropic a mis sur la table
Opus 5 est disponible tout de suite sur Claude.ai, dans Claude Code, l’outil de codage maison d’Anthropic, dans son produit Cowork, et via l’API, la porte d’entrée technique des développeurs. Il devient le modèle par défaut du plan Claude Max et l’option la plus puissante du plan Claude Pro. À ne pas confondre avec Opus 4.8, son prédécesseur direct facturé aux mêmes 5 $ et 25 $, dont il se présente comme la relève sans surcoût. Ni avec Mythos 5, un modèle à part réservé à un cercle restreint de partenaires validés, qu’Anthropic dit toujours devant Opus 5 pour repérer et exploiter des failles logicielles.
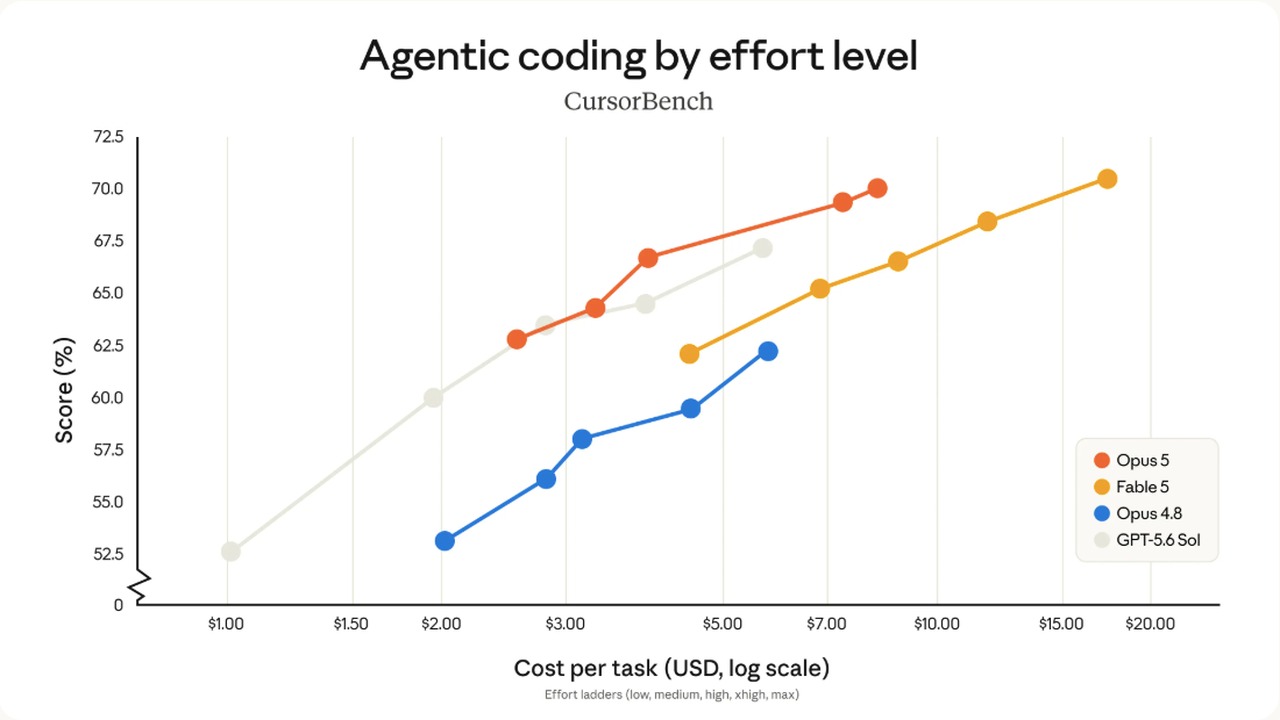
Face à Fable 5, l’argument tient en une phrase : presque les mêmes résultats pour moins cher. Sur CursorBench 3.2, un test de codage, Opus 5 se place à 0,5 % du meilleur score de Fable 5 pour moitié moins de coût par tâche. Sur OSWorld 2.0, un test où le modèle pilote un ordinateur comme un utilisateur, il dépasse le meilleur résultat de Fable 5 pour un peu plus du tiers du coût. Sa mémoire de travail, la quantité de texte qu’il garde en tête dans une même conversation, monte à 1 million de tokens, par défaut comme au plafond, d’après la documentation développeurs d’Anthropic. Un mode rapide existe aussi, environ 2,5 fois plus véloce, au double du prix de base.
Anthropic présente aussi un volet sécurité à côté du saut de capacité. Opus 5 obtient 2,3 à l’audit interne de la maison sur les comportements mal alignés, son meilleur résultat à ce jour, c’est-à-dire le plus bas, puisque cette échelle compte les écarts de conduite. Ses classifieurs de cybersécurité, les filtres qui bloquent une demande jugée offensive, interviennent environ 85 % moins souvent que sur Fable 5. Un changement d’aiguillage accompagne le lancement : les demandes touchant à la biologie que Fable 5 refuse aujourd’hui partent désormais vers Opus 5 plutôt que vers Opus 4.8, le nouveau modèle embarquant les mêmes garde-fous que l’ancien tout en obtenant de meilleurs scores ailleurs. Deux fonctions restent en bêta : le changement d’outils en cours de conversation sur la Claude Platform, qui laisse un développeur changer d’outils sans invalider le cache du prompt, et les bascules automatiques sur l’API, qui réorientent une demande signalée par les filtres vers un autre modèle au lieu de la refuser.
Ce que deux testeurs ont mesuré sur leur propre facture
Ces chiffres de benchmarks sont ceux d’Anthropic, relevés sur un test figé : ils décrivent un coût par tâche, pas une facture de fin de mois sur une charge de travail réelle. Deux personnes ont suivi leur propre dépense réelle, chacune de son côté, pas un benchmark contrôlé, et ont mis un chiffre sur l’écart.
Erwan a mené un test contrôlé l’après-midi même de la sortie : le même prompt de création d’application, une fois avec la consigne explicite de bien vérifier son travail, une fois sans. La version avec consigne a demandé 5 minutes de plus et produit 15 relectures supplémentaires, pour un résultat quasiment identique. Sur l’ensemble de sa série de tests, il relève un coût réel environ un tiers moins élevé que Fable 5, et non la moitié que laisse attendre la grille tarifaire.
Nate Herk a poussé l’exercice plus loin : 8 à 10 tâches réelles comparables dans Claude Code, de la chasse aux bugs au plan d’une vidéo promotionnelle, avec les coûts en dollars relevés pour les deux modèles. Au total, il compte 2 millions de tokens de sortie pour Opus 5 contre 832 000 pour Fable 5, soit environ 2,4 fois plus, et 60 minutes de session en moyenne contre 25. Sur une tâche, un simulateur de calcul de structure, Opus 5 a terminé en 2 heures 26 pour 112 $, quand Fable 5 rendait le même travail en 7 minutes pour 73 $. Aucun des deux résultats n’est un benchmark contrôlé, Herk le précise lui-même, mais les deux relèvent le même schéma : un prix au token divisé par deux ne s’est pas traduit automatiquement par une facture divisée par deux.
Le guide d’Anthropic explique le mécanisme
Anthropic documente elle-même le comportement à l’origine de cet écart. Son guide de prompting officiel pour Opus 5, le mode d’emploi des consignes à donner au modèle, indique noir sur blanc qu’il « vérifie son propre travail sans qu’on le lui demande ». Si un prompt traîne encore une vieille instruction du type « ajoute une étape de vérification finale » ou « fais relire par un sous-agent », le guide recommande de la retirer : ce genre de ligne « provoque une sur-vérification sur Claude Opus 5, et la supprimer réduit les tokens gaspillés sans perte de qualité ». Beaucoup d’équipes font tourner un harnais, cet assemblage d’instructions et d’outils qui encadre le modèle, ou une bibliothèque de prompts maison où traîne exactement ce type de consigne, ajoutée pour un modèle plus ancien et moins méticuleux, jamais relue depuis.
Le même document sépare deux choses que l’on confond volontiers : le réglage d’effort, un curseur de bas à extra-élevé qui décide de la quantité de réflexion avant la réponse, et la longueur de ce que le modèle écrit ensuite. Baisser l’effort réduit bien le raisonnement, écrit Anthropic, mais « peut réduire le volume de réflexion sans raccourcir de façon fiable la réponse visible ». C’est ce qu’Erwan a constaté sur une simple question factuelle : 386 mots et 23 secondes en réglage par défaut, un tiers de cela une fois ajoutée la consigne de répondre en cinq lignes maximum. La longueur d’une réponse se demande explicitement ; le curseur d’effort seul ne la raccourcit pas.
Le guide pointe une seconde habitude qui coûte de l’argent sans faire de bruit. Opus 5 confie plus volontiers qu’avant une partie du travail à des sous-agents, des copies de lui-même lancées en parallèle sur un morceau de la tâche. La recommandation d’Anthropic est de brider ce réflexe : la délégation est rentable sur de gros chantiers réellement indépendants et multiplie le coût et le temps quand on l’applique à de petites tâches.
Là où la remise tient
La différence colle à la description qu’Anthropic donne de son propre modèle. Le surcoût apparaît sur les travaux qui bouclent, qui itèrent, ou qui demandent au modèle de se contrôler et de se recontrôler, précisément la forme des tests de Herk et d’Erwan. Par la même logique, une génération propre, en un seul passage, sans rien à recouper, ne devrait pas déclencher ce comportement. La remise a de bonnes chances de tenir sur une construction directe et de s’éroder dès que la tâche repasse par de la relecture.
Récupérer le prix annoncé
Trois ajustements, tous tirés des recommandations d’Anthropic, referment l’essentiel de l’écart.
Supprimez les consignes de vérification permanentes. Une ligne « vérifie bien » ou « fais relire par un sous-agent » oubliée dans un system prompt, ces instructions permanentes posées en tête de conversation, ou dans un harnais maison, joue désormais contre vous. Opus 5 fait déjà cette étape de lui-même.
Ajoutez une consigne de longueur si vous voulez des réponses plus courtes. L’effort règle la profondeur du raisonnement, pas le nombre de mots. Une ligne suffit là où le curseur ne peut rien, et la formulation que suggère Anthropic est : « garde des réponses ciblées, brèves et concises ».
Descendez plus souvent sur un effort bas ou moyen. Anthropic conseille d’employer ces réglages « largement », comme premier levier de coût et de vitesse, et de garder le niveau maximal pour les travaux de codage et d’agent réellement exigeants plutôt que d’en faire un défaut partout, le même levier qui avait refermé l’essentiel de l’écart entre Sonnet 5 et Opus 4.8.

À retenir
Opus 5 est un vrai progrès de capacité et de sécurité à prix inchangé, et sa comparaison à moitié prix avec Fable 5 tient sur les benchmarks d’Anthropic. Ce qu’il n’apporte pas automatiquement, c’est une baisse équivalente sur votre propre facture : Claude Opus 5 vérifie son travail par défaut, un gain bien réel qui consomme aussi des tokens dont le prix affiché ne tient pas compte. Récupérer la remise annoncée dépend moins du modèle choisi que de savoir si vos prompts sont encore écrits pour l’ancien.
Questions fréquentes
Claude Opus 5 est-il vraiment moins cher que Fable 5 ?
Claude Opus 5 est facturé moitié moins que Fable 5 au token, en entrée comme en sortie. En pratique, deux créateurs indépendants ont mesuré une économie réelle plus proche d’un tiers, et l’une des tâches testées a fini par coûter plus cher en dollars malgré le tarif inférieur, parce que le modèle a consommé beaucoup plus de tokens pour y arriver.
Pourquoi Opus 5 consomme-t-il plus de tokens que prévu ?
Le guide de prompting officiel d’Anthropic indique que Claude Opus 5 vérifie son propre travail sans qu’on le lui demande, un comportement inscrit dans le modèle et non une erreur de prompt. Une consigne oubliée du type « vérifie » ou « ajoute une relecture » aggrave le phénomène, puisque cette étape a déjà lieu par défaut.
Baisser le réglage d’effort réduit-il le coût d’Opus 5 ?
Baisser le réglage d’effort de Claude Opus 5 ne réduit le coût qu’en partie. Ce curseur décide de la quantité de réflexion interne, pas de la longueur de la réponse visible, donc un réglage plus bas ne raccourcit pas forcément un texte bavard. Anthropic recommande de l’accompagner d’une consigne explicite de concision.
Quand Claude Opus 5 reste-t-il proche de son prix annoncé ?
Claude Opus 5 reste proche de son prix annoncé sur des tâches bien cadrées, en un seul passage, sans boucle de vérification intégrée, comme générer un site ou un document complet d’un coup. Le surcoût se concentre sur le travail itératif, en plusieurs étapes, ou tourné vers la relecture.
Qu’est-ce qui change dans Claude Opus 5 en dehors du prix ?
Au-delà du tarif aligné sur Opus 4.8, Claude Opus 5 affiche un meilleur score à l’audit interne d’Anthropic sur les comportements mal alignés et bien moins d’interventions de ses filtres de cybersécurité que Fable 5, avec un aiguillage qui lui envoie, plutôt qu’à Opus 4.8, les demandes de biologie bloquées sur Fable 5. Deux fonctions restent en bêta : le changement d’outils en cours de conversation et les bascules automatiques d’un modèle à l’autre.