Claude Opus 5 Kosten: halber Preis auf dem Papier, nicht immer halbe Rechnung
Claude Opus 5 kostet pro Token halb so viel wie Fable 5. Zwei Tester haben ihre echte Rechnung in Dollar verfolgt: Der Rabatt landet eher bei einem Drittel.
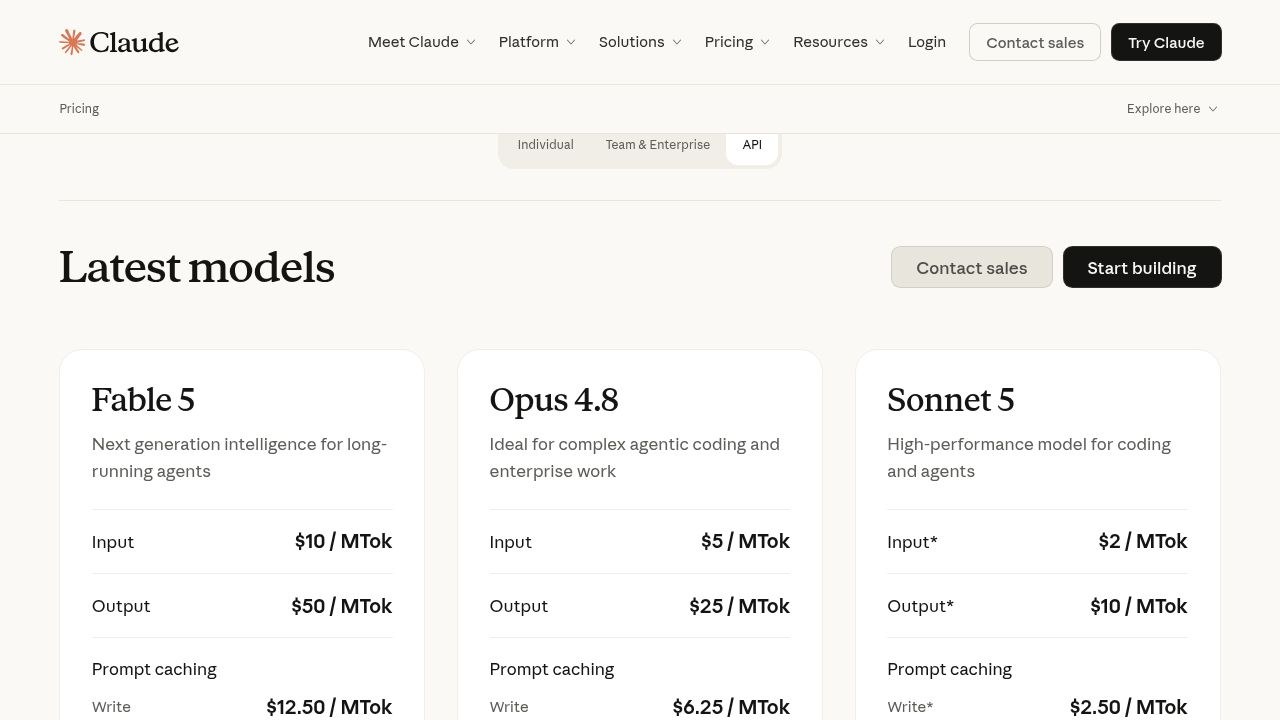
Claude Opus 5 ist am 24. Juli 2026 erschienen, zu 5 Dollar pro Million Input-Token und 25 Dollar pro Million Output-Token, also ungefähr der Hälfte dessen, was Anthropic für Fable 5 verlangt, sein leistungsfähigstes Modell. Ein Token ist die grobe Abrechnungseinheit eines KI-Modells und entspricht etwa drei Vierteln eines Wortes. In den Benchmarks, die Anthropic selbst gefahren hat, kommt Opus 5 zu diesem niedrigeren Tarif nah an die Bestwerte von Fable 5 heran, und genau diese Schlagzeile hat der Großteil der Berichterstattung am Erscheinungstag übernommen. Sie stimmt. Vollständig wird das Bild erst, wenn man dazunimmt, was das Modell im laufenden Betrieb tatsächlich kostet.
Was Anthropic tatsächlich ausgeliefert hat
Opus 5 ist ab sofort verfügbar: in Claude.ai, in Anthropics Coding-Werkzeug Claude Code, im Produkt Cowork und über die API, also die Programmierschnittstelle für eigene Anwendungen. Im Tarif Claude Max ist es das neue Standardmodell, in Claude Pro die stärkste verfügbare Option. Zwei Verwechslungen liegen nahe. Die erste ist Opus 4.8, der direkte Vorgänger zu denselben 5 und 25 Dollar, gegenüber dem Opus 5 als schlichtes Upgrade positioniert wird. Die zweite ist Mythos 5, ein separates Modell für einen kleinen Kreis geprüfter Partner, das laut Anthropic beim Auffinden und Ausnutzen von Software-Schwachstellen weiterhin vor Opus 5 liegt.
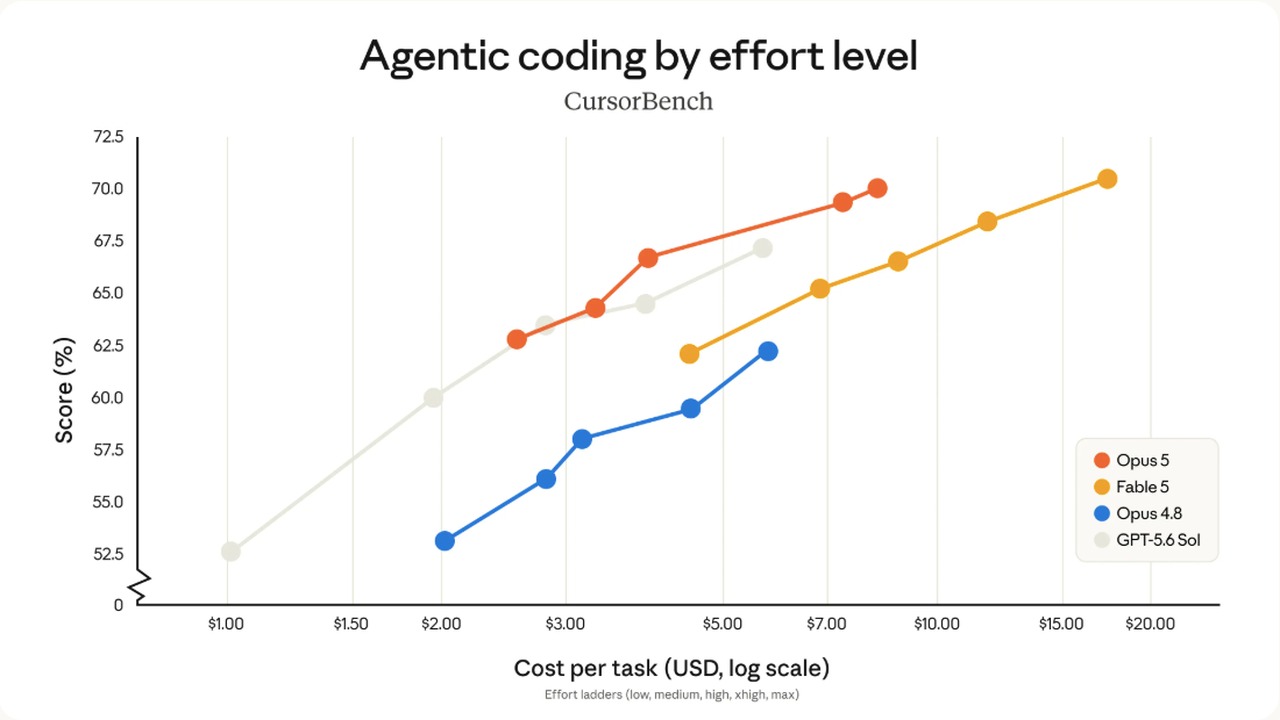
Gegenüber Fable 5 lautet das Versprechen: nahezu dieselbe Leistung für weniger Geld. Im Coding-Benchmark CursorBench 3.2, also einem standardisierten Testlauf, mit dem sich Modelle miteinander vergleichen lassen, landet Opus 5 innerhalb von 0,5 % des Spitzenwerts von Fable 5, und das bei halben Kosten pro Aufgabe. In OSWorld 2.0, einem Test zur eigenständigen Bedienung eines Computers, schlägt es das beste Ergebnis von Fable 5 sogar, für gut ein Drittel der Kosten. Das Arbeitsgedächtnis, also die Textmenge, die das Modell in einem einzigen Gespräch gleichzeitig halten kann, liegt laut Anthropics Entwicklerdokumentation bei 1 Million Token, in der Voreinstellung wie im Maximum. Dazu kommt ein schnellerer Betriebsmodus, der etwa das 2,5-Fache des Standardtempos erreicht und den doppelten Grundpreis kostet.
Neben dem Leistungssprung meldet Anthropic auch Fortschritte bei der Sicherheit. Opus 5 erreichte im internen Audit auf fehlgeleitetes Verhalten einen Wert von 2,3, den niedrigsten und damit besten, den das Unternehmen bislang gemessen hat, und seine Klassifikatoren für Cybersicherheit, also die Filter, die heikle Anfragen abfangen, greifen rund 85 % seltener ein als bei Fable 5. Eine Änderung beim Zugriff kommt direkt mit dem Start: Anfragen zu biologischen Themen, die Fable 5 derzeit ablehnt, laufen künftig über Opus 5 statt über Opus 4.8, weil Opus 5 dieselben Schutzmaßnahmen mitbringt wie Opus 4.8 und in der allgemeinen Leistung besser abschneidet. Zwei Funktionen bleiben vorerst in der Beta-Phase: der Werkzeugwechsel mitten im Gespräch auf der Claude Platform, mit dem Entwickler austauschen können, welche Werkzeuge Claude benutzen darf, ohne den Prompt-Cache zu entwerten, also den Zwischenspeicher, der wiederkehrende Anweisungen billiger macht, und automatische Ausweichmodelle über die API, die eine sicherheitsmarkierte Anfrage an ein anderes Modell weiterreichen, statt sie schlicht abzulehnen.
Was zwei unabhängige Tester in Dollar gemessen haben
Diese Benchmark-Werte stammen von Anthropic selbst und wurden in einem festen Testlauf erhoben. Sie beschreiben Kosten pro Aufgabe, nicht Kosten pro Monat bei echter Arbeit. Zwei Leute haben ihre eigenen realen Ausgaben verfolgt, jeder für sich, kein kontrollierter Benchmark, und daraus eine Zahl für die Lücke gemacht.
Erwan hat noch am Nachmittag des Erscheinungstags einen kontrollierten Test gefahren: derselbe Prompt zum Bau einer App, also dieselbe Arbeitsanweisung an das Modell, einmal mit dem ausdrücklichen Zusatz „prüfe deine Arbeit“ und einmal ohne. Der Durchlauf mit Zusatz brauchte 5 Minuten länger und produzierte 15 zusätzliche Selbstprüfungen, bei praktisch identischem Ergebnis. Über seine gesamte Testreihe hinweg hat Erwan als realen Kostenvorteil rund ein Drittel gegenüber Fable 5 gemessen, nicht die Hälfte, die die Preisliste nahelegt.
Nate Herk hat breiter getestet: 8 bis 10 vergleichbare echte Aufträge in Claude Code, von der Fehlersuche bis zum Konzept für ein Werbevideo, mit protokollierten Dollarbeträgen für beide Modelle. Zusammengerechnet hat Nate Herk für Opus 5 insgesamt 2 Millionen Output-Token gezählt, gegenüber 832.000 bei Fable 5, also rund das 2,4-Fache, bei einer durchschnittlichen Laufzeit von 60 Minuten pro Sitzung statt 25. Bei einem Auftrag, einem Simulator für Tragwerksplanung, war Opus 5 nach 2 Stunden 26 Minuten fertig und kostete 112 Dollar, während Fable 5 dieselbe Vorgabe in 7 Minuten für 73 Dollar erledigte. Keines der beiden Ergebnisse ist ein kontrollierter Benchmark, Herk sagt das selbst dazu, aber beide zeigen dasselbe Muster: Ein niedrigerer Preis pro Token schlug sich nicht automatisch in einer niedrigeren Rechnung nieder.
Anthropics eigener Leitfaden erklärt den Grund
Das Verhalten hinter dieser Lücke dokumentiert Anthropic selbst. Im offiziellen Prompting-Leitfaden zu Opus 5 steht unmissverständlich, das Modell „überprüft seine eigene Arbeit, ohne dass man es ihm sagt“. Trägt ein Prompt noch eine alte Anweisung wie „füge einen abschließenden Prüfschritt ein“ oder „lass einen Subagenten das gegenlesen“, soll man sie laut Leitfaden streichen. Solche Anweisungen „führen bei Claude Opus 5 zu Überprüfung im Übermaß, und wer sie entfernt, spart verschwendete Token, ohne an Qualität zu verlieren“, heißt es dort wörtlich. Genau solche Sätze schleppen die meisten Teams mit, die ein KI-Harness betreiben, also die Gerüstschicht, die Prompts, Werkzeuge und Modell zusammenhält, oder die eine eigene Prompt-Bibliothek pflegen. Eingebaut wurden sie irgendwann für ein älteres, weniger sorgfältiges Modell, und seither hat sie niemand mehr angefasst.
Derselbe Text trennt zwei Dinge, die gern verwechselt werden: die Einstellung Effort, ein Regler von niedrig bis extra hoch, der steuert, wie ausführlich das Modell vor der Antwort nachdenkt, und die Länge dessen, was am Ende tatsächlich herauskommt. Effort herunterzudrehen kürzt das Nachdenken, schreibt Anthropic, „kann aber das Denkvolumen senken, ohne die sichtbare Antwort zuverlässig zu verkürzen“. Das deckt sich mit dem, was Erwan bei einer schlichten Faktenfrage beobachtet hat: 386 Wörter und 23 Sekunden in der Voreinstellung, ein Drittel davon, sobald er ausdrücklich um eine Antwort in höchstens fünf Zeilen bat. Die Antwortlänge musst du direkt anfordern, der Effort-Regler allein erledigt das nicht.
Der Leitfaden benennt eine zweite Gewohnheit, die still Geld kostet. Opus 5 gibt Arbeit bereitwilliger an Subagenten ab als frühere Modelle, also an Kopien seiner selbst, die einen Teil des Auftrags parallel abarbeiten. Anthropics Rat dazu ist, das zu deckeln: Delegation rechnet sich bei großen, voneinander unabhängigen Arbeitssträngen und vervielfacht Kosten und Zeit, sobald man sie auf kleine Aufgaben anwendet.
Wo der Rabatt tatsächlich hält
Der Unterschied passt zu Anthropics eigener Beschreibung des Modells. Die Mehrkosten entstehen bei Aufgaben, die in Schleifen laufen, iterieren oder das Modell zum Nachprüfen und Nochmal-Prüfen auffordern, also genau bei dem Zuschnitt, den die Tests von Herk und Erwan hatten. Nach derselben Logik sollte eine saubere Erzeugung in einem Durchgang, ohne etwas zum Gegenprüfen, dieses Verhalten nicht auslösen. Der Rabatt dürfte beim geradlinigen Bauen halten und bei allem bröckeln, was noch einmal durch eine Prüfschleife läuft.
So bekommst du den angekündigten Preis zurück
Drei Änderungen, alle auf Anthropics eigene Empfehlungen zurückführbar, schließen den größten Teil der Lücke.
Stehende Prüfanweisungen streichen. Jede Zeile im Sinne von „prüfe deine Arbeit“ oder „lass das von einem Subagenten gegenlesen“, die in einem System-Prompt oder einem selbstgebauten Harness übrig geblieben ist, arbeitet inzwischen gegen dich statt für dich. Opus 5 macht diesen Schritt schon von selbst.
Eine explizite Kürze-Anweisung hinzufügen, wenn du kürzere Antworten willst. Effort steuert die Tiefe des Nachdenkens, nicht die Wortzahl. Eine einzige kurze Zeile schafft, woran der Regler scheitert, und Anthropic schlägt dafür die Formulierung vor: „Halte Antworten fokussiert, kurz und knapp.“
Häufiger zu niedrigem oder mittlerem Effort greifen. Anthropic empfiehlt, diese Stufen „großzügig“ einzusetzen, als wichtigsten Hebel für Kosten und Tempo, und die höchste Stufe wirklich anspruchsvoller Agenten- und Coding-Arbeit vorzubehalten, statt sie überall zum Standard zu machen. Derselbe Hebel schloss schon den größten Teil des Abstands zwischen Sonnet 5 und Opus 4.8.

Das Fazit
Opus 5 ist ein echtes Upgrade bei Fähigkeit und Sicherheit, und das zum unveränderten Preis; der Vergleich mit dem halben Tarif von Fable 5 hält in Anthropics eigenen Benchmarks stand. Was daraus nicht automatisch folgt, ist eine im gleichen Maß kleinere Rechnung. Claude Opus 5 prüft seine Arbeit standardmäßig selbst, ein echter Zugewinn, der eben auch Token kostet, die im ausgewiesenen Preis nicht eingerechnet sind. Ob du den angekündigten Rabatt einstreichst, hängt weniger davon ab, welches Modell du wählst, als davon, ob deine Prompts noch vom alten ausgehen.
Häufige Fragen
Ist Claude Opus 5 wirklich günstiger als Fable 5?
Claude Opus 5 kostet pro Token die Hälfte dessen, was Anthropic für Fable 5 verlangt, bei Input wie bei Output. In der Praxis haben zwei unabhängige Tester eine reale Ersparnis gemessen, die eher bei einem Drittel lag, und eine Aufgabe kam trotz des niedrigeren Tarifs in Dollar teurer heraus, weil Opus 5 dafür deutlich mehr Token verbraucht hat.
Warum verbraucht Claude Opus 5 mehr Token als erwartet?
Claude Opus 5 prüft seine eigene Arbeit, ohne dass man ihn darum bittet. So steht es in Anthropics eigenem Prompting-Leitfaden: Das Verhalten ist im Modell angelegt und kein Fehler in deiner Anweisung. Alte Anweisungen, die zum Prüfen oder Gegenlesen auffordern, verschärfen das, weil das Modell diesen Schritt ohnehin schon geht.
Senkt ein niedrigerer Effort-Wert die Kosten von Claude Opus 5?
Ein niedrigerer Effort-Wert senkt die Kosten von Claude Opus 5 nur zum Teil. Effort steuert, wie viel das Modell intern nachdenkt, nicht wie lang die sichtbare Antwort ausfällt, eine niedrigere Stufe allein schrumpft also keine ausufernde Antwort. Anthropic empfiehlt, sie mit einer ausdrücklichen Anweisung zur Kürze zu kombinieren.
Wann bleibt Claude Opus 5 nah am angekündigten Preis?
Claude Opus 5 bleibt nah am angekündigten Preis bei klar umrissenen Aufgaben in einem Durchgang, ohne eingebaute Prüfschleife, etwa wenn eine komplette Website oder ein ganzes Dokument in einem Rutsch entsteht. Die Mehrkosten sammeln sich stattdessen bei iterativer, mehrstufiger oder prüflastiger Arbeit.
Was hat sich in Claude Opus 5 außer dem Preis noch geändert?
Über den gleichen Preis wie Opus 4.8 hinaus bringt Claude Opus 5 einen niedrigeren internen Auditwert für fehlgeleitetes Verhalten und deutlich seltenere Eingriffe der Cybersicherheits-Klassifikatoren als Fable 5, dazu eine geänderte Weiterleitung, die bei Fable 5 blockierte Anfragen zu biologischen Themen an Opus 5 statt an Opus 4.8 schickt. Zwei Funktionen bleiben in der Beta: der Werkzeugwechsel mitten im Gespräch und automatische Ausweichmodelle.