FlashProve : la preuve d'Anthropic pour savoir quelle IA vous répond
FlashProve d'Anthropic prouve par cryptographie quel modèle d'IA a généré une réponse. Ce que ça prouve vraiment, et pourquoi ce n'est pas pour votre chatbot.
FlashProve : la preuve d’Anthropic pour savoir quelle IA vous répond
Quand un chatbot vous répond, rien ne vous permet de vérifier quel modèle a réellement généré cette réponse. L’entreprise qui l’exploite affirme faire tourner son système phare, et vous la croyez sur parole. Rien n’empêche pourtant un fournisseur de router discrètement votre question vers un modèle plus petit et moins coûteux, tout en continuant à vous facturer le tarif du modèle premium. La vérification d’identité des modèles d’IA promet justement de combler ce vide, et une nouvelle recherche d’Anthropic franchit une vraie étape dans cette direction. Pour l’instant, elle reste cependant à des années de ce qu’un utilisateur pourrait remarquer dans son usage quotidien.
Anthropic, le même laboratoire dont la décision de débrancher son propre modèle phare avait inquiété les développeurs plus tôt cette année, a publié ces travaux dans un billet de recherche le 2 novembre 2026, accompagné d’un dépôt de code ouvert baptisé FlashProve. L’annonce est réellement inédite : une méthode pour prouver mathématiquement qu’un jeu précis de poids de modèle, et aucun autre, a produit une suite précise de tokens en sortie. Le bémol, qu’Anthropic énonce elle-même sans détour, c’est que ce n’est qu’une « étape intermédiaire », pas un produit fini, et que personne, Anthropic y compris, n’a de plan pour le déployer.
Le problème : impossible de vérifier qui répond vraiment
La plupart des gens ne se posent jamais cette question, parce qu’ils n’en ont jamais vraiment besoin. Mais quelques acteurs, eux, se heurtent à ce vide bien réel. Une entreprise qui construit un produit au-dessus d’un modèle open weight tiers (un modèle dont le fabricant publie gratuitement les poids finaux, prêts à l’emploi) veut l’assurance que le fournisseur fait tourner le modèle payé, pas une version allégée qui lui coûte moins cher à faire tourner. Un auditeur indépendant qui vérifie les engagements de sécurité d’un laboratoire veut la preuve que le modèle testé est bien celui réellement déployé auprès des clients, pas une version plus propre sortie pour l’occasion. Une entreprise qui route son trafic IA via un intermédiaire, une de ces sociétés qui revendent l’accès aux modèles de différents fournisseurs, veut la confirmation que cet intermédiaire est honnête sur le modèle qu’il fait réellement tourner derrière chaque requête.
Aucune de ces inquiétudes n’est théorique. La substitution de modèle, remplacer discrètement par un modèle moins cher un produit vendu comme tournant sur le modèle phare, est un problème d’incitation bien identifié : ça fait économiser de l’argent au fournisseur, et le client ne s’en aperçoit généralement pas, parce que les modèles d’une même famille écrivent souvent de façon très semblable. Les chercheurs d’Anthropic posent le problème sans détour : « un utilisateur qui interroge un modèle aujourd’hui ne peut pas vérifier que les réponses proviennent bien du modèle précis qu’un développeur prétend faire tourner ». Jusqu’ici, il n’existait aucun moyen technique de trancher cette question. On pouvait demander gentiment au fournisseur. On ne pouvait rien prouver.
Comment la preuve fonctionne sans jamais dévoiler les poids du modèle
C’est là que FlashProve justifie son nom, et l’explication doit rester simple, car l’outil mathématique derrière est l’une des idées les plus abstraites de l’informatique, mise au service de quelque chose de très concret.
La brique de base s’appelle une preuve à divulgation nulle de connaissance (zero-knowledge proof). Imaginez que vous vouliez convaincre quelqu’un que vous connaissez la combinaison d’un coffre-fort, sans jamais la lui révéler. Une preuve à divulgation nulle permet exactement ça : l’autre personne repart convaincue, et n’a toujours aucune idée de la combinaison. La variante précise qu’utilise Anthropic s’appelle un zkSNARK, une version compacte et rapide à vérifier de cette même idée (l’acronyme désigne simplement une preuve courte, vérifiable rapidement et sans aller-retour). Pas besoin de retenir le sigle pour comprendre l’essentiel : c’est une preuve coûteuse à fabriquer, mais bon marché à contrôler.
FlashProve applique ce principe aux poids d’un modèle plutôt qu’à la combinaison d’un coffre. Le système opère en deux temps. D’abord, hors ligne, l’ensemble complet des poids du modèle, les milliards de chiffres qui définissent exactement son comportement, est compressé en un « engagement » cryptographique compact, une sorte d’empreinte infalsifiable de ce modèle précis. N’importe qui peut ensuite vérifier une réponse par rapport à cette empreinte, mais l’empreinte elle-même ne révèle rien des poids dont elle est issue. Ensuite, en ligne, à chaque fois que le modèle répond à une question, le système génère une preuve que ce jeu de poids précis, engagé à l’avance, et aucun autre, a produit cette suite précise de tokens en sortie. Un vérificateur, qui tourne sur un ordinateur ordinaire, contrôle cette preuve. Si elle passe, il peut être certain que le modèle revendiqué a bien produit cette réponse, sans jamais voir les poids du modèle ni le faire tourner lui-même.
 Le billet de recherche d’Anthropic, l’article « Progress on provable inference » où FlashProve et ses benchmarks ont été publiés.
Il faut être précis sur ce que ce n’est pas, car les deux idées se confondent facilement. Les systèmes de marquage de contenu (watermarking), comme celui que Google utilise avec SynthID, fonctionnent différemment : ils répondent à la question « cette image ou ce texte qui circule en ligne a-t-il été généré par une IA, et laquelle probablement ». FlashProve répond à une question plus étroite et plus précise : « ce modèle exact, ce jeu de poids précis, a-t-il produit ces tokens exacts ». L’un retrace un contenu jusqu’à son origine, après coup. L’autre prouve l’identité d’un modèle au moment même où il répond. Un détecteur de deepfake et FlashProve résolvent des problèmes voisins, mais différents, et rien dans FlashProve ne permet de retracer une image trouvée en ligne jusqu’à l’outil qui l’a générée.
Le prix de la preuve, et pourquoi il est volontairement élevé
Anthropic a testé FlashProve sur Llama 4 Maverick, un grand modèle open weight d’environ 400 milliards de paramètres, tournant sur un seul GPU Nvidia H100, l’une des puces haut de gamme utilisées dans les data centers pour l’IA. Les résultats, publiés dans le billet d’Anthropic, sont la façon la plus claire de comprendre le compromis que fait cette recherche.
La génération de la preuve tournait à environ 110 tokens par seconde côté « prouveur ». Une preuve couvrant une fenêtre de 1024 tokens pesait environ 19 mégaoctets, et la vérifier prenait environ 17 secondes sur un ordinateur ordinaire à 24 cœurs, sans matériel spécial côté vérification. Au total, générer une réponse prouvable coûte 70 à 95 fois plus de temps de calcul que faire tourner le même modèle normalement via une inférence standard.
Ce surcoût n’est pas un bug à corriger au prochain trimestre. Il est proche du coût structurel inhérent à une contrainte aussi stricte : prouver, avec une certitude mathématique, qu’un jeu de poids précis et rien d’autre a produit une réponse, est un problème de calcul fondamentalement plus difficile que simplement produire cette réponse. Le plafond de 1024 tokens aggrave le même problème. Les chatbots actuels gèrent couramment des fenêtres de contexte de plusieurs centaines de milliers de tokens ; 1024 tokens, c’est à peine quelques paragraphes. Un système de preuve plafonné à ce niveau ne peut aujourd’hui couvrir ni une vraie conversation, ni un document long, ni la majorité de ce que les gens font réellement avec l’IA au quotidien.
Le chiffre à retenir n’est donc pas « 70 à 95 fois plus lent », point final ; ce chiffre bougera avec le modèle et le matériel testés. Ce qui reste vrai durablement, c’est que prouver l’identité d’un modèle coûte plusieurs ordres de grandeur de plus que simplement répondre, et cet écart est inhérent à l’approche elle-même, pas une aspérité qu’Anthropic aurait laissée par négligence.
Ce que la preuve ne couvre toujours pas
L’équipe d’Anthropic est étonnamment franche, dans son propre billet, sur les limites du système, et ces limites comptent autant que le résultat affiché en titre.
Le système de preuve a été construit et vérifié de façon formelle, c’est-à-dire que ses propriétés logiques centrales ont été validées avec un outil appelé Lean, un assistant de preuve qui confirme mathématiquement qu’un système se comporte comme annoncé, plutôt que de le tester par essais successifs. Les chercheurs d’Anthropic ont ainsi démontré quatre propriétés : la complétude (une preuve correcte est toujours validée), la validité (une fausse affirmation ne peut jamais être transformée en preuve valide), la propriété de divulgation nulle (les poids, les calculs intermédiaires, et même les sous-réseaux internes activés restent cachés de quiconque vérifie la preuve), et la concision (la preuve reste compacte quelle que soit la taille du calcul sous-jacent). C’est un résultat réel et rigoureux.
Mais il s’applique à la conception mathématique, pas au programme C++ rapide qui fait tourner la génération de preuve en pratique. Le code de production lui-même ne porte aucune preuve formelle de correction, seule la version abstraite vérifiée par Lean en bénéficie. Un bug dans cette implémentation rapide pourrait, en principe, fragiliser la garantie établie par l’article de recherche.
Deux autres limites, énoncées sans détour dans le billet d’Anthropic : le système ne prouve l’identité que pour des modèles utilisant un décodage glouton (greedy decoding), c’est-à-dire que le modèle choisit toujours son mot suivant le plus probable, sans aucun hasard. La plupart des chatbots déployés injectent au contraire une part de hasard contrôlé dans leurs réponses pour paraître plus naturels et variés, et ce type de hasard numérique s’écarte de ce que les mathématiques actuelles de la preuve savent gérer, donc ce cas n’est pas encore couvert. Et le temps que prend la génération d’une preuve pourrait lui-même constituer un canal auxiliaire, une façon indirecte de laisser fuiter de l’information : si ce temps varie selon les poids précis en jeu, un observateur patient pourrait en déduire quelque chose sur ces poids simplement en chronométrant, ce qui viendrait affaiblir une partie de l’intérêt du système.
À qui ça s’adresse vraiment
Rien de tout cela ne vise quelqu’un qui ouvre une fenêtre de chat demain. Le surcoût et le plafond de tokens excluent cet usage d’eux-mêmes. Le public réel est plus restreint et plus structurel : des laboratoires d’IA qui veulent auditer mutuellement leurs affirmations sans se communiquer leurs poids réels, des régulateurs ou évaluateurs indépendants qui doivent confirmer qu’un modèle déployé correspond bien à ce qu’une entreprise a soumis pour examen, et des services d’inférence tiers, ces sociétés qui revendent l’accès à des modèles d’IA de différents laboratoires, là où un client a une raison financière concrète de douter qu’il obtient bien ce qu’il paie.
Ce dernier cas est le plus directement utile. Si une entreprise achète l’accès à un modèle nommé via un revendeur, elle n’a aujourd’hui quasiment aucun moyen de vérifier que ce revendeur ne substitue pas discrètement un modèle moins cher pour gonfler ses marges. Un système de vérification aussi strict, même à 70 ou 95 fois le coût, pourrait valoir la dépense dans des contextes à forts enjeux : une entreprise financière menant des contrôles de conformité, un contrat public exigeant un modèle précis, ou un laboratoire de recherche publiant des résultats de benchmark que des concurrents veulent vérifier indépendamment, pour s’assurer qu’ils n’ont pas été obtenus sur une version plus complaisante du même modèle.
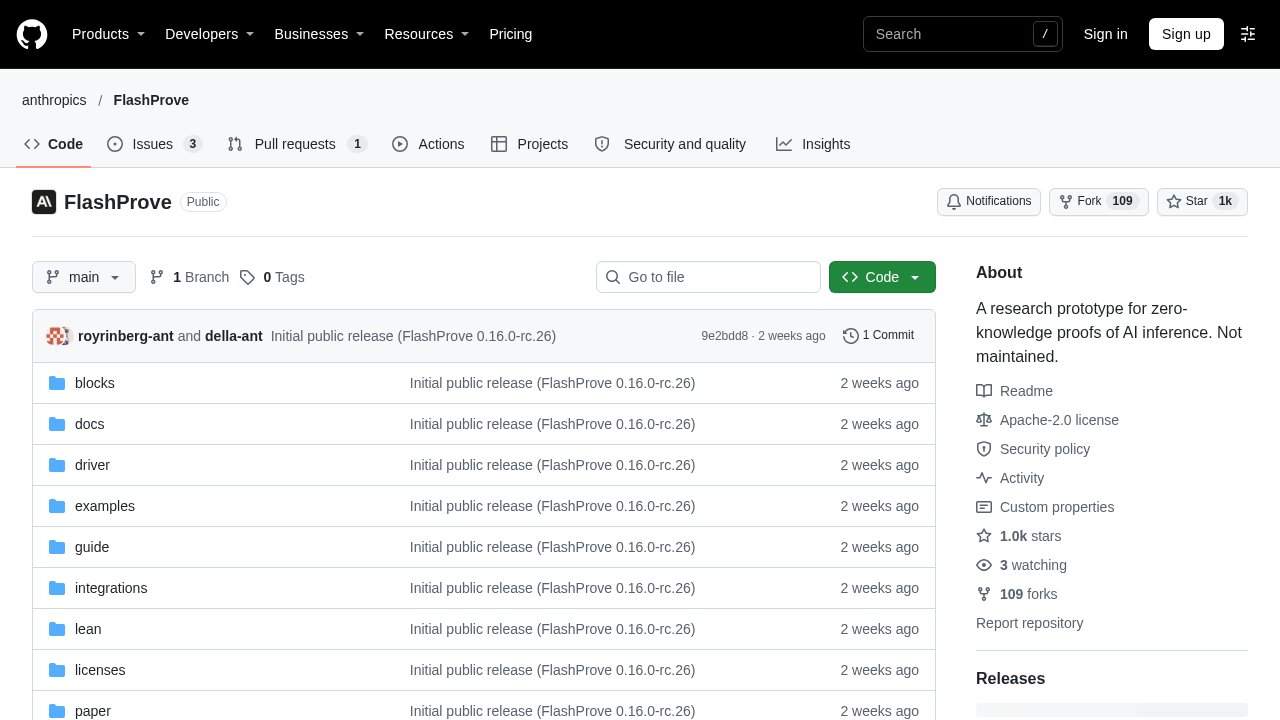 FlashProve sur GitHub, le dépôt ouvert et non maintenu du prototype de recherche, sous l’organisation GitHub d’Anthropic.
Anthropic prend soin, dans ses propres mots, de ne pas survendre où en est ce travail : « ce billet de recherche vise à partager une avancée intermédiaire, pas un programme de recherche achevé ». Aucun laboratoire, Anthropic compris, n’a annoncé de plan pour déployer FlashProve. Il existe comme code de recherche ouvert sur GitHub, testé sur un seul modèle, avec les limites ci-dessus clairement reconnues par ceux qui l’ont construit.

Questions fréquentes
FlashProve me permet-il de vérifier quel modèle d’IA a répondu à ma question dans un chatbot ?
Pas en pratique. FlashProve est un prototype de recherche, pas une fonctionnalité intégrée à un chatbot déployé. Même si une entreprise l’adoptait, la version actuelle plafonne les preuves à 1024 tokens et tourne 70 à 95 fois plus lentement que la normale, bien trop coûteux et trop limité pour une vraie conversation.
FlashProve est-il le même type de technologie que le marquage de contenu IA, comme SynthID de Google ?
Non. Les outils de marquage comme SynthID marquent un contenu généré, une image ou un texte, pour pouvoir ensuite le retracer jusqu’au système d’IA qui l’a probablement produit. FlashProve prouve autre chose : qu’un jeu précis et nommé de poids de modèle a produit une suite précise de tokens en sortie, sans jamais révéler ces poids.
Pourquoi prouver l’identité d’un modèle coûte-t-il tellement plus de puissance de calcul que simplement le faire tourner ?
Prouver par cryptographie que les poids exacts d’un modèle ont produit une sortie donnée, sans révéler ces poids, est un problème mathématiquement plus difficile que de simplement générer cette sortie. Les benchmarks d’Anthropic montrent un coût 70 à 95 fois supérieur en temps de calcul par rapport à une inférence standard sur le même modèle.
Une entreprise pourrait-elle utiliser FlashProve dès aujourd’hui pour empêcher qu’un modèle moins cher soit secrètement substitué ?
En principe oui, c’est exactement le problème que cible cette recherche, mais pas encore en pratique. Le surcoût et la limite de 1024 tokens le rendent inutilisable au quotidien ; c’est aujourd’hui plus proche d’un outil pour des audits formels entre laboratoires ou régulateurs que d’un système qu’une entreprise pourrait déployer cette année.
La structure interne du modèle reste-t-elle totalement cachée quand une preuve est vérifiée ?
Presque entièrement. Les poids, les calculs intermédiaires, et même les sous-réseaux « experts » activés dans les modèles à mélange d’experts restent tous cachés, une propriété que l’équipe d’Anthropic a vérifiée formellement. La seule réserve : le temps que prend la génération d’une preuve pourrait théoriquement, lui aussi, laisser fuiter une information, si ce temps varie selon les poids précis en jeu.