robots.txt : le nouvel opt-out contre l'entraînement IA, en vrai
Google, Microsoft, OpenAI et Anthropic disent respecter un même code dans robots.txt pour l'entraînement IA. Ce qu'il change vraiment, et ce qu'il ne règle pas.
Vous gérez un site et vous voulez empêcher qu’il serve à entraîner une IA ? Il suffit désormais d’ajouter une ligne à un fichier que presque tous les sites possèdent déjà, et quatre des plus gros labos d’IA ont dit qu’ils la respecteraient. Ça ressemble à la fin d’un vieux problème pénible. C’est plutôt le début d’un problème plus ordonné.
Le 30 octobre 2026, Google, Microsoft, OpenAI et Anthropic ont chacun publié un communiqué annonçant qu’ils respecteraient un nouveau signal partagé pour refuser l’entraînement IA, à placer dans robots.txt, ce petit fichier texte à la racine d’un site (votresite.com/robots.txt) qui indique aux robots d’exploration automatisés les parties du site qu’ils ont le droit de visiter. La plupart des articles qui ont suivi ont présenté la chose comme « quatre géants de la tech s’accordent sur un nouveau standard ». Cette formule est fausse sur deux points, et c’est justement l’écart entre ce qui a été annoncé et ce qui a vraiment changé qu’un éditeur de site doit comprendre avant de toucher à son propre robots.txt.
Ce que fait vraiment ce nouveau code dans robots.txt
Le mécanisme tient en trois lignes. Un site ajoute à son robots.txt un bloc qui nomme un nouveau user-agent, __usage_ai-training, et lui dit ce qu’il a le droit de faire ou non, exactement comme robots.txt fonctionne depuis toujours pour les robots des moteurs de recherche :
User-Agent: __usage_ai-training
Disallow: /
Allow: /press-kit/
Concrètement, cet exemple bloque les robots d’entraînement IA sur tout le site sauf un dossier de kit presse que le propriétaire veut justement voir indexé. Ce code préfixé d’un underscore ne désigne pas le robot d’une entreprise en particulier, contrairement à Googlebot ou GPTBot. C’est une étiquette commune que le robot de n’importe quelle entreprise IA participante peut reconnaître et respecter : un éditeur n’a donc pas besoin de lister le nom de chaque robot IA un par un pour dire une seule chose : n’utilisez pas ce contenu pour entraîner un modèle.
C’est la partie vraiment utile, et elle est réelle. Avant, un site qui voulait refuser l’entraînement IA devait tenir à jour une liste de robots nommés, un peu comme les sites qui veulent garder leur contenu hors d’une base vectorielle utilisée pour la recherche documentaire ont dû suivre chaque système séparément, et mettre la liste à jour chaque fois qu’un nouveau robot apparaissait. Une seule ligne, posée une fois, est censée couvrir tout robot qui accepte de la vérifier. La vraie question, qu’on détaille plus bas, c’est ce que cette ligne couvre réellement aujourd’hui, et ce qu’elle ne couvre pas.
Ce n’est pas un standard IETF, voici ce que c’est vraiment
Ce code provient d’un document nommé draft-kelley-aipref-training-preference-signal-00, déposé à l’IETF, l’Internet Engineering Task Force, l’organisme qui supervise les spécifications techniques de ce genre. Le mot « draft » (brouillon) dans le jargon de l’IETF ne veut pas dire approximatif ou inachevé au sens courant. C’est une catégorie formelle, et celle-ci, un Internet-Draft individuel, est l’échelon le plus bas : n’importe qui peut en déposer un, et la fiche de l’IETF datatracker pour ce brouillon précise sans détour qu’il « n’est pas endossé par l’IETF et n’a aucun statut formel dans le processus de standardisation de l’IETF ».
Donc ce code n’a été ni relu, ni débattu, ni validé par un groupe de travail de l’IETF. Ce qui a vraiment traversé ce processus, c’est un document lié mais différent, draft-ietf-aipref-vocab-08, intitulé « A Vocabulary For Expressing AI Usage Preferences ». Celui-là est un vrai document de groupe de travail (rédigé par Paul Keller, d’Open Future, et Martin Thomson, de Mozilla, sous l’égide du groupe de travail aipref de l’IETF), en route vers le statut de Proposed Standard, la désignation formelle d’une spécification ayant passé la revue de l’IETF. Il définit ce que signifie un terme comme « entraînement IA » dans un vocabulaire lisible par une machine. Le brouillon de Kelley se contente d’emprunter ce vocabulaire et de l’appliquer à la syntaxe de robots.txt, sans porter lui-même l’aval du groupe de travail.
Cette distinction compte, car un vrai document de groupe de travail est porté par un processus ouvert : relecture, objections, révisions, un chemin vers le consensus. Un brouillon individuel n’a rien de tout ça par défaut. Il ne devient concret que si suffisamment d’acteurs choisissent, en pratique, de le respecter, ce qui est exactement ce qui s’est passé ici : quatre entreprises ont choisi de soutenir un brouillon sans aval officiel, non pas parce que l’IETF le leur a demandé, mais parce qu’elles ont coordonné leurs propres annonces autour de lui.
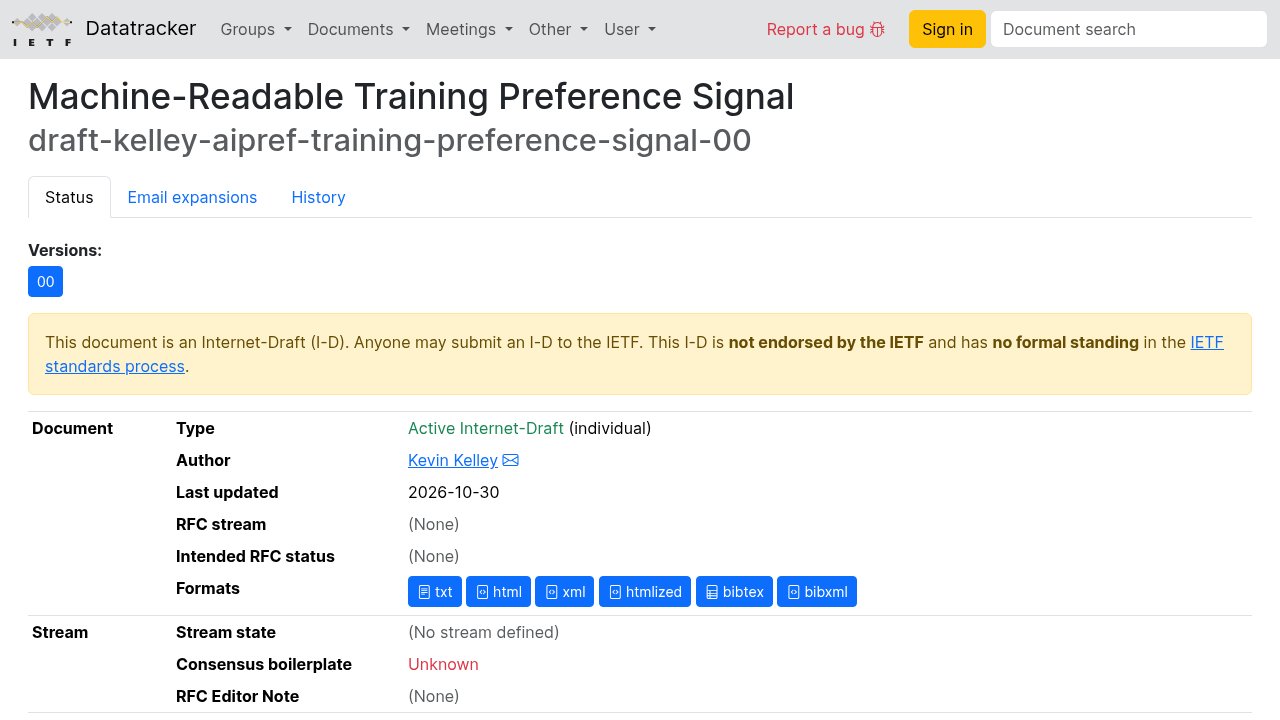
Fiche IETF datatracker du brouillon draft-kelley-aipref-training-preference-signal-00 — l’Internet-Draft individuel qui définit le code, explicitement signalé comme n’ayant aucun statut formel à l’IETF.
Quatre entreprises, un seul code, quatre calendriers différents
C’est là que le raccourci « 4 géants, 1 standard » s’effondre le plus. Les quatre entreprises ont bien annoncé la chose le même jour, mais ce à quoi chacune s’engage diffère dans le calendrier et dans la portée.
Google a publié un billet sur son Search Central Blog expliquant que si un site utilise le code partagé sans configurer séparément Google-Extended, son propre contrôle existant pour l’entraînement IA, Google traitera le code partagé comme couvrant aussi Google-Extended. Mais cette fusion n’est pas encore active non plus : Google dit « viser » à prendre en charge ce nouveau contrôle, avec d’autres fournisseurs d’IA, « en 2027 », sans date plus précise, tandis que les contrôles propres à Google continuent de fonctionner en attendant.
Microsoft, via Bing, a annoncé sur son Bing Blog qu’il commencera à respecter le code partagé le 1er février 2027, pas immédiatement. Microsoft a aussi introduit une seconde préférence, distincte, appelée « AI Grounding », qui couvre un usage différent : quand un système d’IA va chercher le contenu d’une page en direct pour générer une réponse, par opposition à l’utiliser pour entraîner un modèle en amont. Le grounding (l’ancrage en direct) ne peut aujourd’hui être contrôlé qu’au niveau d’une page individuelle, via une balise meta ou un en-tête X-Robots-Tag (une instruction placée dans la réponse du serveur plutôt que dans robots.txt), pas du tout via robots.txt.
OpenAI a indiqué dans un billet sur openai.com qu’il s’engage à respecter le même signal, avec un déploiement prévu « dans les mois à venir », sans date précise. Ses contrôles robots.txt existants continuent de s’appliquer en attendant, donc rien ne se perd à patienter, mais rien de nouveau n’entre en vigueur à date fixe non plus.
Anthropic, dont l’un des ingénieurs, Kevin Kelley, a rédigé le brouillon technique, est la seule entreprise à dire qu’elle agit déjà : en annonçant le brouillon sur la liste de diffusion ai-control de l’IETF le 30 octobre 2026, Kelley a écrit qu’« Anthropic a déjà commencé à mettre en œuvre la prise en charge de ce brouillon », tout en prévenant qu’« il nous faudra du temps pour étendre cette prise en charge à tous nos services et régler les complications et cas particuliers inévitables ». Anthropic a donc une longueur d’avance, mais, comme OpenAI, aucune date d’achèvement fixe.
Mis côte à côte, ces quatre cas dessinent moins « un seul interrupteur, quatre confirmations » que quatre calendriers de déploiement internes distincts, qui se contentent de pointer vers le même bout de syntaxe.
L’échéance Microsoft que les éditeurs ne peuvent pas ignorer
Sur les quatre, une seule entreprise fixe une vraie date d’expiration pour une pratique existante, et c’est le détail le plus susceptible de prendre un éditeur au dépourvu.
Beaucoup de sites découragent aujourd’hui l’entraînement IA de façon indirecte, via d’anciennes directives comme NoArchive ou NoCache, des balises meta conçues à l’origine pour empêcher les moteurs de recherche de stocker des copies en cache d’une page, et que certains robots en sont venus à interpréter de façon informelle comme un signal contre l’entraînement IA. Selon la documentation Webmaster Tools de Bing sur les préférences IA, Microsoft va arrêter de respecter NoArchive et NoCache comme signaux d’opt-out de l’entraînement IA à partir du 1er mars 2027.
Cela signifie que tout éditeur qui s’appuie actuellement sur ces anciennes balises pour garder son contenu hors de l’entraînement IA affilié à Bing a une échéance ferme, pas une vague fenêtre. Tout site encore dépendant de NoArchive ou NoCache pour cet usage doit ajouter le nouveau code avant le 1er mars 2027, sous peine de perdre cette protection sur Bing, sans filet de sécurité. C’est le seul élément de l’annonce qui se comporte comme un vrai changement de politique avec une vraie coupure nette, plutôt que comme un signal volontaire que les entreprises finiront par mettre en place un jour.
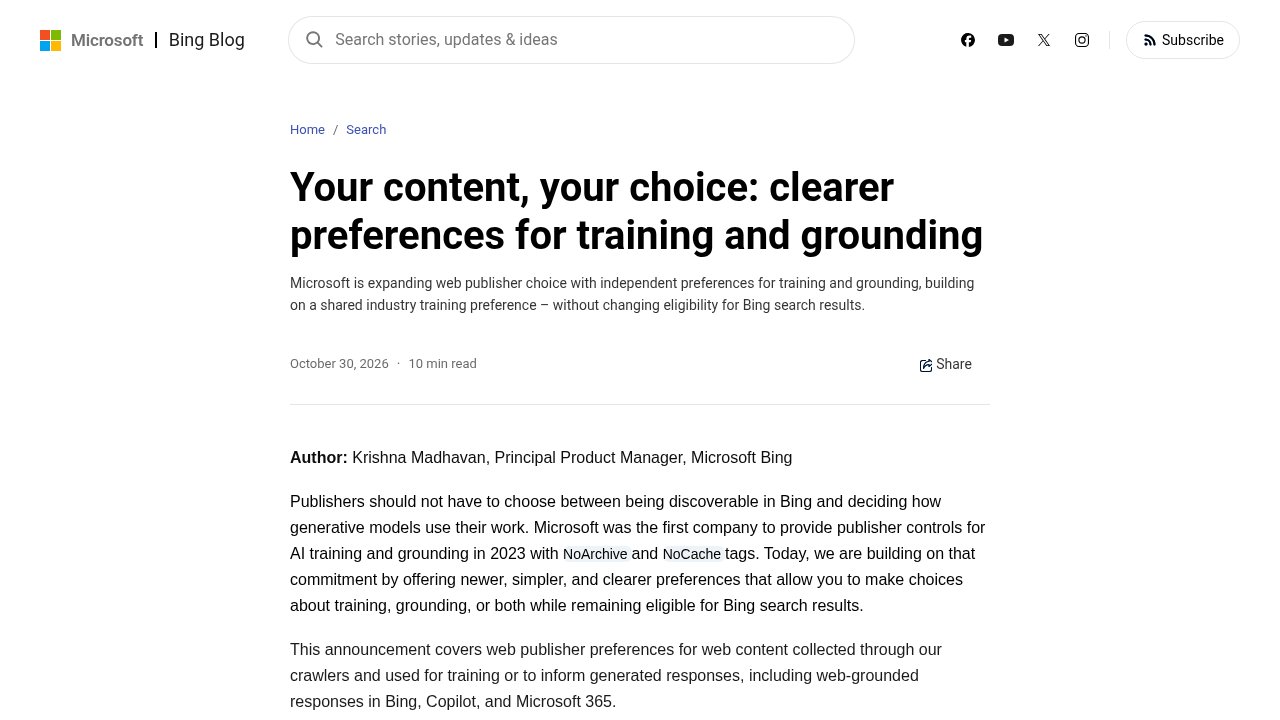
Microsoft Bing Blog — le billet du 30 octobre 2026 annonçant les nouvelles préférences d’entraînement et de grounding, ainsi que la date de retrait de NoArchive/NoCache.
Quoi mettre dans son robots.txt dès aujourd’hui, et ce que ça ne résout pas encore
Pour un éditeur qui veut agir maintenant plutôt qu’attendre que tous les calendriers se précisent, la démarche est simple : ajouter le bloc __usage_ai-training à robots.txt dès aujourd’hui, en le limitant aux chemins qu’on veut protéger. Ça ne coûte rien, ça ne casse rien d’autre sur le site, et ça fait courir le compteur vers une reconnaissance par les entreprises qui s’y sont engagées : Anthropic déjà en cours, Microsoft à partir de février 2027, Google à une date non précisée en 2027, OpenAI à une date non précisée « dans les mois à venir ».
Ce que ça ne fait pas encore, c’est donner une réponse unique et définitive à la question « mon contenu est-il protégé de l’entraînement IA ». Les robots des entreprises qui n’ont pas adhéré doivent toujours être traités à l’ancienne, en les nommant un par un, si un éditeur veut les bloquer. Le contrôle séparé AI Grounding de Microsoft reste lui aussi hors de portée de cette ligne, puisqu’il doit être réglé au niveau de chaque page, pas dans robots.txt, pour qui veut avoir un mot à dire sur cet usage précis. Et ce code n’a aucune force légale : c’est un signal volontaire, respecté parce qu’une entreprise a choisi de le faire, pas parce qu’une réglementation ou un standard ratifié l’y oblige.
C’est là la vraie leçon qui se cache derrière les quatre annonces du 30 octobre. Un code partagé qui ressemble à « on configure une fois, et c’est réglé partout » n’est pas la même chose qu’un standard ratifié avec une application synchronisée. C’est quatre entreprises qui s’accordent à lire le même mot, chacune à son propre rythme, avec ses propres exceptions. Pour le contrôle réel qu’un éditeur a sur son contenu et les risques qu’il prend, cela veut toujours dire vérifier la page de politique de chaque entreprise une par une, et non traiter une seule ligne de robots.txt comme un dossier clos.

FAQ
Qu’est-ce que le code __usage_ai-training dans robots.txt ?
Le code __usage_ai-training est une étiquette qu’un site ajoute à son fichier robots.txt pour dire aux robots d’IA de ne pas utiliser son contenu pour entraîner un modèle. À la différence de robots nommés comme GPTBot, c’est un signal partagé que plusieurs entreprises peuvent reconnaître à la fois, ce qui réduit le besoin de lister le robot de chaque entreprise IA une par une.
L’opt-out d’entraînement IA dans robots.txt est-il un standard IETF officiel ?
Non. Le document précis qui définit le code __usage_ai-training, draft-kelley-aipref-training-preference-signal-00, est un Internet-Draft individuel que l’IETF datatracker décrit explicitement comme n’ayant aucun statut formel dans le processus de standardisation de l’IETF. Un document de vocabulaire lié, lui, passe par une vraie revue de groupe de travail IETF, mais pas le code robots.txt en lui-même.
Google, Microsoft, OpenAI et Anthropic respectent-ils tous le code de la même façon ?
Non. Google prévoit de l’intégrer à son contrôle existant Google-Extended, mais dit que ça n’arrivera pas avant 2027. Microsoft commence à le respecter le 1er février 2027, et traite différemment un usage distinct, le « AI Grounding », en dehors de robots.txt. OpenAI prévoit un déploiement « dans les mois à venir » sans date fixe, et Anthropic, qui a rédigé le brouillon, dit avoir déjà commencé sa mise en œuvre mais n’a donné aucune date d’achèvement.
Pourquoi l’échéance Microsoft compte-t-elle pour les éditeurs dès maintenant ?
Microsoft va arrêter de respecter NoArchive et NoCache comme signaux d’opt-out d’entraînement IA sur Bing à partir du 1er mars 2027. Tout éditeur qui dépend actuellement de ces anciennes balises pour bloquer l’entraînement IA sur Bing doit ajouter le nouveau code __usage_ai-training à robots.txt avant cette date, sous peine de perdre cette protection sans filet automatique.
Ajouter le nouveau code empêche-t-il toutes les entreprises IA d’entraîner leurs modèles sur mon contenu ?
Non. Il ne couvre que les entreprises qui s’y sont engagées, et même dans ce cas, son application dépend du bon vouloir du robot de cette entreprise à le respecter. Les robots des entreprises qui n’ont pas adopté le signal nécessitent toujours des règles séparées, nommées, dans robots.txt pour qui veut les bloquer.