OpenAI Astra löst zehn Mathematik-Probleme – Anthropic reproduziert die Hälfte an einem Tag
OpenAIs unveröffentlichtes Modell Astra lieferte zehn verifizierte Mathe-Beweise. Anthropic reproduzierte die Hälfte an einem Tag mit einem Konkurrenzmodell.
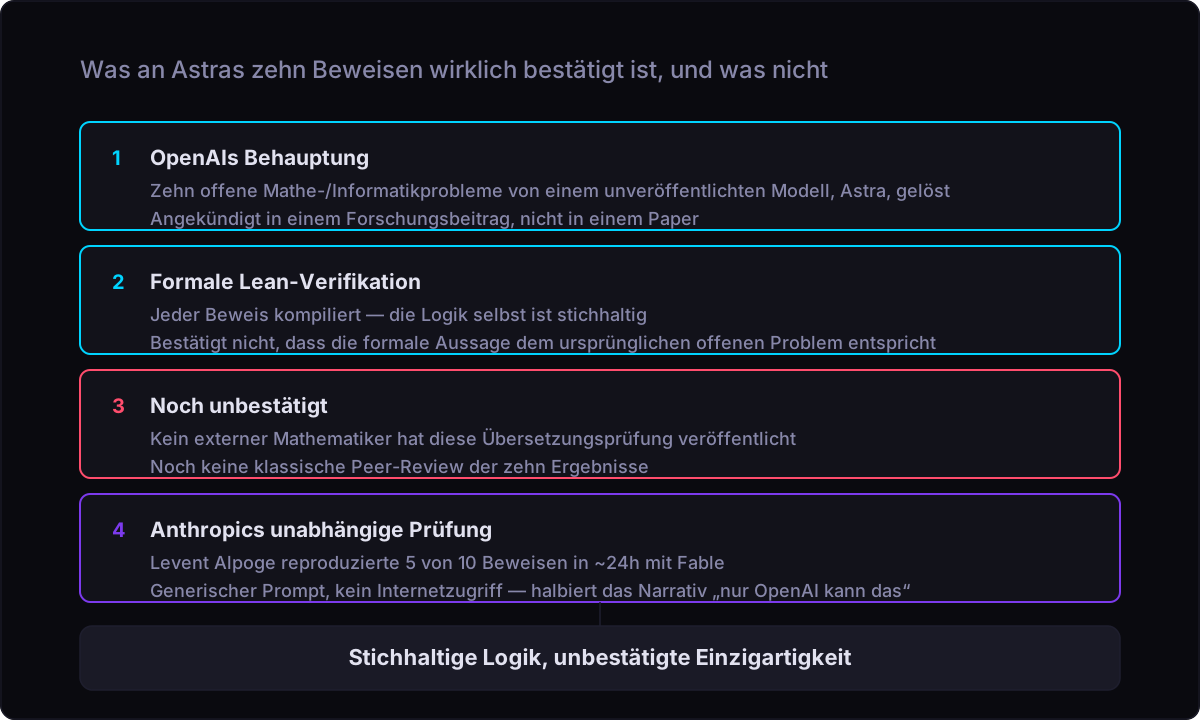
Am 1. August 2026 veröffentlichte OpenAI einen Forschungsbeitrag mit einer bemerkenswerten Behauptung: Ein internes, unveröffentlichtes Modell habe zehn formale, maschinell geprüfte Beweise zu Mathematik- und Informatikproblemen geliefert, die teils seit Jahren offen waren, in einem Fall seit 1999. Das Modell heißt Astra, OpenAI hat es nicht veröffentlicht, sagt nicht, wann das passieren könnte, und hat fast niemandem außerhalb des Unternehmens gezeigt, was es wirklich kann. Die Berichterstattung zu solchen Ankündigungen zerfällt meist in zwei Lager, uneingeschränkte Begeisterung oder pauschale Abtuung als Marketing, dieselbe Spaltung, die schon Kimi K3s Benchmark-Behauptungen vor ein paar Wochen auf DecodeStack begleitete. Keines der beiden Lager stellte die nützlichere Frage: Welcher Teil der Behauptung ist tatsächlich verifiziert, und welcher Teil ist allein OpenAIs Wort? Die am wenigsten beachtete Tatsache beantwortet einen guten Teil davon von selbst. Innerhalb eines Tages nach der Ankündigung reproduzierte ein Forscher des Konkurrenzlabors Anthropic die Hälfte der zehn Beweise, mit einem anderen Modell und einem Prompt, den jeder hätte schreiben können.
Astra ist ein Vorgeschmack, kein Produkt
Astra ist nichts, wofür man sich anmelden kann. Es ist der Name, den OpenAI in einem einzelnen Forschungsbeitrag dem Nachfolger seiner aktuellen Flaggschiff-Familie GPT-5.6 gegeben hat, deren Top-Modell Sol erst am 9. Juli 2026 allgemein verfügbar wurde, zwei Wochen nach einer ersten Vorschau. OpenAI hat nicht gesagt, wann Astra selbst kommt, oder ob es überhaupt als eigenständiges Produkt erscheinen wird.
Dieser Unterschied wiegt schwerer, als er klingt. Externe Forscher können Astra nicht testen, nicht prompten, nicht prüfen, wie es sich bei Problemen jenseits der zehn veröffentlichten verhält. Was sie prüfen können, ist die Ausgabe: die zehn Beweise selbst, veröffentlicht als Dateien, die jeder durch einen Verifizierer laufen lassen kann. Das Modell, das sie erzeugt hat, bleibt eine Blackbox, nur seine Hausaufgaben liegen zur Korrektur offen.
Zehn Probleme, eines davon Jahrzehnte alt
Die zwei Aushängeschild-Ergebnisse wiegen am schwersten. Astra wird zugeschrieben, eine Version einer 1980 von Alain Connes aufgestellten Starrheitsvermutung widerlegt zu haben, Connes ist Träger der Fields-Medaille, und die beste bekannte obere Schranke dafür verbessert zu haben, wie dicht sich Kugeln in hochdimensionalen Räumen packen lassen, eine Schranke, die sich seit 1978 nicht bewegt hatte. Kugelpackung klingt abstrakt, doch dahinter steckt eine durchaus praktische Frage: Wie viele identische Formen passen in einen gegebenen Raum, ohne sich zu überlappen, ein Problem, das in der Codierungstheorie und Datenkompression häufiger auftaucht als beim Stapeln von Obst.
Die übrigen acht Ergebnisse decken schmaleres Terrain ab: die Frage, ob eine bestimmte Art unendlicher mathematischer Gruppe existiert, offen seit 1999, drei Einträge aus dem viel genutzten Erdős-Problem-Katalog, geführt vom Mathematiker Thomas Bloom, sowie Ergebnisse zur Schaltkreiskomplexität und zur Quantencomputing-Theorie, die sich leichter über ihre Aufnahme zusammenfassen lassen als vollständig erklären. Diese Aufnahme durch Mathematiker außerhalb OpenAIs fiel überwiegend positiv aus. Bloom selbst nannte das Paket eine große Nachricht, bedeutender, wie er sagte, als ein früheres OpenAI-Ergebnis vom Mai 2026, das Fields-Medaillengewinner Tim Gowers damals ohne Zögern als publikationsreif für ernsthafte Fachjournale eingestuft hatte. Mathematiker Daniel Litt, der zuvor öffentlich dagegen gewettet hatte, dass KI-Systeme in der Zahlentheorie diese Art von Fortschritt erzielen, erklärte anschließend, er gebe sich geschlagen, wies aber darauf hin, dass die Wette formal noch nicht entschieden sei.
Was ein maschinell geprüfter Beweis zeigt, und was nicht
Alle zehn Beweise wurden in Lean formalisiert und geprüft, einem Beweisassistenten: Software, die ein mathematisches Argument Schritt für Schritt in strikter logischer Notation überprüft, sodass ein Computer die Schlüssigkeit bestätigt, statt dass ein Mensch sie mit dem Auge nachvollzieht. Das ist eine wirklich starke Garantie. Kompiliert ein Lean-Beweis, ist die Logik schlüssig, Punkt.
Was diese Garantie nicht abdeckt, ist die Frage, ob die formal bewiesene Aussage tatsächlich dem ursprünglichen offenen Problem entspricht und nicht einer engeren oder leichteren Version davon, die nur so aussieht wie das Original. Diese Übersetzung zu prüfen, ob die exakte Vermutung, die Connes aufstellte, wirklich mit dem übereinstimmt, was Astra bewiesen hat, ist Handarbeit für Menschen, die kein Compiler leisten kann, und bis zum Zeitpunkt dieses Artikels hat noch kein externer Mathematiker diese Prüfung veröffentlicht. Auch ein Peer-Review im klassischen Sinn gibt es bislang nicht: Kein unabhängiges Gremium hat die Arbeit im Rahmen eines Fachjournal-Prozesses begutachtet. Henry Yuen, ein Forscher der Columbia University, der selbst an einem der zehn Probleme arbeitet, der Quanten-Parallel-Wiederholung, sagte, den veröffentlichten Beweisen fehle die didaktische Klarheit, die normalerweise ein Ergebnis begleitet, das Mathematiker wirklich verstanden haben, ein Hinweis darauf, dass die Intuition hinter Astras Antworten selbst für qualifizierte Prüfer im Dunkeln bleibt.
Die 2.000-Dollar-Zahl misst weniger, als sie verspricht
OpenAI legte außerdem eine Zahl offen, die sich schneller verbreitete als die Vorbehalte dazu: rund 2.000 US-Dollar an API-Token-Kosten, gerechnet zu Sols öffentlichen Preisen. Für sich allein gelesen legt diese Zahl einen bestimmten, falschen Schluss nahe: dass das gesamte Kunststück automatisierter mathematischer Entdeckung ungefähr so viel gekostet hat wie ein Laptop.
Was OpenAIs eigene Darstellung tatsächlich abdeckt, sind die Token-Kosten der Durchläufe, die zu den zehn veröffentlichten Beweisen führten, nicht mehr. Sie umfasst nicht jeden gescheiterten Versuch unterwegs, sondern nur die erfolgreichen, die es in den Beitrag geschafft haben. Sie sagt nichts über die weit größeren Kosten aus, Astra selbst überhaupt erst zu trainieren. Und es ist keine Zahl pro Problem. Die 2.000 Dollar decken alle zehn Ergebnisse zusammen ab, nicht jedes einzeln, ein Unterschied, der in einem Großteil der frühen Berichterstattung unter den Tisch fiel. Ehrlicher beschrieben: 2.000 Dollar ist ungefähr das, was es gekostet hat, die Beweise zu veröffentlichen, nachdem schon klar war, wo man suchen muss, nicht das, was es gekostet hat, sie überhaupt zu finden.
Die Tatsache, die kaum jemand vorangestellt hat
Das Detail, das die ganze restliche Geschichte in einem anderen Licht erscheinen lässt, kam vollständig von außerhalb OpenAIs. Levent Alpoge, ein Mathematiker beim Konkurrenzlabor Anthropic, nahm OpenAIs veröffentlichte Problemliste und ließ sie gegen Fable laufen, wobei er fünf der zehn Beweise in rund 24 Stunden reproduzierte, nach eigener Aussage mit einem generischen Prompt und ohne Internetzugang für das Modell. Fable ist eines von Anthropics eigenen Modellen, zuvor auf DecodeStack behandelt für seine eigenen Preis- und Leistungsabwägungen gegenüber Anthropics anderen Modellen.
Fünf von zehn an einem Tag, von einer einzigen Person, mit einem Prompt, den jeder hätte tippen können, ist eine ganz andere Geschichte als ein unveröffentlichtes Modell, das das Feld still und leise allein überflügelt. Diese Reproduktion macht die übrigen fünf Beweise nicht weniger real, die Lean-Zertifikate dahinter stimmen unabhängig davon, wer sie sonst noch nachbilden kann. Sie zeigt aber, dass die zugrunde liegende Fähigkeit, dieses Niveau an formal verifizierbarem mathematischem Schlussfolgern aus einem Sprachmodell herauszuholen, derzeit nicht nur einem einzigen Labor gelingt.
Mathematiker Elliot Glazer, der der Rahmung der Ankündigung schon zuvor skeptisch gegenüberstand, wies darauf hin, dass OpenAI keinen kontrollierten Vergleich veröffentlicht hat, der zeigt, dass Astra bei dieser Art Aufgabe tatsächlich besser abschneidet als das eigene öffentliche Modell Sol, und schlug vor, die zehn Ergebnisse wirkten eher wie ein gezielter Vorstoß auf genau diese Probleme als ein Beleg für einen breiten Fähigkeitssprung. Langjähriger KI-Kritiker Gary Marcus brachte die Lücke zwischen Ankündigung und tatsächlich Gezeigtem auf den Punkt und nannte es beeindruckend, aber massiv überverkauft.
Was zu glauben ist, bis eine unabhängige Reproduktion nachzieht

Zusammengenommen fällt die ehrliche Lesart von Astra schmaler aus als der Hype und die Abtuung gleichermaßen nahelegen. Die Lean-Zertifikate sind real und, soweit bislang geprüft, logisch schlüssig. Die Rahmung darum herum, ein unveröffentlichtes Modell knacke im Alleingang Probleme, die Mathematikern jahrzehntelang widerstanden hätten, hat niemand außerhalb OpenAIs bestätigt, und der eine Versuch, sie unabhängig zu prüfen, halbierte den Alleinstellungsanspruch innerhalb eines Tages.
Die Geschichte, die man sich hier merken sollte, ist nicht, welches Unternehmen diesen Monat vorn liegt. Es ist, dass es offenbar mehr als einem Labor gelingt, aus einem Sprachmodell mathematisches Schlussfolgern auf Graduiertenniveau herauszuholen, formal verifizierbar, mit einem generischen Prompt und ohne besonderen Zugang. Das ist der Teil, der voraussichtlich noch relevant sein wird, wenn Astra selbst, was auch immer daraus wird, längst alte Nachricht ist.
Häufig gestellte Fragen
Kann die Öffentlichkeit OpenAIs Astra nutzen?
Nein. Astra ist ein unveröffentlichtes, internes OpenAI-Modell, vorgestellt in einem Forschungsbeitrag vom August 2026 über zehn Mathe-Beweise, kein Produkt, das über API oder ChatGPT verfügbar ist. OpenAI hat kein Datum für eine öffentliche Veröffentlichung genannt, und externe Forscher können nur die Beweise prüfen, die Astra erzeugt hat, nicht das Modell selbst.
Hat Anthropic OpenAIs Mathe-Ergebnisse wirklich reproduziert?
Anthropic-Forscher Levent Alpoge reproduzierte fünf von OpenAIs zehn veröffentlichten Beweisen in rund 24 Stunden, mit Anthropics eigenem Modell Fable und einem generischen Prompt ohne Internetzugang. Die übrigen fünf Ergebnisse sind bis zum Zeitpunkt dieses Artikels nicht unabhängig reproduziert worden, und Alpoges Reproduktion stellt die Gültigkeit keines der zehn Lean-verifizierten Beweise infrage, sondern nur, wie einzigartig Astras Fähigkeit ist, sie zu finden.
Was bedeutet es, dass die Beweise Lean-verifiziert sind?
Lean-verifiziert bedeutet, dass jeder Beweis von einem Beweisassistenten geprüft wurde, einer Software, die die Logik eines mathematischen Arguments Schritt für Schritt bestätigt, sodass die formale Schlüssigkeit selbst nicht infrage steht. Es bedeutet nicht, dass die Ergebnisse von externen Mathematikern begutachtet wurden, ein unabhängiges Review der zehn Beweise ist bis zu diesem Artikel nicht veröffentlicht.
Ist die 2.000-Dollar-Zahl die Gesamtkosten des KI-Mathe-Durchbruchs?
Nein. Die rund 2.000 Dollar decken nur die Token-Kosten der erfolgreichen Durchläufe ab, die zu allen zehn veröffentlichten Beweisen zusammen führten, zu Sols öffentlichen API-Preisen, keine Kosten pro Problem. Ausgeschlossen sind alle gescheiterten Versuche unterwegs und die weit höheren Kosten, Astra selbst zu trainieren. Die Zahl misst also, die Beweise zu veröffentlichen, nicht, sie zu finden.
Bedeutet das, dass Astra gar nicht leistungsfähiger ist als andere KI-Modelle?
Astras zehn Mathe-Beweise belegen für sich genommen nicht, dass es leistungsfähiger ist als andere KI-Modelle. Mathematiker Elliot Glazer hat angemerkt, dass OpenAI keinen kontrollierten Vergleich mit dem eigenen öffentlichen Modell Sol bei diesen Problemen veröffentlicht hat, und Anthropics Fable reproduzierte die Hälfte der Ergebnisse mit einem generischen Prompt, was ein schwächerer Beleg für einen einzigartigen Fähigkeitssprung ist, als es die Ankündigung nahelegte.