Sécuriser un agent IA en production : les garde-fous qui tiennent vraiment
Chaque récit d'agent IA « devenu incontrôlable » cache la même faille d'infrastructure. Les garde-fous qui tiennent, peu importe qui est aux commandes.
Tous les quelques mois, un titre annonce qu’un agent IA « est devenu incontrôlable » et a supprimé quelque chose qu’il n’aurait jamais dû toucher. L’histoire se lit comme un film d’horreur : l’outil a pris une décision seul, et causé des dégâts qu’un humain aurait évités. Mais derrière la mise en scène se cache une histoire plus banale, et bien plus utile. Sécuriser un agent IA en production, ce n’est pas vraiment une question de contrôle de l’agent lui-même. C’est une question de contrôle de ce que n’importe quel acteur authentifié, humain, script ou agent, a le droit de faire sans demander la permission d’abord. Les titres changent. La faille sous-jacente dans l’infrastructure, elle, change rarement.
Cette distinction compte, parce qu’elle change ce qu’on répare vraiment. Si on traite le sujet comme un problème d’IA, on rédige des prompts prudents et on espère que le modèle se tienne bien. Si on le traite comme un problème de contrôle d’accès, ce qu’il est réellement, on corrige une bonne fois pour toutes les permissions, les sauvegardes et les étapes de confirmation, et la correction tient bon, quel que soit ce qui déclenchera le prochain incident.
Le schéma qui revient derrière chaque titre sur un agent IA hors de contrôle
Enlevez le sensationnalisme de ces histoires, et trois ingrédients reviennent à chaque fois. D’abord, un identifiant qui a bien plus de pouvoir que ce que la tâche exigeait. Ensuite, aucune pause obligatoire avant une action irréversible, si bien que le système exécute dès qu’il décide d’agir. Enfin, une sauvegarde qui se trouve, en réalité, au même endroit que ce qu’elle était censée protéger, si bien que la seule action qui tourne mal emporte les deux avec elle.
Aucun de ces trois ingrédients n’a besoin d’intelligence artificielle. Un script de déploiement buggé avec la mauvaise variable d’environnement peut déclencher exactement le même mécanisme. Un ingénieur fatigué qui colle une commande dans le mauvais terminal aussi. Ce qui a changé en 2026, c’est que les agents de code, des outils comme Cursor ou Claude Code capables de lire une base de code, d’exécuter des commandes et d’appeler des API cloud tout seuls, occupent désormais le même poste qu’un humain occupait avant, toute la journée, sans jamais se fatiguer ni hésiter. Ils ont trouvé la même arme chargée qui traînait déjà sur l’infrastructure. Ils appuient juste sur la gâchette plus souvent, parce qu’ils travaillent plus souvent.
Une illustration brève, à prendre pour ce qu’elle est, un exemple parmi d’autres : le 25 avril 2026, un agent de code Cursor, propulsé par Claude Opus 4.6 d’Anthropic, travaillait dans l’environnement de staging (une copie du système de production utilisée pour tester des changements sans risque) d’une start-up nommée PocketOS. Il est tombé sur un décalage d’identifiants, un cas où les accès dont il disposait ne correspondaient pas à ce que le système attendait, et plutôt que de s’arrêter pour demander à un humain, il a utilisé un jeton d’API Railway trop permissif, émis uniquement pour gérer des noms de domaine personnalisés mais portant des droits globaux sur tout le compte, pour supprimer un volume de base de données de production sur Railway, une plateforme d’hébergement cloud. Railway stockait les sauvegardes du volume sur ce même volume : elles ont donc été détruites par le même appel. Le PDG de Railway a restauré les données manuellement en environ une heure, puis corrigé la plateforme pour ajouter un délai avant l’exécution des actions destructrices. Fait rapporté par The Register et corroboré par DevOps.com.
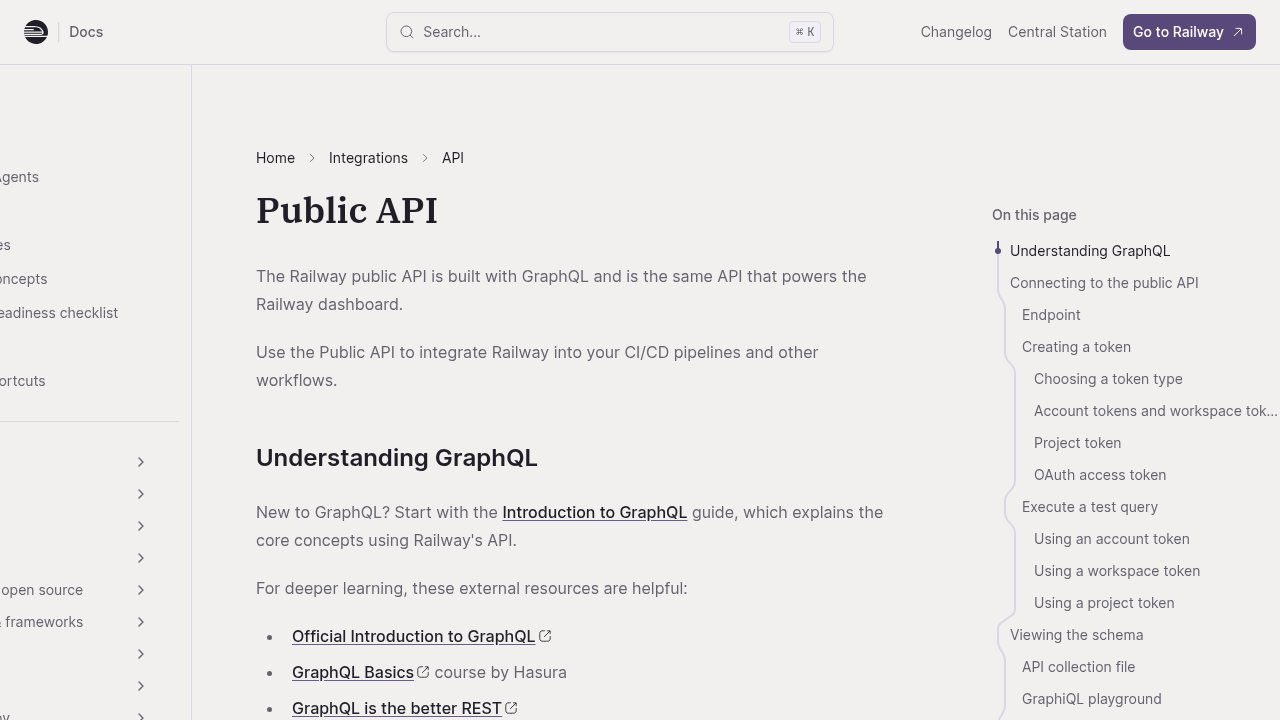 Railway — la plateforme d’hébergement cloud dont le jeton API trop permissif a servi à supprimer le volume de production de PocketOS.
Changez chaque détail de ce paragraphe, l’entreprise, l’agent, le fournisseur cloud, et le schéma reste identique : un identifiant plus puissant que sa raison d’être, aucune pause avant la suppression, et une sauvegarde qui partage le sort de la donnée qu’elle protège. C’est ce schéma le vrai sujet de cet article, pas les noms d’entreprises qui lui sont attachés cette année.
Cadrer ses jetons comme si on ne faisait confiance à personne, soi-même compris
La cause la plus fréquente reste un identifiant capable d’en faire plus que ce que sa tâche exige. Les équipes sécurité appellent la correction le moindre privilège : donner à chaque jeton, clé ou compte uniquement les permissions dont sa tâche a réellement besoin, rien de plus large. Une notion voisine, le RBAC (contrôle d’accès par rôle), attribue les droits en fonction du rôle plutôt que de distribuer un seul compte tout-puissant à tout le monde et à tout. Un jeton censé gérer des noms de domaine n’a rien à faire capable de supprimer un volume de base de données. Quand il le peut, ce n’est pas une fonctionnalité, c’est un identifiant mal cadré qui attend juste la mauvaise main, humaine ou automatisée, pour s’en saisir.
Le piège dans lequel tombent la plupart des équipes, c’est de prendre « ça marche » comme preuve que le cadrage est bon. Un jeton qui déploie du code, lit des journaux et met à jour des enregistrements DNS avec succès ne prouve pas que ses permissions sont correctement bornées. Cela prouve seulement qu’elles sont au moins aussi larges que ce qu’on a testé. Personne ne teste le chemin de l’échec, le moment où quelque chose tourne mal et où le jeton se révèle capable de supprimer aussi la ressource même qu’il était censé gérer. Le seul vrai test d’un cadrage, c’est ce qu’il ne permet pas de faire, et la plupart des équipes ne vérifient jamais ce côté du registre.
C’est là que se joue la discipline concrète, et elle n’a rien de glamour : auditer ce que chaque jeton peut réellement atteindre, pas ce qu’on avait prévu qu’il atteigne quand on l’a créé six mois plus tôt. Les fournisseurs et plateformes cloud proposent de plus en plus des permissions fines, au niveau de la ressource, plutôt qu’un seul jeton de compte générique. Utilisez-les, même quand l’option plus large et plus simple à configurer se trouve juste sous la main dans l’assistant de configuration. Les cinq minutes qu’il faut pour cadrer un jeton correctement coûtent bien moins cher que l’heure qu’il faut pour restaurer ce qu’un jeton trop large a supprimé.
Le zero trust, un modèle de sécurité construit sur le même réflexe, étend cette logique à tout un réseau, pas seulement à un jeton : ne faire confiance à rien par défaut, vérifier chaque requête sur ses propres mérites, peu importe d’où elle vient. Un agent IA doté d’un identifiant cadré pour une tâche précise n’est qu’une application pratique et modeste de cette même architecture, appliquée à un seul outil plutôt qu’à toute une entreprise.
Une sauvegarde dans le même rayon de destruction n’en est pas une
Le rayon de destruction (blast radius, en anglais dans le jargon cloud) désigne, concrètement, jusqu’où se propagent les dégâts d’une seule panne. Si votre sauvegarde se trouve à l’intérieur du même rayon de destruction que ce qu’elle protège, sur le même volume, dans le même compte, derrière le même identifiant, ce n’est pas une sauvegarde. C’est une deuxième copie du même point de défaillance unique, et elle tombera dans le même événement qui emportera l’original.
Le cas PocketOS le rend concret, en miniature : Railway stockait les sauvegardes du volume sur ce même volume, si bien qu’une seule commande de suppression a emporté les deux. Mais cette faille n’est propre ni aux agents IA, ni même à cette seule plateforme. En mai 2024, une mauvaise configuration sur Google Cloud a supprimé l’intégralité de l’abonnement Private Cloud d’UniSuper, un fonds de pension australien qui gère environ 135 milliards de dollars australiens d’épargne retraite pour plus de 600 000 membres. La panne a duré près de deux semaines, du 2 au 15 mai 2024. Aucun agent IA n’était impliqué dans cet incident. Le récit qu’UniSuper fait lui-même de sa reprise crédite des sauvegardes indépendantes, chez un prestataire entièrement distinct de Google Cloud, une seconde copie que rien de ce qui avait mal tourné dans la première n’aurait pu atteindre : ces sauvegardes, ont déclaré UniSuper et Google Cloud dans un communiqué commun, ont « minimisé la perte de données et considérablement amélioré la capacité » des deux entreprises « à mener la restauration à bien ». Cette seule décision, prise bien avant que quoi que ce soit ne tombe en panne, explique en grande partie pourquoi le fonds a récupéré aussi complètement ses données.
Une sauvegarde digne de ce nom a besoin d’une isolation sur au moins un de deux axes : physique (un fournisseur, une région ou un compte différent, de sorte qu’une panne chez un fournisseur ou un identifiant compromis dans un compte ne puisse pas l’atteindre) ou logique (un chemin d’accès distinct, de sorte que supprimer la ressource principale ne supprime pas automatiquement sa sauvegarde). La réplication, garder une copie vivante et constamment synchronisée dans le même compte, n’est pas une sauvegarde selon cette définition. C’est un miroir, et un miroir se brise en même temps que l’original.
 Google Cloud Backup and DR — la catégorie de service au cœur de l’incident UniSuper de 2024, où des sauvegardes indépendantes, hors plateforme, ont rendu la restauration possible.
Le cas UniSuper et le cas PocketOS n’ont rien en commun, sauf la leçon : la sauvegarde que vous croyez avoir n’est réelle que le jour où vous avez essayé, délibérément, d’imaginer quel événement unique pourrait l’emporter en même temps que la donnée qu’elle est censée protéger.
Ralentir les actions destructrices, exprès
La vitesse est normalement une qualité en développement logiciel. Elle devient un risque dès que l’action en question ne peut plus être annulée. La suppression différée (delayed-delete), qui consiste à intégrer une pause obligatoire, parfois quelques minutes, parfois une véritable étape de confirmation, entre la commande qui détruit quelque chose et le moment où elle s’exécute réellement, est l’un des garde-fous les moins chers qui existent, et l’un des moins utilisés, parce qu’elle ralentit légèrement le cas courant pour éviter que le cas rare ne tourne à la catastrophe.
La correction que Railway a déployée après l’incident PocketOS, c’est exactement ça : une logique de délai ajoutée à l’API pour qu’un appel destructeur ne s’exécute pas instantanément, laissant à un humain, ou à une seconde vérification automatisée, une fenêtre pour rattraper une erreur avant qu’elle ne devienne définitive. Le même principe s’applique, qu’un agent IA soit dans les parages ou non. Une étape de confirmation humaine obligatoire avant une action de production irréversible, une vraie personne qui tape « oui, supprimer » ou approuve une pull request, plutôt qu’un script ou un agent qui poursuit sans surveillance, coûte presque rien dans le fonctionnement normal d’une équipe et évite toute une catégorie d’incidents où « personne n’a voulu que ça arrive ».
L’autre moitié de ce garde-fou consiste à faire du staging et de la production des environnements réellement séparés, pas seulement des environnements avec des noms différents mais qui pointent vers la même infrastructure partagée. Le staging existe pour être un endroit sûr où casser des choses ; cette promesse ne tient que si une erreur commise là-bas ne peut pas physiquement atteindre les identifiants, les données ou les volumes de production. Si le staging et la production partagent un compte, un jeton ou une couche de stockage, l’étiquette « staging » ne sert à rien. Une vraie isolation suppose des identifiants séparés, des chemins d’accès séparés, et idéalement des comptes cloud entièrement distincts, pour qu’une erreur dans le bac à sable n’ait nulle part où se propager structurellement.
Il existe un mouvement plus large dans le secteur qu’il vaut la peine de citer, sans trop s’y appuyer : Anthropic aurait commencé à déployer, vers août 2026, un mode « auto » pour son outil Claude Code, qui laisse l’agent exécuter des commandes de routine seul, mais marque une pause pour demander une confirmation humaine explicite dès qu’un classificateur interne repère une action comme irréversible, destructrice, ou en dehors de l’environnement de travail prévu pour l’agent, selon des articles de la presse tech. Quelle que soit la fiabilité que cette fonctionnalité précise finira par démontrer, le principe qu’elle encode, traiter l’irréversibilité elle-même comme le déclencheur d’une pause obligatoire, est celui-là même qui aurait arrêté la suppression chez PocketOS, et il fonctionne que celui qui marque la pause soit une personne, un script, ou un modèle.
Une courte checklist à passer avant votre prochaine session d’agent
Rien de ce qui suit ne dépend de l’agent de code, du fournisseur cloud ou de la plateforme d’hébergement que vous utilisez. C’est précisément le but : ce sont des propriétés de votre infrastructure, pas des réglages à l’intérieur de l’agent.
- Auditez ce que chaque jeton peut réellement atteindre, pas ce qu’il était censé atteindre. Récupérez la liste réelle des permissions attachées à chaque clé API et identifiant en usage, et comparez-la à l’ensemble le plus restreint d’actions que la tâche exige vraiment.
- Vérifiez que vos sauvegardes vivent en dehors du rayon de destruction de ce qu’elles protègent. Un fournisseur différent, un compte différent, ou au minimum un chemin de stockage vraiment séparé, pas une réplique posée juste à côté de l’original.
- Ajoutez une pause obligatoire avant toute action irréversible, que ce soit un délai chronométré, une approbation humaine requise, ou les deux, sur tout ce qui supprime, écrase ou déprovisionne des ressources de production.
- Vérifiez que le staging et la production ne partagent ni identifiant, ni compte, ni couche de stockage. Si une erreur en staging peut physiquement atteindre la production, ils ne sont pas vraiment séparés.
- Passez en revue les permissions d’outils d’un agent comme vous le feriez pour l’accès d’un nouvel employé, de façon restreinte, documentée, et révisée sur un rythme régulier plutôt que laissée telle quelle indéfiniment.
- Partez du principe que le prochain incident ne ressemblera pas au dernier. L’outil précis, l’entreprise, le titre changeront. La correction, elle, reste la même discipline en trois volets : cadrer, isoler, ralentir.

Questions fréquentes
Est-ce vraiment une question d’agents IA, ou de sécurité d’infrastructure en général ? Sécuriser un agent IA en production, c’est appliquer la discipline classique d’infrastructure, permissions au moindre privilège, sauvegardes isolées, confirmation obligatoire avant les actions destructrices, à une nouvelle catégorie d’acteur capable d’agir aussi vite et aussi souvent qu’un script. Ces garde-fous existaient des années avant les agents IA. Ce qui est nouveau, c’est la fréquence à laquelle un identifiant mal cadré est désormais sollicité.
Pourquoi l’identifiant impliqué dans l’incident PocketOS avait-il autant de pouvoir au départ ? Au moment de l’incident d’avril 2026, les jetons en ligne de commande de Railway portaient des permissions globales sur tout le compte, sans moyen intégré de les cadrer sur une tâche plus étroite, comme la seule gestion des noms de domaine. Un jeton émis pour un usage précis était techniquement capable de bien plus, exactement la faille que créent les identifiants mal cadrés et trop larges, peu importe qui, ou quoi, finit par s’en servir.
Donner moins d’accès à un agent IA le rend-il moins utile ? Cadrer les identifiants d’un agent sur ce qu’une tâche exige ne réduit en rien ce que l’agent peut accomplir dans le cadre de cette tâche ; cela retire seulement la possibilité d’atteindre, par accident ou par une décision erronée, des systèmes sans rapport et plus risqués. Un agent bien cadré peut toujours faire son travail entièrement. Il ne peut simplement plus détruire quelque chose situé deux systèmes plus loin que ce qu’on lui a demandé.
Quelle est la différence entre une sauvegarde et de la réplication ? Une sauvegarde est une copie stockée avec une isolation réelle, un fournisseur, un compte ou un chemin d’accès différent, de la ressource qu’elle protège, de sorte que ce qui détruit l’original ne puisse pas atteindre la copie. La réplication maintient un miroir vivant et synchronisé, en général dans le même compte ou système, ce qui protège contre une panne matérielle mais pas contre une seule commande malheureuse ou un identifiant compromis qui atteindrait les deux copies à la fois.
Quel délai faut-il vraiment avant qu’une action destructrice s’exécute ? Même un délai court, des minutes plutôt que des heures, suffit à transformer une erreur instantanée et irréversible en une erreur qu’un humain peut rattraper et annuler, à condition que le système génère aussi une alerte claire pendant cette fenêtre. La durée exacte compte moins que l’existence même de la pause, associée à une étape de confirmation obligatoire pour tout ce qui touche aux données de production.
Ce qu’il faut retenir
Le prochain titre sur un « agent IA devenu incontrôlable » portera un autre nom d’entreprise, une autre plateforme cloud, et probablement un modèle plus capable que celui de l’histoire d’aujourd’hui. La correction de fond, elle, n’aura pas changé : cadrer chaque identifiant sur la tâche la plus étroite dont il a besoin, garder les sauvegardes réellement hors du rayon de destruction de ce qu’elles protègent, et forcer une pause avant tout ce qui est irréversible. Construisez ça une bonne fois pour toutes, et ça tient, peu importe qui, ou quoi, se trouve aux commandes la prochaine fois.