Claude 5 Prompting: Warum alte Gewohnheiten jetzt schaden
Claude 5 Prompting funktioniert anders: Schritt-für-Schritt-Anweisungen, die früher halfen, bremsen das Modell heute aus. Was sich geändert hat.
Jemand, der seit einem Jahr penibel nummerierte Anweisungen für Claude schreibt, öffnet einen neuen Chat, fügt sein altbewährtes Fünf-Schritte-Rezept ein und bekommt etwas seltsam Schlechteres zurück: enger gedacht, zu wörtlich genommen, ohne die Details, die ein kompetenter Assistent eigentlich selbst hätte mitdenken müssen. Der Reflex ist, die Liste noch detaillierter zu machen. Genau dieser Reflex führt in die falsche Richtung. Dahinter steckt etwas, das mit cleveren Formulierungen nichts zu tun hat, aber sehr viel mit einer Einstellung, die kaum jemand kennt und trotzdem ständig berührt: Claude 5 Prompting funktioniert nach anderen Regeln als noch vor einem Jahr.
Der Regler, von dem niemand wusste
Jedes große Sprachmodell beantwortet eine Frage schon werkseitig: Wenn Anweisungen lückenhaft sind, soll das Modell raten und trotzdem weitermachen, oder soll es stoppen und nachfragen? Man kann das den Initiative-Regler nennen. Steht er auf der einen Seite, hält sich das Modell strikt an das, was tatsächlich dasteht, selbst wenn dabei offensichtliche Lücken bleiben. Steht er auf der anderen Seite, füllt das Modell diese Lücken selbstständig, mit eigenem Urteilsvermögen, bis die Aufgabe sinnvoll zu Ende geführt ist.
Dieser Regler ist keine feste Größe. Er ist keine Charaktereigenschaft von “KI” im Allgemeinen, sondern eine Design-Entscheidung, die ein Hersteller für jede Modellgeneration neu trifft, und zwar nicht immer in dieselbe Richtung. Genau das ist die Idee, die hinter jedem einzelnen Prompting-Tipp in diesem Artikel steckt: Der richtige Umgang mit einem Modell ist kein Wissen, das man einmal lernt und dann für immer behält, weil der Hersteller den Regler mit jeder neuen Version wieder anders stellen kann.
Was sich mit Opus 5 und Fable 5.1 geändert hat
Anthropics jüngere Modellgeneration, zu der Claude Opus 5 (inzwischen von Opus 5.5 abgelöst) und die Fable-5-Reihe (Fable 5, dann Fable 5.1) gehören, hat diesen Regler in Richtung Eigeninitiative gedreht. Anthropics Prompting-Leitfaden für Opus 5 schreibt, dass das Modell am besten arbeitet, wenn man ihm die komplette Aufgabenstellung vorab gibt und es dann machen lässt. Der Leitfaden zu Fable 5.1 hält fest, dass dieses Modell sehr lange Aufgaben ohne viele Vorgaben zur Methode ausführen kann, vor allem wenn das Ziel klar ist. Anthropics allgemeine Empfehlungen ziehen zudem allgemeine Anweisungen vorschreibenden Einzelschritten vor, behalten nummerierte Schritte aber für Fälle, in denen Reihenfolge oder Vollständigkeit der Schritte wichtig sind.
Das läuft einer Gewohnheit zuwider, die sich viele Nutzer bei älteren Modellen angeeignet haben: Jeden Schritt auszubuchstabieren war ein gängiger Weg, das Ergebnis zu steuern. Anthropic hält inzwischen fest, dass Claudes Denken häufig über das hinausgeht, was ein Mensch vorschreiben würde, weshalb eine starre Checkliste eher im Weg stehen kann, als zu führen. Eine Liste, die früher Lücken im Urteilsvermögen des Modells ausgleichen sollte, kann dieses Urteilsvermögen am Ende einzäunen.
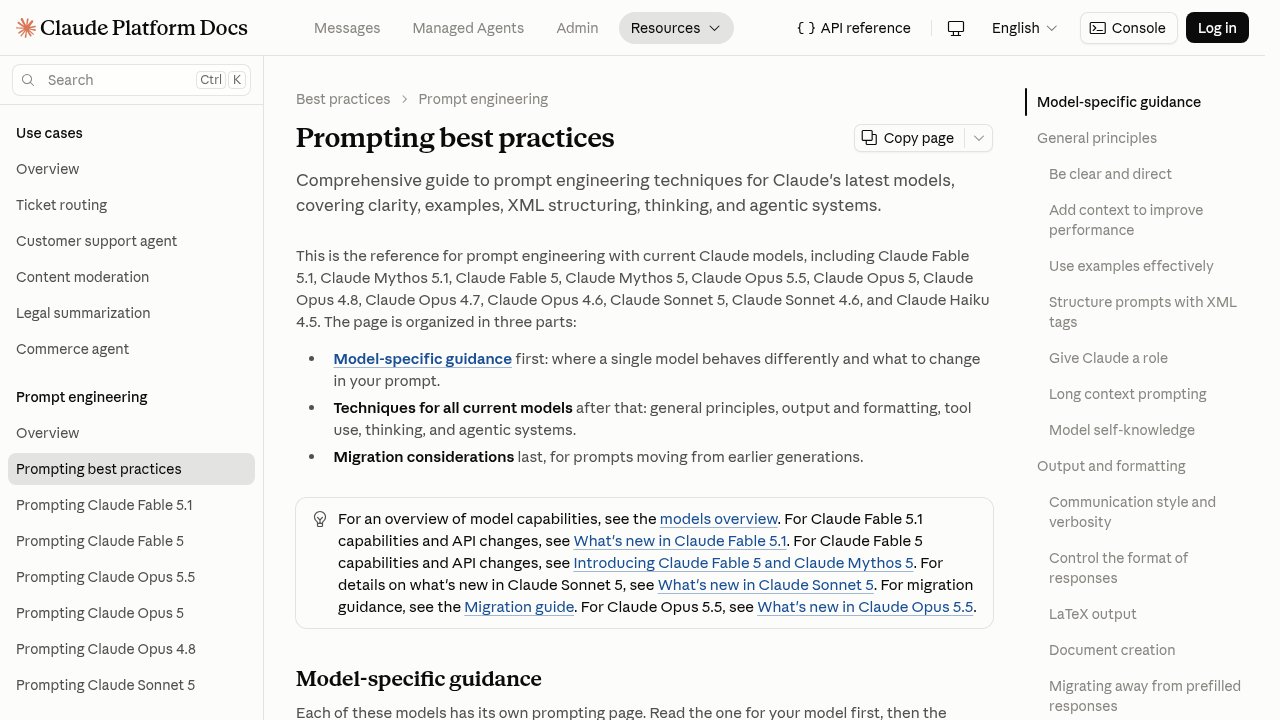 Anthropic Prompting best practices: die offizielle Claude-Platform-Docs-Seite mit modellspezifischen Hinweisen zu Opus 5 und Fable 5.1.
Anthropic bleibt nicht bei dieser allgemeinen Beobachtung fürs Neuschreiben von Prompts stehen. In seinem Prompting-Leitfaden für Claude Fable 5 rät das Unternehmen, bestehende Prompts und “Skills” zu überarbeiten (Anthropics Begriff für gespeicherte, wiederverwendbare Anweisungssets), und merkt an, dass für frühere Modelle entwickelte Skills für das neue Modell oft zu vorschreibend sind und die Qualität der Ergebnisse verschlechtern können. Der Leitfaden empfiehlt, solche älteren Anweisungen zu prüfen und sie gegebenenfalls zu entfernen, wenn das Modell ohne sie besser arbeitet. Der Leitfaden zu Opus 5 geht in dieselbe Richtung: Explizite Prüfanweisungen aus älteren Prompts führen bei Opus 5 zu Überprüfung im Übermaß, und sie zu streichen kostet keine Qualität. Prompts, die bereits auf Fable 5 abgestimmt sind, sollen laut Anthropic dagegen ohne Änderungen auf Fable 5.1 funktionieren. Der gemeinsame Nenner ist eine dokumentierte Empfehlung: Anweisungen, die gestern noch tadellos liefen, aktiv zu überprüfen, weil das Modell, das sie liest, nicht mehr dasselbe Modell ist.
Dem Modell den Grund geben, nicht nur den Auftrag
Wenn die starre Liste nicht mehr funktioniert, was tritt an ihre Stelle? Anthropics Leitfaden zu Fable 5 antwortet darauf in einem Abschnitt mit dem Titel “Give the reason, not only the request”: Das Modell arbeitet tendenziell besser, wenn es die Absicht hinter einer Anfrage versteht. Praktisch heißt das: Man beschreibt die Absicht hinter einer Anfrage, nicht die Abfolge einzelner Handlungen. Welcher größeren Aufgabe dient das Ganze? Für wen ist es gedacht? Wie sieht “fertig” konkret aus? Genau dieser Kontext erlaubt es dem Modell, die vielen kleinen, unausgesprochenen Entscheidungen zu treffen, die jede echte Aufgabe mit sich bringt: genau die Entscheidungen, die ohnehin keine nummerierte Liste vorab hätte auflisten können.
Das klingt banaler, als es ist, denn der gegenteilige Fehler ist nicht “das Modell tut nichts”. Es ist genau umgekehrt.
Das neue Problem: zu viel Eigeninitiative
Weil Opus 5 und die Fable-5-Modelle darauf ausgelegt sind, aus eigenem Antrieb zu handeln, gibt es einen dokumentierten Nebeneffekt: Der Funktionsumfang wächst von selbst, ohne dass jemand danach gefragt hätte. Bei einer nur grob umrissenen Anfrage kann das Modell Dinge hinzufügen, die niemand verlangt hat, etwa nicht angefragte Schritte, eine E-Mail, die niemand bestellt hat, oder einen vorsorglichen Backup-Branch, weil es das für einen Teil einer guten Arbeit hält. Anthropics eigene Lösung dafür ist nicht, die Eigeninitiative wieder herunterzudrehen. Stattdessen soll man von vornherein klare Grenzen setzen: Der Leitfaden zu Opus 5 schlägt vor, das Modell zu bitten, das Verlangte im beabsichtigten Umfang zu liefern, die Aufgabe ganz abzuschließen und vor Handlungen haltzumachen, die klar darüber hinausgehen; der Leitfaden zu Fable 5 empfiehlt, ausdrücklich festzulegen, was das Modell tun soll und was nicht, statt es raten zu lassen, wo die Aufgabe endet.
In der Praxis verschiebt das, wie ein guter Prompt für Claude 5 aussieht. Er wird nicht kürzer, weil Details plötzlich egal wären. Er ist anders aufgebaut: weniger “mach das, dann das, dann das”, mehr “hier ist das Ziel, hier ist die Zielgruppe, so sieht fertig aus, und das hier ist ausdrücklich nicht Teil der Aufgabe”. Die einzelnen Schritte darf man jetzt weglassen. Die Grenzen der Aufgabe darf man nicht mehr weglassen.
Eine andere Technik für wirklich große, unklare Anfragen
Es gibt noch einen Punkt, den man sauber davon trennen sollte, weil er auf den ersten Blick ähnlich klingt, aber ein anderes Problem löst. Anthropics Dokumentation zu Claude Code, gedacht für Software-Aufgaben, empfiehlt für große oder unklare Bauaufträge eine eigene Technik: Claude soll zuerst Rückfragen stellen, zu technischer Umsetzung, Randfällen und Abwägungen, und danach eine vollständige Spezifikation schreiben, statt einfach drauflos zu bauen und dabei Annahmen zu treffen.
Das widerspricht der Empfehlung von oben nicht. Der Rat, Opus 5 gleich die vollständige Aufgabenstellung zu geben, setzt voraus, dass der Umfang der Aufgabe bereits feststeht: Man weiß ungefähr, was man will, und muss es nur noch gut in Worte fassen. Die Interview-Technik greift eine Stufe davor, wenn der Umfang selbst noch unklar ist und erst geklärt werden muss, bevor irgendetwas gebaut wird. Das eine handelt davon, wie man eine Anfrage formuliert, wenn man schon weiß, was man will. Das andere handelt davon, das überhaupt erst herauszufinden. Die beiden zu verwechseln, passiert leicht und sollte vermieden werden: Man sollte Claude nicht bitten, einen bereits vollständig durchdachten Auftrag noch einmal zu hinterfragen, und man sollte einer vagen, halbfertigen Idee auch keine starre Spezifikation überstülpen und erwarten, dass die Lücken schon richtig gefüllt werden.
Warum derselbe Trick bei ChatGPT nicht funktioniert
An dieser Stelle hört der Initiative-Regler auf, eine reine Anthropic-Eigenheit zu sein, und wird zu einer allgemeineren Lehre. OpenAI hat GPT-6 Astra laut Presseberichten Anfang September 2026 veröffentlicht und bezeichnet es als sein bisher intelligentestes Modell. Der zugehörige Prompting-Leitfaden gibt keine feste Vorlage vor, seine Beispiel-Prompts decken aber ähnliches Terrain ab: die beabsichtigte Aufgabe des Nutzers zu Ende führen, Absicht und Umfang aus dem Kontext erschließen, weitermachen, solange eine Aktion nicht eindeutig destruktiv oder irreversibel ist, und die Anweisungen des Nutzers über die Vorgaben eines Skills stellen.
Das klingt ähnlich wie die Grenzen-Empfehlung für Claude 5. Nur steht der Regler hier in die entgegengesetzte Richtung. GPT-6 Astras dokumentiertes Standardverhalten neigt dazu, eher nachzufragen, statt selbst zu entscheiden, genau umgekehrt zu Opus 5, das mit einer unvollständigen Vorgabe lieber gleich loslegt. Die Modellseite von OpenAI hält fest, dass es eher um Klärung bittet, wo frühere Modelle Annahmen getroffen hätten, und der Leitfaden bietet Entwicklern, die eigenständigeres Arbeiten wollen, einen Prompt an, der das Modell zum Handeln anhält und es davon abhält, bei einer Zusage, einem Plan oder dem Angebot weiterzumachen stehen zu bleiben.
 Best practices for prompt engineering with the OpenAI API: OpenAIs allgemeiner Hilfeartikel zum Prompt Engineering mit seiner API; die Besonderheiten von GPT-6 Astra stehen im Prompting-Leitfaden.
Genau diese Symmetrie, und die Unstimmigkeit darin, ist die eigentliche Falle. Eine Gewohnheit, die Claude 5s Hang zum Zuviel-Machen zügeln soll, etwa enge, explizite Grenzen und eine strikte Definition von “fertig”, repariert nicht automatisch GPT-6 Astras entgegengesetzten Hang, erst nachzufragen und dann zu handeln. Wendet man Grenzen-lastiges Prompting auf ein Modell an, das ohnehin eher nachfragt, entsteht nur zusätzliche Reibung, ohne das eigentliche Problem zu lösen: das Modell dazu zu bringen, sich festzulegen und zu handeln. Beide Hersteller dokumentieren inzwischen Wege, wie Nutzer die Eigeninitiative des Modells selbst kalibrieren, aber die Werkseinstellung der beiden Flaggschiffe zeigt jeweils in eine andere Richtung, und ein Fix für die eine Richtung überträgt sich nicht auf die andere.
Häufig gestellte Fragen
Was sind Opus 5 und Fable 5.1 bei Claude 5, ganz einfach erklärt?
Opus 5 und Fable 5.1 sind zwei Modelle aus Anthropics jüngerer Claude-Generation (Opus 5 wurde inzwischen von Opus 5.5 abgelöst). Wichtiger als der Name ist fürs Prompting das Verhalten: Anthropics Dokumentation sagt, Opus 5 arbeitet am besten, wenn man ihm vorab die vollständige Aufgabenstellung gibt und es dann machen lässt, und Fable 5.1 kann lange Aufgaben ohne viele Vorgaben zur Methode ausführen, wenn das Ziel klar ist.
Warum macht ein detaillierter Schritt-für-Schritt-Prompt Claude 5 schlechter?
Nummerierte Listen für ältere Modelle buchstabierten oft jeden Schritt aus, um das Ergebnis zu steuern. Anthropic merkt an, dass für frühere Modelle entwickelte Skills für Claude Fable 5 oft zu vorschreibend sind und die Qualität verschlechtern können, und dass Claudes Denken häufig über das hinausgeht, was ein Mensch vorschreiben würde. Eine starre Liste kann deshalb das Urteilsvermögen des Modells einschränken, statt eine Lücke zu füllen, und ein engeres oder zu wörtliches Ergebnis liefern, als eine offene, gut mit Kontext versehene Anfrage es täte.
Wie verhindere ich, dass Claude 5 Dinge hinzufügt, die ich nicht wollte?
Dass Claude 5 den Aufgabenumfang ungefragt erweitert, ist ein dokumentierter Nebeneffekt seiner Verschiebung hin zu eigeninitiativem Handeln statt explizitem Abwarten. Anthropics Lösung dafür sind klare Grenzen und ein ausdrücklich eingegrenzter Umfang direkt im Prompt, etwa die Bitte, das Verlangte im beabsichtigten Umfang zu liefern, nicht eine längere Schrittliste, damit das Modell weiß, wo die Aufgabe endet.
Funktioniert derselbe Prompting-Stil auch bei GPT-6 Astra?
Nein. GPT-6 Astras dokumentierte Standardeinstellung neigt in die entgegengesetzte Richtung wie Claude 5 und stellt eher Rückfragen, statt auf Annahmen loszulegen. OpenAIs eigene Anleitung bietet für Anwendungen, die mehr Eigenständigkeit brauchen, einen Prompt an, der das Modell dazu bringt, Absichten selbst zu erschließen und eher zu handeln; das ist eine andere Lösung als die Grenzen-Gewohnheit, die bei Claude 5s Hang zum Zuviel-Machen greift.
Sollte ich alte Claude-Prompts und gespeicherte Skills für das neue Modell überarbeiten?
Weitgehend ja, laut Anthropics Leitfaden für Claude Fable 5: Für frühere Modelle entwickelte Skills sind für das neue Modell oft zu vorschreibend und können die Qualität verschlechtern, daher die Empfehlung, sie zu prüfen und ältere Anweisungen gegebenenfalls zu entfernen, wenn das Modell ohne sie besser arbeitet. Bei Opus 5 empfiehlt Anthropic zudem, aus älteren Prompts übernommene Prüfanweisungen zu streichen. Prompts, die bereits auf Fable 5 abgestimmt sind, sollen dagegen ohne Änderungen auf Fable 5.1 funktionieren.