Bonnes pratiques de prompting Claude 5 : pourquoi vos réflexes d'hier ratent
Les bonnes pratiques de prompting Claude 5 ont changé en douce : le script étape par étape qui marchait hier bride le modèle aujourd'hui. Voici pourquoi.
Quelqu’un qui écrit depuis un an des instructions minutieuses et numérotées pour Claude ouvre une nouvelle conversation, colle sa recette habituelle en cinq étapes, et récupère un résultat étrangement moins bon que prévu : plus étroit, plus littéral, avec des trous qu’un bon assistant aurait dû combler tout seul. Le réflexe, c’est d’écrire une liste encore plus détaillée. Ce réflexe est exactement à l’envers, et il pointe vers quelque chose qui mérite d’être compris sur les bonnes pratiques de prompting Claude 5 : ça n’a rien à voir avec une formule magique, et tout à voir avec un réglage que la plupart des gens ne savent même pas qu’ils touchent.
Le curseur dont personne ne vous a parlé
Chaque grand modèle de langage embarque une réponse par défaut à une question précise : quand les instructions sont incomplètes, le modèle doit-il deviner et avancer, ou s’arrêter et demander ? Appelons ça le curseur d’initiative. Poussé d’un côté, le modèle joue la prudence et colle exactement à ce qui est écrit, quitte à laisser des trous évidents. Poussé de l’autre, il comble ces trous lui-même, en s’appuyant sur son propre jugement pour mener la tâche à un résultat sensé.
Ce curseur n’a rien de figé. Ce n’est pas un trait de caractère de « l’IA » en général, c’est un choix de conception que chaque fournisseur fait pour chaque génération de modèle — et ce choix change d’une version à l’autre, parfois du tout au tout. Voilà l’idée qui tient tous les conseils de prompting de cet article : la bonne façon de prompter un modèle est une cible mouvante, pas une compétence qu’on apprend une fois pour toutes, parce que le modèle en face continue de changer son propre réglage.
Ce qui a changé avec Opus 5 et Fable 5.1
La génération récente d’Anthropic, qui comprend Claude Opus 5 (remplacé depuis par Opus 5.5) et la lignée Fable 5 (Fable 5, puis Fable 5.1), a poussé ce curseur vers l’initiative. Le guide de prompting d’Anthropic pour Opus 5 indique que le modèle donne son meilleur quand on lui confie la spécification complète de la tâche dès le départ, puis qu’on le laisse travailler. Le guide de Fable 5.1 précise que ce modèle peut mener de très longues tâches sans beaucoup d’indications sur la méthode, surtout quand l’objectif est clair. La doctrine générale d’Anthropic ajoute une préférence pour des consignes générales plutôt que des étapes prescriptives, tout en gardant les listes numérotées pour les cas où l’ordre ou l’exhaustivité des étapes compte.
Cela va à rebours d’une habitude prise par beaucoup d’utilisateurs avec les anciens modèles, pour qui détailler chaque étape était une façon courante d’orienter le résultat. Anthropic note désormais que le raisonnement de Claude « dépasse fréquemment ce qu’un humain prescrirait », si bien qu’une checklist rigide peut gêner au lieu de guider. Une liste qui compensait autrefois les manques de jugement du modèle peut finir par enfermer ce jugement.
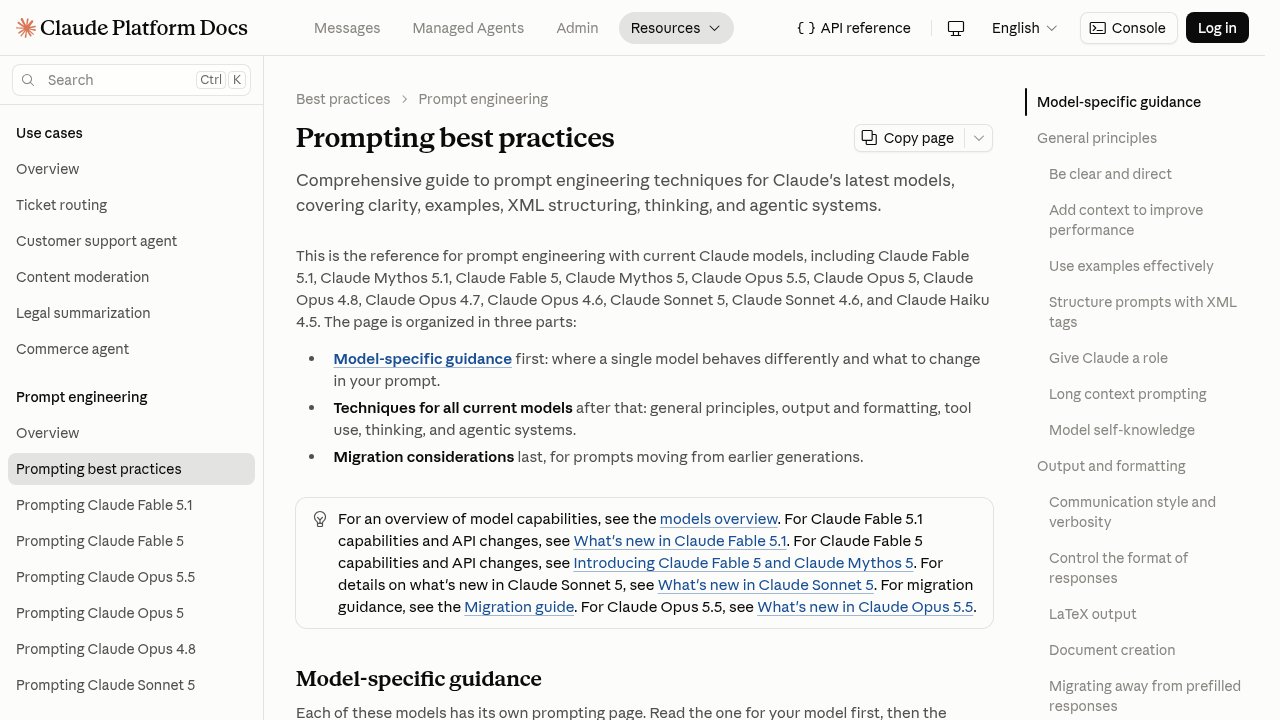 Anthropic Prompting best practices — la page officielle de la documentation Claude Platform qui couvre les recommandations spécifiques à Opus 5 et Fable 5.1.
Anthropic ne se contente pas d’une remarque générale sur l’écriture de nouveaux prompts. Dans son guide de prompting pour Claude Fable 5, l’entreprise conseille de remanier les prompts et les « skills » existants (son terme pour des jeux d’instructions réutilisables, enregistrés et repris d’une tâche à l’autre), en notant que les skills développés pour les modèles précédents sont souvent trop prescriptifs pour le nouveau modèle et peuvent dégrader la qualité du résultat. Le guide recommande de revoir ces anciennes instructions et d’envisager de les retirer si le modèle fait mieux sans elles. Le guide d’Opus 5 va dans le même sens : les consignes de vérification explicites héritées d’anciens prompts provoquent une sur-vérification sur Opus 5, et les retirer ne coûte rien en qualité. En revanche, selon Anthropic, les prompts déjà calibrés pour Fable 5 devraient fonctionner sur Fable 5.1 sans modification. Le fil conducteur reste une recommandation documentée de retourner auditer des instructions qui fonctionnaient très bien hier, parce que le modèle qui les lit n’est plus le même.
Donner la raison, pas seulement la demande
Si la liste rigide ne marche plus, qu’est-ce qui la remplace ? Le guide de Fable 5 y répond dans une section intitulée « Give the reason, not only the request » : le modèle tend à mieux travailler quand il comprend l’intention derrière une demande. Concrètement, il s’agit de décrire l’intention derrière une demande plutôt qu’une suite d’actions. À quelle tâche plus large ça sert ? Pour qui c’est fait ? À quoi ressemble un travail « terminé » ? C’est ce contexte qui permet au modèle de prendre les dizaines de petites décisions non écrites que toute vraie tâche implique — celles qu’aucune liste numérotée n’aurait pu prévoir à l’avance de toute façon.
Ce point compte plus qu’il n’y paraît, parce que le mode d’échec inverse n’est pas « le modèle ne fait rien ». C’est tout le contraire.
Le nouveau mode d’échec : trop en faire
Puisque Opus 5 et les modèles Fable 5 sont conçus pour agir de leur propre initiative, un effet de bord documenté est un débordement de périmètre que personne n’a demandé. Face à une demande vaguement définie, le modèle peut ajouter des choses que personne n’a réclamées (des étapes non demandées, un e-mail rédigé alors qu’on n’en voulait pas, une branche de sauvegarde par précaution), parce qu’il a jugé que ça faisait partie du travail bien fait. Le remède d’Anthropic n’est pas de rebaisser le curseur d’initiative. C’est de poser des limites explicites dès le départ : le guide d’Opus 5 suggère de demander au modèle de livrer ce qui a été demandé, au périmètre voulu, d’aller au bout de la tâche et de s’arrêter avant toute action qui la dépasse clairement, et le guide de Fable 5 recommande de définir explicitement ce que le modèle doit faire et ne pas faire, plutôt que de le laisser deviner où s’arrête la tâche.
En pratique, ça redéfinit à quoi ressemble un bon prompt pour Claude 5. Il n’est pas plus court parce que le détail ne compterait plus. Il est structuré autrement : moins de « fais ça, puis ça, puis ça », plus de « voici l’objectif, voici pour qui c’est, voici à quoi ressemble le résultat fini, et voici ce qui est hors sujet ». Les étapes, c’est ce qu’on peut désormais omettre. Les limites de la tâche, c’est ce qu’on ne peut plus se permettre de sauter.
Une autre technique, pour les demandes vraiment vastes et floues
Un point mérite d’être isolé clairement, parce qu’il ressemble au conseil précédent tout en réglant un problème différent. La documentation de Claude Code, orientée développement logiciel, recommande une technique distincte pour les demandes de construction larges ou ambiguës : faire en sorte que Claude interroge d’abord l’utilisateur, en l’interrogeant sur l’implémentation technique, les cas limites et les arbitrages, puis en rédigeant une spécification complète, plutôt que de se lancer à construire sur de simples suppositions.
Ce n’est pas une contradiction avec le conseil de la spécification complète vu plus haut. Ce conseil-là suppose que le périmètre de la tâche est déjà arrêté : l’utilisateur sait à peu près ce qu’il veut et n’a plus qu’à bien le formuler. La technique de l’interrogatoire, elle, intervient à l’étape d’avant, quand le périmètre lui-même reste flou et mérite d’être clarifié avant que quoi que ce soit ne commence. L’un porte sur la manière de formuler une demande une fois qu’on sait ce qu’on veut. L’autre porte sur la façon de découvrir ce qu’on veut, au départ. Il est facile de confondre les deux, et ça vaut la peine d’éviter ce piège : ne demandez pas à Claude de vous interroger sur une tâche que vous avez déjà entièrement cadrée, et ne tendez pas une idée à moitié formée à une spécification rigide en espérant qu’elle comblera les trous correctement.
Pourquoi ce même remède ne marche pas sur ChatGPT
C’est ici que le curseur d’initiative cesse d’être une bizarrerie propre à Anthropic pour devenir une leçon générale. OpenAI a sorti GPT-6 Astra début septembre 2026, selon la presse, et le présente comme son modèle le plus intelligent à ce jour. Sa documentation de prompting n’impose pas de modèle de prompt figé, mais les exemples qu’elle propose couvrent un terrain proche : mener la tâche voulue par l’utilisateur jusqu’au bout, déduire l’intention et le périmètre du contexte, avancer sauf si une action est clairement destructrice ou irréversible, et faire primer les instructions de l’utilisateur sur les consignes d’un skill.
Cela ressemble aux conseils sur les limites qu’on donne à Claude 5. Sauf que le curseur est réglé dans le sens opposé. Le comportement par défaut documenté de GPT-6 Astra penche vers le fait de poser des questions de clarification plutôt que de décider seul — l’inverse exact de la tendance d’Opus 5 à foncer sur un brief incomplet. La page du modèle indique qu’il demande plus volontiers des précisions là où les modèles précédents faisaient des suppositions, et la documentation d’OpenAI propose, pour les développeurs qui veulent un travail plus autonome, un prompt qui demande au modèle de privilégier l’action et de ne pas s’arrêter à confirmer qu’il peut le faire, à proposer un plan ou à offrir de continuer.
 Best practices for prompt engineering with the OpenAI API — l’article général du centre d’aide d’OpenAI sur le prompt engineering avec son API ; les spécificités de GPT-6 Astra sont dans sa documentation de prompting.
Cette symétrie, et le décalage qu’elle cache, forment le piège pratique à connaître. Une habitude construite pour brider la tendance de Claude 5 à trop en faire — des limites explicites lourdes, une définition stricte du « terminé » — ne corrigera pas automatiquement la tendance inverse de GPT-6 Astra à demander avant d’agir. Appliqué à un modèle qui penche déjà vers les questions, un prompt chargé de garde-fous ne fait qu’ajouter de la friction, sans résoudre le vrai problème : obtenir que le modèle s’engage et agisse. Les deux fournisseurs documentent désormais des moyens de calibrer le niveau d’initiative du modèle, mais le réglage d’usine de chaque modèle phare penche dans un sens différent, et un correctif pensé pour une direction ne se transpose pas à l’autre.
Questions fréquentes
Que sont Opus 5 et Fable 5.1, les modèles de Claude 5, en clair ?
Opus 5 et Fable 5.1 sont deux modèles de la génération récente de Claude chez Anthropic (Opus 5 a depuis été remplacé par Opus 5.5). Le détail qui compte vraiment pour le prompting n’est pas le nom, mais le comportement : la documentation d’Anthropic indique qu’Opus 5 donne son meilleur avec la spécification complète de la tâche fournie d’emblée, puis qu’on le laisse travailler, et que Fable 5.1 peut mener de longues tâches sans beaucoup d’indications sur la méthode quand l’objectif est clair.
Pourquoi un prompt détaillé et numéroté ferait-il moins bien performer Claude 5 ?
Les listes numérotées écrites pour d’anciens modèles détaillaient souvent chaque étape pour orienter le résultat. Anthropic note que les skills développés pour les modèles précédents sont souvent trop prescriptifs pour Claude Fable 5 et peuvent dégrader la qualité du résultat, et que le raisonnement de Claude dépasse fréquemment ce qu’un humain prescrirait. Une liste rigide peut donc réduire le jugement du modèle au lieu de combler un manque, et produire un résultat plus étroit ou plus littéral qu’une demande ouverte et bien mise en contexte.
Comment empêcher Claude 5 d’ajouter des choses que je n’ai pas demandées ?
La tendance de Claude 5 à élargir le périmètre sans qu’on le lui demande est un effet de bord documenté de son penchant pour l’initiative plutôt que l’attente d’instructions explicites. Le remède d’Anthropic consiste à poser des limites claires et à cadrer explicitement le périmètre directement dans le prompt, par exemple en demandant au modèle de livrer ce qui a été demandé, au périmètre voulu, plutôt qu’à allonger la liste d’étapes, pour que le modèle sache où s’arrête la tâche.
Le même style de prompting fonctionne-t-il sur GPT-6 Astra ?
Non. Le comportement par défaut documenté de GPT-6 Astra penche dans le sens opposé à celui de Claude 5 : il pose plus souvent des questions de clarification plutôt que d’agir sur des suppositions. La documentation d’OpenAI propose, pour les applications qui ont besoin de plus d’autonomie, un prompt qui pousse le modèle à déduire l’intention et à privilégier l’action : un remède différent de l’habitude à poser des limites qui fonctionne, elle, sur le penchant trop entreprenant de Claude 5.
Faut-il réécrire ses anciens prompts et skills Claude pour le nouveau modèle ?
En grande partie oui, selon le guide d’Anthropic pour Claude Fable 5 : les skills développés pour les modèles précédents sont souvent trop prescriptifs pour le nouveau modèle et peuvent dégrader la qualité du résultat, d’où la recommandation de les revoir et d’envisager de retirer les anciennes instructions si le modèle fait mieux sans elles. Sur Opus 5, Anthropic recommande aussi de retirer les consignes de vérification héritées d’anciens prompts. Les prompts déjà calibrés pour Fable 5 devraient en revanche fonctionner sur Fable 5.1 sans modification.