KI-Crawler treiben deine Hosting-Kosten hoch, nicht nur die SEO-Bilanz
KI-Crawler tauchen massenhaft in Server-Logs auf. Entscheidend ist nicht die Menge, sondern welche Seiten sie treffen und warum das die Hosting-Kosten bestimmt.
Wer eine Website betreibt, hatte schon immer auch nicht-menschliche Besucher. Suchmaschinen crawlen das Web seit Jahrzehnten, ohne dass deswegen jemand auf die Rechnung geschaut hätte. Neu ist, wer heute anklopft und wo genau. Immer mehr Betreiber bemerken, dass KI-Crawler als spürbarer Posten in der Hosting-Rechnung auftauchen, und der Grund dafür ist nicht in erster Linie die Menge der Anfragen. Es ist die Frage, welche Seiten getroffen werden. Ein Crawler, der deinen statischen Blogartikel liest, kostet fast nichts. Derselbe Crawler, der sich an deinem Warenkorb festbeißt, kann still und leise zum teuersten Traffic auf der ganzen Seite werden.
Genau darin liegt die eigentliche Geschichte. Die reine Zahl der Requests klingt dramatisch in einer Schlagzeile, sagt aber fast nichts darüber aus, was am Ende auf der Rechnung steht. Zwei Websites können exakt gleich viele KI-Crawler-Besuche bekommen und trotzdem bei völlig unterschiedlichen Hosting-Kosten landen, einzig weil die Crawler auf unterschiedlichen URLs gelandet sind. Dieselbe Logik bestimmt bereits Entscheidungen bei der Frage, ob Teams lokale KI-Hardware kaufen oder Cloud-Kapazität mieten: Die Kosten stecken nie im Traffic selbst, sondern in dem, was dieser Traffic die Maschine tatsächlich rechnen lässt.
Warum derselbe Crawler auf einer Seite nichts kostet und auf der nächsten teuer wird
Ein Crawler ist schlicht ein automatisiertes Programm, das Seite für Seite abruft, dieselbe Softwarekategorie, die auch Google zum Indexieren des Webs nutzt. Ruft ein Crawler eine normale Artikelseite auf, liefert die meisten Hosting-Setups sie aus einem Cache aus, einer fertigen Kopie der Seite, die bereitliegt, damit der Server sie nicht bei jeder Anfrage neu zusammenbauen muss. Eine gecachte Seite auszuliefern kostet einen Bruchteil eines Cents an Rechenzeit. Es ist das digitale Äquivalent zum Aushändigen einer Fotokopie.
Ein Endpoint dagegen ist eine bestimmte Adresse auf der Website, die echte Arbeit auf dem Server auslöst, statt einfach eine gespeicherte Datei zurückzugeben. Ein Warenkorb, eine Checkout-Seite, ein Login-Formular, eine Suchmaske, eine Seite, die Versandkosten berechnet: All das sind Endpoints, die sich in der Regel nicht cachen lassen, weil die Antwort für jeden Besucher und jede Sitzung anders ausfällt. Eine solche Anfrage zu bedienen heißt, Datenbankabfragen auszuführen, Lagerbestände zu prüfen, mitunter eine temporäre Session zu öffnen, die verwaltet und irgendwann wieder aufgeräumt werden muss. Das kann pro einzelner Anfrage zehn- bis hundertmal mehr Serverressourcen kosten als eine gecachte Seite.
Genau dieser Mechanismus steckt hinter den Kostenspitzen, über die Hosting-Anbieter zunehmend berichten. Ein Crawler, der nur veröffentlichte Artikel anfasst, ist, was die Kosten angeht, praktisch identisch mit einem Suchmaschinen-Crawler, der seit zwanzig Jahren das Web indexiert. Ein Crawler, der immer wieder auf Warenkorb- oder Checkout-Logik trifft, macht dagegen etwas grundlegend anderes, weil jede dieser Anfragen den Server zu Arbeit zwingt, die sich weder überspringen noch vorausberechnen lässt.
Was tatsächlich passiert ist, und warum die Zahlen eines Hosters mit Vorsicht zu lesen sind
Kinsta, ein Webhosting-Unternehmen, hat Zahlen veröffentlicht, die zeigen sollen, was seine Infrastruktur an KI-Crawler-Traffic beobachtet. Die Zahlen sind konkret genug, um sie zu nennen, mit einem Vorbehalt, der jedes Mal mitgedacht werden muss: Kinsta verkauft eine Anti-Bot-Funktion für sein Control Panel, die am 9. Juni 2026 gestartet ist. Die eigenen Daten stammen also von einem Anbieter mit einem handfesten kommerziellen Interesse daran, KI-Crawler-Traffic größer klingen zu lassen, als das Problem für die einzelne Website tatsächlich sein mag. Das macht die zugrunde liegenden Zahlen nicht falsch, aber sie sollten als die Sicht eines einzelnen Unternehmens gelesen werden, nicht als unabhängige Branchenmessung.
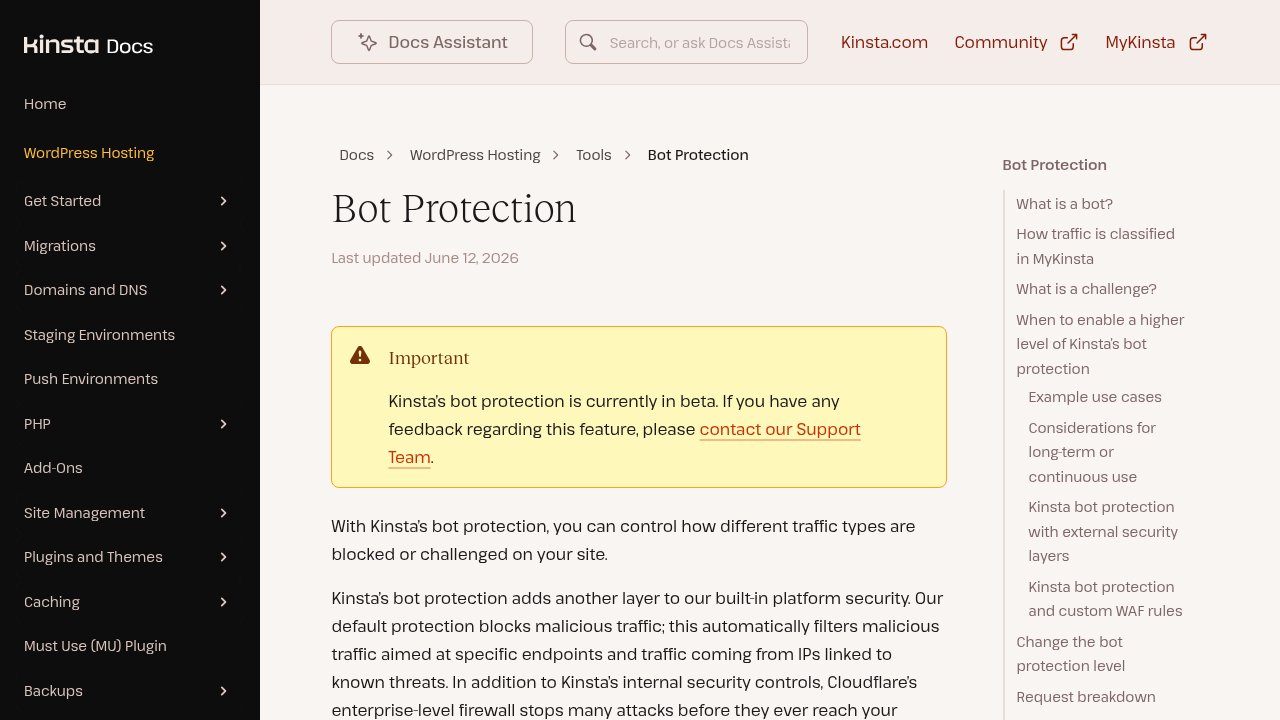 Kinsta — das Bot-Protection-Panel, das parallel zu den eigenen KI-Crawler-Zahlen verkauft wird.
Vor diesem Hintergrund lohnen sich zwei von Kinstas gemeldeten Fällen, gerade weil sie konkret sind, nicht weil sie typisch wären. Auf einer der von Kinsta gehosteten Seiten hat ClaudeBot, der von Anthropic betriebene Web-Crawler, innerhalb von 24 Stunden 3,75 Millionen Anfragen an eine Warenkorb-Seite ausgelöst, laut den von Kinsta veröffentlichten Zahlen, die auch vom Fachmedium ppc.land aufgegriffen wurden. Auf einer anderen Seite beschreibt Kinsta einen Crawler, der sich in einer sogenannten Schleife verfangen hatte, ein Crawling-Muster, das immer wieder zu Seiten zurückkehrt, die aufeinander verlinken, mit rund 550 Millionen Anfragen über 30 Tage. Beides sind einzelne, namentlich benannte Vorfälle auf bestimmten Websites, keine statistische Norm, die auf der eigenen Seite zu erwarten wäre. Ein Crawler, der sich so an einem Warenkorb-Endpoint festbeißt, ist ein reales Kostenrisiko, gegen das man sich absichern sollte, aber kein Beleg dafür, dass KI-Bots das üblicherweise tun.
Zu Kinstas Ehrenrettung: Die eigene Führung war transparent, was die Grenzen des kommerziellen Blickwinkels angeht. Der Technikchef des Unternehmens erklärte, als Kinsta im November 2025 eine bandbreitenbasierte Preisgestaltung einführte, dass Kinsta Kunden nicht für die von KI-Crawlern verbrauchte Bandbreite berechnet und standardmäßig auf Plattformebene keinen Traffic blockiert. Die verkaufte Anti-Bot-Funktion ist also eine Kontrolle, die der Seitenbetreiber bewusst einschaltet, keine nach Crawler-Traffic abgerechnete Zusatzleistung. Das ist eine deutlich andere Haltung, als leise an genau dem Problem mitzuverdienen, vor dem man warnt, aber es lohnt sich trotzdem, bei jeder Kinsta-Zahl im Kopf zu behalten, dass das Unternehmen ein Problem beschreibt, für das es auch die Lösung verkauft.
Die eine Zahl aus neutraler Quelle, und was sie wirklich zeigt
Unabhängig von Kinstas Fällen gibt es eine Zahl, der mehr Vertrauen zusteht, weil sie von einer Quelle ohne eigenes Anti-Bot-Produkt stammt. Cloudflare Radar, der Analyse-Arm des Infrastrukturanbieters Cloudflare, der aggregierten Traffic über Millionen Websites hinweg sieht, dokumentiert, dass der gesamte Crawler-Traffic zwischen Mai 2024 und Mai 2025 um 18 Prozent gewachsen ist, und dass innerhalb dieses Wachstums GPTBot, der Crawler von OpenAI, im selben Zeitraum um 305 Prozent zulegte, verglichen mit 96 Prozent Wachstum bei Googles eigenem Crawler. Über das gesamte Kalenderjahr 2025 lag Googlebot laut Cloudflares eigenen Radar-Daten bei über 28 Prozent des verifizierten Bot-Traffics, GPTBot bei rund 7,5 Prozent und Bingbot bei 6 Prozent. Das Crawl-Volumen von ClaudeBot verdoppelte sich in etwa in der ersten Jahreshälfte, bevor es in der zweiten wieder zurückging, wobei Cloudflare dafür keinen vergleichbaren Jahreswert veröffentlicht hat.
 Cloudflare Radar — aggregierte Crawler-Traffic-Daten über Millionen Websites, ohne eigenes Anti-Bot-Produkt im Angebot.
Diese Wachstumsrate ist auf eine Art belastbar, wie es die Warenkorb-Anekdote eines einzelnen Unternehmens nicht ist: Sie beschreibt eine echte Verschiebung, wer das Web crawlt, verifiziert über eine riesige Stichprobe ohne Anreiz zur Übertreibung. Was sie nicht zeigt, ist, ob dieses Wachstum ausgerechnet die teuren Endpoints der eigenen Website trifft. Ein Crawler kann um 305 Prozent wachsen und trotzdem nichts kosten, wenn er nur gecachte Seiten anfasst. Die Cloudflare-Zahl erklärt, warum KI-Crawler heute einen relevanten Anteil am Traffic ausmachen. Sie erklärt für sich genommen nicht, warum manche Seitenbetreiber plötzlich Kostenspitzen in der Hosting-Rechnung sehen. Dieser zweite Teil hängt an der Endpoint-Exposition, nicht an der Popularität des Crawlers.
Manche allgemeine Presseberichterstattung geht noch weiter und behauptet, automatisierter Bot-Traffic, KI-bezogen oder nicht, übersteige inzwischen den menschlichen Traffic im gesamten Web. Diese Aussage stammt aus Branchenberichten und Presseanalysen, nicht aus Kinstas Messungen oder den oben zitierten crawlerspezifischen Zahlen von Cloudflare Radar, und sollte eher als grobe, umstrittene Schätzung behandelt werden denn als gesicherte Tatsache, da Bot-Traffic in solchen Berichten alles umfasst, von der Suchindexierung über Betrugsversuche bis zu Monitoring-Tools, eine deutlich weitere Kategorie als KI-Crawler allein.
Zwei getrennte Probleme mit derselben Beschwerde
Der praktische Fehler, den die meisten Seitenbetreiber machen, ist, KI-Crawler als eine einzige Entscheidung zu behandeln: blockieren oder nicht. Diese Einteilung wirft zwei grundverschiedene Probleme in einen Topf, und die richtige Antwort auf das eine sieht aus wie die richtige Antwort auf das andere, ist es aber nicht.
Das erste Problem ist allgemeiner Missbrauch durch Bot-Automatisierung: aggressives Scraping, Credential-Stuffing-Versuche, Scalping-Bots, oder ein Crawler, KI-bezogen oder nicht, der sich in einer Schleife verfängt und immer wieder dieselben Seiten trifft, das Muster hinter Kinstas Fall mit 550 Millionen Anfragen. Das ist ein Problem von Anfragerate und Zugriffskontrolle. Die Lösung besteht darin, zu begrenzen, wie schnell ein einzelner automatisierter Client Seiten anfragen darf, und teure, nicht cachebare Endpoints wie Checkout- und Konto-Seiten von allem fernzuhalten, was sie nicht erreichen muss. Ein Tool wie Kinstas neuer Dashboard-Schalter, oder die vergleichbare Funktion bei den meisten modernen Hostern, setzt genau hier an: Regeln nach Pfad, sodass ein Crawler gezielt an einer Warenkorb- oder Checkout-Adresse gebremst oder abgewiesen werden kann, ohne den Rest der Seite anzufassen.
Das zweite Problem ist KI-Training und Zitations-Crawling: die Frage, ob das Modell eines Unternehmens die eigenen Inhalte überhaupt lesen darf, sei es zum Training oder um Fragen mit einer Quellenangabe zurück zur eigenen Seite zu beantworten. Das ist ein Problem der Policy und Sichtbarkeit, kein Kostenproblem, und es wird über einen völlig anderen, viel älteren Mechanismus geregelt: die robots.txt, eine schlichte Textdatei, die jede Website veröffentlichen kann und die benannten Crawlern mitteilt, welche Bereiche sie besuchen dürfen und welche nicht. GPTBot in der robots.txt zu sperren, weil man nicht möchte, dass OpenAI mit den eigenen Inhalten trainiert, ist eine legitime, durchdachte Entscheidung. Sie hilft aber nicht dagegen, dass ein anderer, sich falsch verhaltender Crawler weiter auf dem Warenkorb-Endpoint hängen bleibt, denn nicht jeder automatisierte Client hält sich an diese Datei, und die Datei war von Anfang an nie als Ratenbegrenzung gedacht.
Wer die beiden Probleme vermischt, trifft in beide Richtungen falsche Entscheidungen: Seitenbetreiber, die jeden KI-Crawler anhand seines User-Agents blockieren, jener Kennung, mit der sich ein Crawler selbst identifiziert, verlieren dabei legitimen Zitations-Traffic und Empfehlungswert, während die tatsächlich teuren Endpoints weiterhin offenstehen für alles, was den Block ignoriert. Oder umgekehrt: Betreiber, die überall Ratenlimits setzen, auch auf gecachten Seiten, die nie ein Kostenrisiko waren, während die eigentliche Frage nach Trainingszustimmung und Zitation nie angefasst wird.

FAQ
Was genau ist das Problem mit KI-Crawlern und Hosting-Kosten?
Das Muster dahinter: Web-Crawler von KI-Unternehmen wie GPTBot oder ClaudeBot lösen so viele Anfragen an dynamische Seiten einer Website aus, etwa Warenkorb, Checkout oder Suche, dass Serverlast und Hosting-Kosten spürbar steigen, obwohl derselbe Crawler auf statischen, gecachten Seiten fast nichts kostet. Die Kosten entstehen dadurch, welche Seiten getroffen werden, nicht dadurch, dass der Crawler existiert.
Sollte ich einfach alle KI-Crawler in der robots.txt blockieren?
Alle KI-Crawler in der robots.txt zu blockieren, der Textdatei, die automatisierten Besuchern mitteilt, welche Seiten sie aufrufen dürfen, ist eine berechtigte Entscheidung, wenn die eigenen Inhalte nicht in KI-Trainingsdaten landen sollen. Ein Kosten- oder Performance-Problem löst das nicht, denn nicht jeder automatisierte Traffic hält sich an diese Datei, und ein Crawler, der bereits auf einem teuren Endpoint hängt, lässt sich damit nicht stoppen.
Ist ClaudeBot oder GPTBot schlechter für die Hosting-Kosten als der jeweils andere?
Keiner der beiden Crawler ist grundsätzlich teurer für die Hosting-Kosten als der andere. Die gemeldeten Kostenspitzen, darunter ein dokumentierter Fall, in dem ClaudeBot innerhalb von 24 Stunden 3,75 Millionen Anfragen an eine Warenkorb-Seite auf der Infrastruktur eines Hosters ausgelöst hat, hängen davon ab, welche Endpoints ein Crawler zufällig auf einer bestimmten Website trifft, nicht von einem durchgängigen Unterschied im Verhalten zwischen den Crawlern von OpenAI und Anthropic.
Wie finde ich heraus, ob KI-Crawler mich auf meiner eigenen Website Geld kosten?
Der Check beginnt bei den eigenen Server-Zugriffslogs: nach Anfragen bekannter KI-Crawler-User-Agents wie GPTBot oder ClaudeBot suchen und prüfen, welche URLs sie am häufigsten treffen. Landen sie überwiegend auf gecachten, statischen Seiten, ist der Kosteneffekt gering. Treffen sie wiederholt Warenkorb-, Checkout-, Such- oder Login-Endpoints, leistet dieser Traffic auf dem Server echte, abrechenbare Arbeit.
Spart die Anti-Bot-Funktion eines Hosting-Plans wirklich Geld?
Eine Anti-Bot-Funktion, die pfadspezifische Regeln erlaubt, also Crawler an teuren Endpoints blockiert oder ratenlimitiert, während gecachte Seiten unberührt bleiben, kann die Serverlast spürbar senken, wenn die dynamischen Endpoints tatsächlich stark getroffen wurden. Sie bringt wenig bis nichts, wenn die Crawler, die die Website erreichen, ohnehin nur gecachte Seiten angefasst haben, weshalb es wichtiger ist, die exponierten Endpoints zu identifizieren als die Funktion selbst zu kaufen.
Fazit
Die eigentlich lohnende Frage ist nicht, ob man KI-Crawler zulässt oder blockiert, sondern welche konkreten Seiten der eigenen Website echte Rechenarbeit auslösen und ob irgendetwas, ob Mensch oder Bot, sie mit einer Rate trifft, für die der Server nicht gebaut wurde. Diese Endpoint-Exposition lässt sich mit Ratenlimits und Pfad-Regeln beheben, während die separate Frage der Trainingszustimmung für KI eigenständig über die robots.txt geregelt gehört, ohne von einem einzigen Werkzeug die Antwort auf beides zu erwarten.