Trafic des bots IA : pourquoi il fait grimper votre facture d'hébergement
GPTBot, ClaudeBot… ces robots IA font exploser certaines factures d'hébergement. Ce n'est pas une question de volume, mais des pages qu'ils visitent.
Si vous gérez un site, une partie de vos visiteurs n’a jamais été humaine, et ça a toujours été le cas : les moteurs de recherche explorent le web depuis des décennies sans que personne ne s’inquiète de la facture. Ce qui change aujourd’hui, c’est qui frappe à la porte, et surtout à quelle porte. Des propriétaires de sites commencent à voir le trafic des robots IA apparaître comme une vraie ligne de coût dans leur facture d’hébergement, et la raison n’a presque rien à voir avec le volume. Elle tient aux pages visitées : un robot qui lit votre article de blog statique ne coûte quasiment rien, tandis que le même robot qui martèle votre panier d’achat peut discrètement devenir le trafic le plus cher de tout votre site.
Toute l’histoire tient dans cette distinction. Le nombre total de requêtes fait un titre spectaculaire, mais il ne dit presque rien de ce que vous allez réellement payer. Deux sites peuvent recevoir exactement le même nombre de visites de robots IA et se retrouver avec des factures d’hébergement totalement différentes, uniquement parce que ces robots n’ont pas atterri sur les mêmes URL. La même logique guide déjà le choix entre matériel IA local et location de capacité cloud : le coût ne vient jamais du trafic en lui-même, il vient de ce que ce trafic force la machine à calculer.
Pourquoi le même robot peut être gratuit sur une page et coûteux sur une autre
Un crawler (ou robot d’exploration) est simplement un programme automatisé qui demande des pages les unes après les autres, la même famille de logiciels que ceux qui permettent à Google d’indexer le web. Quand un crawler demande une page d’article classique, la plupart des configurations d’hébergement la servent depuis un cache, une copie déjà prête de la page finie, gardée sous la main pour que le serveur n’ait pas à la reconstruire à chaque fois. Servir une page en cache coûte une fraction de centime en temps de calcul. C’est l’équivalent numérique de tendre une photocopie.
Un endpoint, en revanche, est une adresse précise du site qui déclenche un vrai travail côté serveur plutôt que de renvoyer un fichier stocké. Un panier d’achat, une page de paiement, un formulaire de connexion, une barre de recherche, une page qui calcule des frais de port : ce sont tous des endpoints qu’on ne peut généralement pas mettre en cache, parce que la réponse change à chaque visiteur et à chaque session. Répondre à l’une de ces requêtes suppose de lancer des requêtes en base de données, de vérifier un stock, parfois d’ouvrir une session temporaire qu’il faudra suivre puis nettoyer. Ça peut coûter des dizaines, voire des centaines de fois plus de ressources serveur qu’une page en cache, pour une seule requête.
C’est ce mécanisme qui explique les pics de coûts que rapportent certains hébergeurs. Un robot qui ne touche jamais qu’à vos articles publiés est, du point de vue du coût, strictement identique à un robot de moteur de recherche qui indexe le web depuis vingt ans. Un robot qui frappe en boucle votre panier ou votre logique de paiement fait, lui, quelque chose de réellement différent : chacune de ses requêtes force le serveur à exécuter un travail qu’il ne peut ni sauter ni précalculer.
Ce qu’un hébergeur a vraiment mesuré, et pourquoi ses chiffres méritent une réserve
Kinsta, une société d’hébergement web, a publié des chiffres décrivant ce que son infrastructure observait côté robots IA, et ces chiffres sont assez précis pour qu’on les cite, à condition d’y attacher, à chaque fois, une réserve importante : Kinsta vend une fonctionnalité anti-bot dans son panneau de contrôle, lancée le 9 juin 2026. Ses propres données viennent donc d’un fournisseur qui a un intérêt commercial direct à faire passer le trafic des robots IA pour un problème plus grave qu’il ne l’est peut-être pour tel ou tel site. Cela ne rend pas les chiffres faux, mais ça veut dire qu’il faut les lire comme le témoignage d’une entreprise sur ce qu’elle a observé, pas comme une mesure indépendante du secteur.
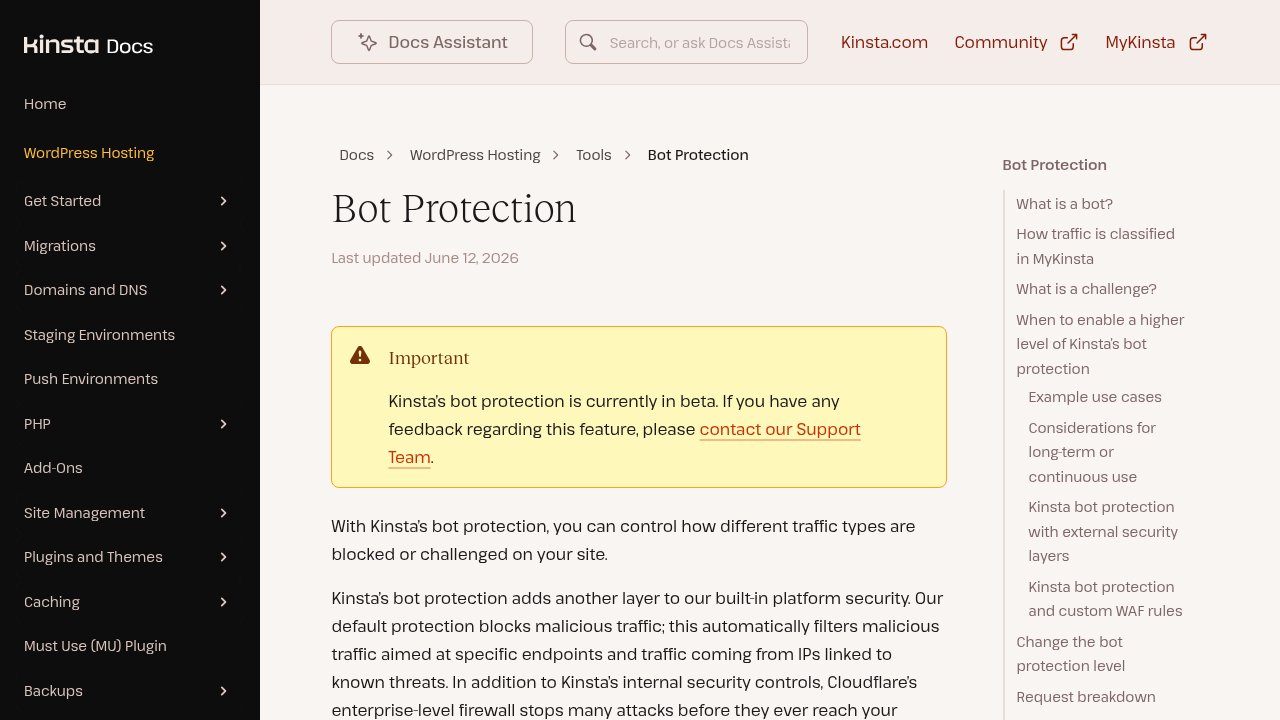 Kinsta, le panneau anti-bot que l’hébergeur vend en même temps qu’il publie ses chiffres sur les robots IA.
Ce cadrage posé, deux cas rapportés par Kinsta valent la peine d’être compris précisément, parce qu’ils sont spécifiques, pas parce qu’ils seraient représentatifs. Sur l’un des sites qu’elle héberge, ClaudeBot, le robot d’exploration d’Anthropic, a généré 3,75 millions de requêtes vers une page de panier d’achat en 24 heures, selon les chiffres publiés par Kinsta et relayés aussi par le média spécialisé ppc.land. Sur un autre site, Kinsta décrit un robot resté coincé dans ce qu’elle appelle une boucle, un schéma d’exploration qui revenait sans cesse sur des pages qui se renvoient l’une à l’autre, générant environ 550 millions de requêtes en 30 jours. Il s’agit dans les deux cas d’incidents précis, nommés, sur des sites précis, pas d’une norme statistique à attendre sur le vôtre. Un robot qui se comporte ainsi sur un endpoint de panier représente un vrai coût, qu’il vaut la peine d’anticiper. Ce n’est pas pour autant la preuve que les robots IA agissent habituellement de la sorte.
Il faut reconnaître à Kinsta une certaine transparence sur les limites de son propre angle commercial : son directeur technique a déclaré, lors du lancement d’une tarification basée sur la bande passante en novembre 2025, que Kinsta ne facture pas la bande passante consommée par les robots IA à ses clients, et ne bloque aucun trafic par défaut au niveau de la plateforme. Autrement dit, la fonctionnalité anti-bot qu’elle vend est un réglage que le propriétaire du site active lui-même, pas un service facturé au trafic de robots. C’est une posture sensiblement différente de celle d’un hébergeur qui profiterait discrètement du problème qu’il agite. Il reste néanmoins utile de se rappeler, à chaque chiffre Kinsta cité, que cette entreprise décrit un problème pour lequel elle vend aussi la solution.
Le seul chiffre qui vient d’une source neutre, et ce qu’il montre vraiment
Indépendamment des cas Kinsta, il existe un chiffre qui mérite davantage confiance, parce qu’il vient d’une source sans aucun produit anti-bot à vendre. Cloudflare Radar, la branche analytique réseau de l’entreprise d’infrastructure Cloudflare, qui observe le trafic agrégé de millions de sites, a documenté que le trafic global des crawlers a progressé de 18 % entre mai 2024 et mai 2025, et qu’au sein de cette croissance, GPTBot, le robot d’OpenAI, a bondi de 305 % sur la même période, contre 96 % pour le propre robot de Google. Sur l’année civile 2025 complète, les données Radar de Cloudflare placent Googlebot au-delà de 28 % du trafic de robots vérifiés, GPTBot autour de 7,5 %, et Bingbot à 6 % ; le volume d’exploration de ClaudeBot a à peu près doublé au premier semestre avant de reculer au second, même si Cloudflare n’a pas publié de part annuelle comparable pour ce robot.
 Cloudflare Radar, données agrégées sur le trafic des crawlers, issues de millions de sites, sans produit anti-bot à vendre.
Cette croissance a une solidité que n’a pas l’anecdote d’un seul hébergeur sur son trafic panier : elle décrit un vrai basculement de qui explore le web, vérifié sur un échantillon énorme, sans intérêt à le gonfler. Ce qu’elle ne dit pas, en revanche, c’est si cette croissance touche vos endpoints coûteux à vous. Un robot peut croître de 305 % en volume et ne rien vous coûter du tout s’il ne touche que des pages en cache. Le chiffre Cloudflare explique pourquoi les robots IA pèsent désormais une part significative du trafic ; il n’explique pas, à lui seul, pourquoi certains propriétaires de sites voient leur facture d’hébergement s’envoler. Cette seconde partie tient à l’exposition des endpoints, pas à la popularité du robot.
Une partie de la presse généraliste est allée plus loin, affirmant que le trafic de robots automatisés, lié à l’IA ou non, dépasserait désormais le trafic humain sur l’ensemble du web. Cette affirmation vient de rapports sectoriels et d’analyses de presse, pas des mesures de Kinsta ni des chiffres spécifiques aux crawlers de Cloudflare Radar cités plus haut. Il vaut mieux la traiter comme une estimation large et disputée plutôt que comme un fait établi, puisque le « trafic de bots » de ces rapports englobe tout, de l’indexation de recherche aux tentatives de fraude en passant par les outils de supervision : une catégorie bien plus vaste que les seuls robots IA.
Deux problèmes distincts qui portent la même plainte
L’erreur pratique que commettent la plupart des propriétaires de sites est de traiter les robots IA comme une décision unique : les bloquer, ou pas. Ce cadrage confond en réalité deux problèmes bien différents, et la bonne réponse à l’un ressemble, à tort, à la bonne réponse à l’autre.
Le premier problème est l’abus général d’automatisation par des bots : scraping agressif, tentatives de bourrage d’identifiants, bots de spéculation sur les stocks, ou un crawler, lié à l’IA ou non, resté coincé dans une boucle qui frappe sans cesse le même ensemble de pages, le schéma derrière le cas des 550 millions de requêtes chez Kinsta. C’est un problème de débit et de contrôle d’accès. La solution consiste à limiter la vitesse à laquelle un même client automatisé peut demander des pages, et à tenir les endpoints coûteux et non-cachables comme le paiement ou le compte client à l’écart de tout ce qui n’a pas besoin d’y accéder. Un outil comme le nouveau bouton du tableau de bord Kinsta, ou l’équivalent chez la plupart des hébergeurs modernes, répond exactement à ça : des règles par chemin d’URL, pour ralentir ou écarter un robot spécifiquement d’une adresse de panier ou de paiement, sans toucher au reste du site.
Le second problème est l’exploration à des fins d’entraînement IA et de citation : voulez-vous, ou non, qu’un modèle d’une entreprise puisse lire votre contenu, que ce soit pour s’entraîner dessus ou pour répondre à des questions en citant votre source ? C’est un problème de politique et de visibilité, pas un problème de coût, et il se règle par un mécanisme complètement différent, bien plus ancien : le robots.txt, un simple fichier texte que tout site peut publier pour indiquer aux robots nommés quelles parties du site ils peuvent, ou non, visiter. Bloquer GPTBot dans le robots.txt parce qu’on ne veut pas qu’OpenAI entraîne son modèle sur son contenu est un choix légitime et réfléchi. Mais ça ne fait rien pour empêcher un autre robot, mal élevé, de boucler sur votre endpoint de panier, parce que tous les clients automatisés ne respectent pas ce fichier, et parce que le fichier n’a jamais été conçu comme un limiteur de débit.
Confondre les deux mène à de mauvaises décisions dans les deux sens. Des propriétaires de sites qui bloquent chaque robot IA par son user-agent, une étiquette que le robot envoie pour s’identifier, perdent du trafic de citation légitime et de la valeur de référencement, tout en laissant grands ouverts les endpoints réellement coûteux à tout ce qui ignore le blocage. Ou l’inverse : des propriétaires qui verrouillent les limites de débit partout, y compris sur des pages en cache qui n’ont jamais représenté le moindre risque de coût, sans jamais toucher à la question d’entraînement et de citation qui les préoccupait vraiment.

FAQ
C’est quoi, au juste, le problème du trafic des robots IA sur la facture d’hébergement ?
Le schéma derrière ce problème, ce sont les robots d’exploration des entreprises d’IA, comme GPTBot ou ClaudeBot, qui génèrent assez de requêtes vers les pages dynamiques d’un site (un panier, un paiement, une recherche) pour faire monter sensiblement la charge serveur et la facture d’hébergement, alors que le même robot, sur des pages statiques en cache, ne coûte quasiment rien. Le coût vient des pages visitées, pas de l’existence du robot.
Faut-il simplement bloquer tous les robots IA dans le robots.txt ?
Bloquer tous les robots IA dans le robots.txt, le fichier texte qui indique aux visiteurs automatisés quelles pages ils peuvent atteindre, est un choix valable si votre priorité est de garder votre contenu hors des données d’entraînement des IA. Ça ne règle pas un problème de coût ou de performance, parce que tout le trafic automatisé ne respecte pas ce fichier, et ça n’arrêtera pas un robot mal élevé déjà en train de boucler sur un endpoint coûteux.
ClaudeBot ou GPTBot est-il pire pour la facture d’hébergement que l’autre ?
Aucun des deux robots n’est intrinsèquement pire que l’autre pour la facture d’hébergement. Les pics de coûts rapportés, y compris le cas documenté de ClaudeBot générant 3,75 millions de requêtes vers une page de panier en 24 heures sur l’infrastructure d’un hébergeur, tiennent aux endpoints que ce robot a visités sur un site donné, pas à une différence de comportement constante entre les robots d’OpenAI et d’Anthropic.
Comment savoir si les robots IA me coûtent de l’argent sur mon propre site ?
Le point de départ, ce sont vos logs d’accès serveur : chercher les requêtes venant de user-agents connus de robots IA, comme GPTBot ou ClaudeBot, et regarder quelles URL ils visitent le plus. S’ils atteignent surtout des pages statiques en cache, l’impact sur les coûts est minime. S’ils frappent à répétition les endpoints de panier, de paiement, de recherche ou de connexion, ce trafic effectue un vrai travail facturable sur votre serveur.
La fonctionnalité anti-bot d’un plan d’hébergement fait-elle vraiment économiser de l’argent ?
Une fonctionnalité anti-bot d’hébergement qui permet de définir des règles par chemin d’URL, en bloquant ou en limitant les robots sur les endpoints coûteux tout en laissant intactes les pages en cache, peut réduire sensiblement la charge serveur si vos endpoints dynamiques étaient réellement mis à rude épreuve. Elle ne fait presque rien économiser si les robots atteignant votre site ne touchaient que des pages en cache, d’où l’importance d’identifier d’abord les endpoints exposés, avant même de penser à l’outil.
À retenir
La question à se poser n’est pas de savoir s’il faut autoriser ou bloquer les robots IA, mais quelles pages précises de votre site effectuent un vrai travail de calcul, et si quelque chose, humain ou automatisé, les frappe à un rythme que votre serveur n’a pas été conçu pour encaisser. Réglez cette exposition des endpoints avec des limites de débit et des règles par chemin, et traitez la question distincte du consentement à l’entraînement IA via le robots.txt, sur ses propres termes, sans attendre d’un seul outil qu’il réponde aux deux à la fois.