Shieldstral de Mistral : le garde-fou IA qui se réécrit en français, sans réentraînement
Shieldstral, le garde-fou IA de Mistral, laisse chacun réécrire ses règles de modération en langage courant, sans réentraîner le modèle.
Le 4 août 2026, le laboratoire français Mistral AI a publié un petit modèle baptisé Shieldstral. Ce qui est intéressant, ce n’est pas ce qu’il fait, mais la façon dont on lui donne ses instructions. Shieldstral est un modèle garde-fou : un programme qui lit un texte ou une image et décide s’il enfreint un règlement, placé aux côtés d’un modèle d’IA plus gros pour intercepter ce qui ne devrait jamais arriver jusqu’à l’utilisateur. Depuis les débuts des chatbots grand public, la plupart des filtres de sécurité fonctionnaient de la même façon : l’éditeur choisissait une fois pour toutes les catégories de contenu à bloquer, gravait cette liste dans le modèle pendant son entraînement, et tout le monde héritait des mêmes règles. Shieldstral casse ce schéma. Ses règles ne sont plus figées à l’entraînement : elles s’écrivent en langage courant au moment même où le modèle travaille, ce qui veut dire que celui qui l’utilise peut changer ce qu’il considère comme dangereux simplement en réécrivant une phrase.
Ce changement de logique compte plus que la taille du modèle ou ses scores sur les benchmarks de référence, même si ces chiffres valent le détour. Cet article regarde ce que Shieldstral change vraiment, pas une fiche technique.
Ce qu’est ce genre de contrôle de sécurité, en clair
La plupart des gens imaginent la modération IA comme un système unique : on pose une question à un chatbot, et si la demande est dangereuse, le chatbot refuse lui-même de répondre. En réalité, beaucoup de produits IA font tourner deux modèles en parallèle. Le modèle principal génère la réponse, et un second modèle, plus petit, vérifie la demande puis la réponse au regard d’un règlement avant que quoi que ce soit ne s’affiche. Ce second modèle, c’est le garde-fou. Il ne parle jamais directement à l’utilisateur. Il lit, et il rend un verdict : sûr, dangereux, et souvent la catégorie du danger.
Shieldstral est construit spécifiquement pour ce second rôle. Ce n’est pas un chatbot, et il n’a aucun lien avec les modèles vedettes de Mistral pour la conversation ou le code, comme Mistral Large ou Codestral, qui eux génèrent des réponses. Shieldstral, lui, ne fait que classer. Selon l’annonce de Mistral, il vérifie à la fois le texte et les images au regard d’un règlement de modération, ce qui comble un vrai trou : beaucoup d’outils garde-fou ne regardent que le texte, laissant passer sans contrôle les images envoyées ou générées. Quiconque hésite sur quel modèle open weight faire tourner en local finira par se poser la même question : un modèle local puissant sans aucun contrôle de contenu, c’est juste un modèle puissant sans ceinture de sécurité.
Mistral AI — la page d’annonce officielle de Shieldstral, le modèle garde-fou de Mistral.
Ce qui est vraiment nouveau : on écrit la règle, pas les données d’entraînement
Voici le mécanisme qui rend Shieldstral intéressant. Dans les anciens systèmes de garde-fou, la liste des catégories interdites, contenu autodestructeur, discours de haine, contenu explicite, et ainsi de suite, était figée pendant l’entraînement. Changer cette liste imposait de réentraîner le modèle : lent, coûteux, et généralement seul l’éditeur d’origine pouvait s’en charger. Tout le monde en aval restait coincé avec les catégories que cet éditeur avait choisies.
Shieldstral prend son règlement de modération sous la forme d’une question en langage courant, fournie à chaque fois qu’on lui demande de vérifier quelque chose. L’opérateur ne coche pas des cases dans une liste préétablie en usine. Il écrit, en phrases ordinaires, ce qu’il veut voir signalé, et Shieldstral applique l’instruction sur-le-champ. Envie de repérer les contenus qui recommandent un traitement médical non autorisé ? Il suffit d’écrire cette consigne. Vous gérez une plateforme pour un pays donné avec sa propre définition légale des propos interdits ? Écrivez cette consigne à la place. Pas de réentraînement, pas d’attente d’une mise à jour de l’éditeur, pas de pipeline de fine-tuning.
En pratique, le règlement de modération devient quelque chose que l’opérateur possède et modifie lui-même, plutôt qu’un héritage de celui qui a construit le modèle sous-jacent. Un chatbot d’hôpital, une plateforme éducative pour enfants et le chat intégré d’un studio de jeu vidéo n’ont absolument pas la même idée de ce que « dangereux » signifie pour leurs utilisateurs. Avec l’ancien système, les trois devaient soit partager les catégories par défaut d’un même éditeur, soit payer pour faire entraîner un modèle sur mesure. Avec cette approche, les trois peuvent pointer le même petit modèle ouvert vers trois règlements différents, écrits en langage courant, et obtenir trois résultats différents et cohérents.
Petit exprès : la taille est un choix, pas une limite
Mistral présente Shieldstral comme un modèle à 3 milliards de paramètres (les paramètres sont les valeurs internes que le modèle ajuste pendant son entraînement ; en gros, plus il y en a, plus le modèle est généralement capable, mais aussi coûteux à faire tourner). Trois milliards, c’est petit pour les standards actuels, et c’est voulu. Un garde-fou doit tourner sur chaque requête qui traverse un système, en plus de ce que fait déjà le modèle principal. Si le garde-fou lui-même coûte cher à faire tourner, il peut doubler le coût et ralentir chaque interaction.
Mistral affirme que Shieldstral fonctionne sur une seule carte graphique grand public de 16 Go, le genre qu’on trouve dans un bon PC de jeu plutôt que dans un rack de data center. Ce choix de conception est délibéré : il est pensé pour tourner à moindre coût à côté d’un modèle bien plus gros, en vérifiant ses entrées et ses sorties sans devenir lui-même un second système coûteux à exploiter. Pour une équipe qui fait déjà tourner un gros modèle sur du matériel sérieux, ajouter un vérificateur léger qui tient sur un seul GPU modeste est beaucoup plus facile à justifier qu’ajouter un second modèle lourd.
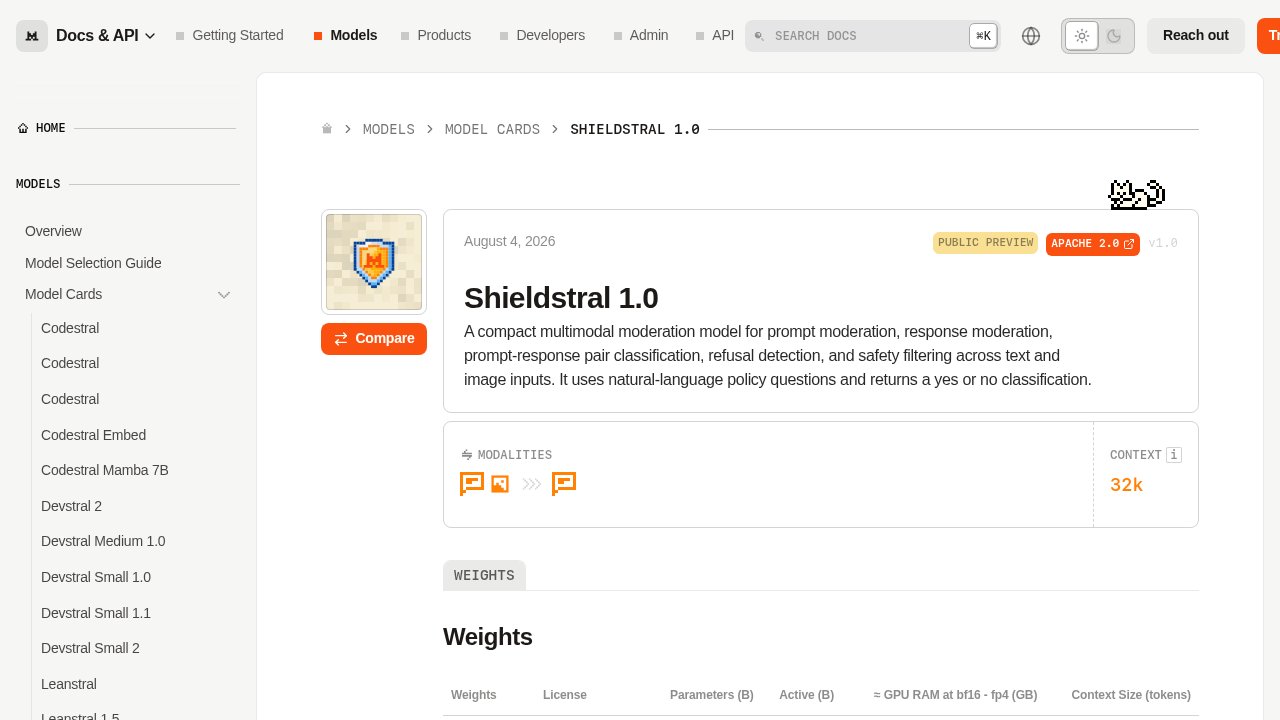
Mistral AI — la fiche modèle officielle de Shieldstral, avec ses spécifications, ses benchmarks et ses prérequis matériels.
Shieldstral est distribué sous licence open source Apache 2.0, et ses poids (les valeurs numériques entraînées qui font tourner le modèle) se téléchargent sur Hugging Face, la plateforme par laquelle transitent la plupart des modèles d’IA ouverts. Mistral n’a pas publié de tarif d’API spécifique pour Shieldstral, ce qui colle à la logique open weight : le modèle est fait pour être téléchargé et exploité par vous-même plutôt que payé à la requête via un service hébergé par Mistral.
Ce que Mistral affirme sur la précision, et pourquoi il faut le prendre avec des pincettes
Mistral déclare que Shieldstral égale ou dépasse d’autres modèles garde-fou ouverts jusqu’à sept fois plus gros que lui sur des benchmarks de sécurité (des jeux de test standardisés qui mesurent la capacité d’un modèle à repérer les contenus réellement dangereux sans signaler à tort des contenus inoffensifs). Si ce chiffre se vérifie, c’est notable : cela voudrait dire qu’un laboratoire qui fait tourner Shieldstral obtient des performances de garde-fou proches d’un modèle bien plus gros et bien plus coûteux, pour une fraction du calcul.
Il faut être précis sur la nature de cette affirmation : c’est un résultat de benchmark rapporté par Mistral lui-même, pas un chiffre vérifié de façon indépendante par un tiers au moment de la sortie du modèle. Les comparaisons de benchmarks choisies et menées par l’entreprise qui a conçu le modèle ont tendance à le favoriser, intentionnellement ou non, rien que par le choix des tests mis en avant. Cela ne veut pas dire que le chiffre est faux. Cela veut dire qu’un lecteur attentif le traite comme un point de départ, pas comme un verdict définitif — la même prudence de principe qu’on applique à n’importe quel chiffre annoncé par un éditeur avant de le répéter comme un fait acquis.
Côté couverture linguistique, la documentation de Mistral liste déjà une douzaine de langues prises en charge, l’anglais, le français, l’espagnol, l’allemand, l’italien, le portugais, le néerlandais, le chinois, le japonais, le coréen, l’arabe et le russe, mais signale une « couverture inégale » comme limite connue, car ces langues sont représentées de façon inégale dans les données d’entraînement. L’annonce de Mistral précise par ailleurs qu’elle « continue à pousser sur la couverture multilingue », ce qui se lit comme un engagement à combler cet écart de fiabilité plutôt qu’une promesse d’ajouter de nouvelles langues plus tard. Cette nuance compte pour qui déploie le modèle hors des langues les mieux couvertes par Mistral : le garde-fou tourne déjà dans une douzaine de langues, mais pas avec une fiabilité garantie partout à l’identique.
À qui ça change vraiment quelque chose
Les personnes qui sentiront le plus la différence ne sont pas les utilisateurs occasionnels de chatbot, qui ne sauront probablement jamais qu’un garde-fou tourne en coulisses. Ce sont les équipes qui construisent des produits IA et qui n’avaient jusqu’ici que deux options : accepter les règles de contenu livrées par l’éditeur du modèle, ou dépenser du temps d’ingénierie et de l’argent pour entraîner un filtre sur mesure. Un règlement réécrivable en langage courant réduit ces deux options à une seule étape légère. Un établissement scolaire, un acteur de la santé, une plateforme régionale soumise à des lois locales sur la parole, et un studio de jeu vidéo indépendant n’ont pas les mêmes lignes rouges à tracer, et aucun d’entre eux n’avait auparavant de moyen simple de tracer sa propre ligne sans soit accepter le réglage par défaut de quelqu’un d’autre, soit construire un système sur mesure depuis zéro.
C’est aussi un petit détail révélateur dans une histoire plus large autour de l’open weight, cette pratique qui consiste à publier gratuitement les poids d’un modèle entraîné : Mistral s’y est positionné comme l’un des laboratoires open source les plus visibles d’Europe, à l’opposé des modèles fermés et payants des plus grands laboratoires américains. La confusion qui avait entouré la marque Mistral, avec le faux modèle « Le Chaton Fat » qui a brièvement circulé en ligne, montrait déjà à quel point l’attention s’agite autour de ce que Mistral publie vraiment, par rapport à ce qu’on lui attribue à tort. Shieldstral, lui, est bien réel, documenté sur le site officiel de Mistral, et cadré étroitement : un vérificateur de sécurité, pas un chatbot généraliste, à évaluer sur cette tâche précise plutôt que comme un porte-drapeau.

Questions fréquentes
À quoi sert Mistral Shieldstral ?
Mistral Shieldstral est un modèle garde-fou, un petit système d’IA qui vérifie du texte ou des images au regard d’un règlement de contenu et signale ce qui l’enfreint. Il tourne aux côtés d’un modèle d’IA plus gros, en filtrant ce qui entre et ce qui sort, sans jamais générer lui-même de réponse pour l’utilisateur.
En quoi Shieldstral diffère-t-il d’un filtre de contenu classique ?
Un filtre de contenu classique est entraîné une fois pour toutes sur une liste figée de catégories interdites, donc changer les règles impose de réentraîner le modèle. Shieldstral, lui, reçoit son règlement de modération sous forme d’instruction en langage courant à chaque vérification, ce qui permet à un opérateur de réécrire ce qu’il considère comme dangereux sans aucun réentraînement.
Shieldstral est-il gratuit ?
Mistral a publié les poids de Shieldstral sous licence open source Apache 2.0 sur Hugging Face, ce qui veut dire que n’importe qui peut le télécharger et le faire tourner sans payer de licence. Mistral n’a pas publié de tarif d’API distinct pour ce modèle, puisqu’il est conçu pour être auto-hébergé plutôt qu’accessible via un service payant.
Shieldstral remplace-t-il les chatbots principaux de Mistral ?
Shieldstral ne remplace pas les modèles de chatbot principaux de Mistral. Il n’a aucun lien avec les modèles de génération comme Mistral Large ou Codestral, et il ne produit aucune réponse pour l’utilisateur. C’est un vérificateur de sécurité étroitement ciblé, pensé pour tourner à côté d’un modèle plus gros, pas pour le remplacer.
Quel matériel faut-il pour faire tourner Shieldstral ?
Shieldstral tourne sur une seule carte graphique grand public de 16 Go, le genre qu’on trouve dans un PC de jeu ordinaire plutôt que dans du matériel spécialisé de data center, selon Mistral. Cette faible exigence est volontaire, puisqu’un modèle garde-fou doit vérifier chaque requête sans ajouter de coût majeur au système qu’il protège.
À retenir
Le chiffre qui fait la une de l’annonce de Mistral, égaler des modèles plus gros sur les benchmarks de sécurité avec une fraction de leur taille, est un joli détail, mais le vrai changement à retenir est plus discret : la politique de modération de contenu est passée d’une décision prise une fois pour toutes par un éditeur pour tout le monde, à quelque chose qu’un opérateur peut écrire et réécrire en langage courant chaque fois que sa situation l’exige. Ce basculement change qui tient la plume sur ce qui doit être bloqué, et c’est le genre de changement qui continue de compter longtemps après que les scores de benchmark de ce modèle précis seront devenus obsolètes.