Mistral Shieldstral: Das Guardrail-Modell, das man umschreibt statt neu trainiert
Mistrals Guardrail-Modell Shieldstral lässt jeden die Moderationsregeln in einfachem Text ändern, ganz ohne Neu-Training. Was das für die KI-Kontrolle bedeutet.
Am 4. August 2026 hat das französische KI-Labor Mistral AI ein kleines Modell namens Shieldstral veröffentlicht. Spannend ist dabei nicht, was es tut, sondern wie man ihm sagt, was es tun soll. Shieldstral ist ein Guardrail-Modell: eine Software, die Text oder ein Bild liest und entscheidet, ob es gegen ein Regelwerk verstößt. Es läuft neben einem größeren KI-Modell und fängt Problematisches ab, bevor es den Nutzer erreicht. Die meisten KI-Sicherheitsfilter funktionieren seit den ersten Chatbot-Wellen nach demselben Muster: Ein Anbieter legt einmalig fest, welche Inhaltskategorien blockiert werden, backt diese Liste fest ins Modell ein, und jeder, der das Modell nutzt, erbt dieselben Regeln. Mistral Shieldstral bricht mit diesem Muster. Die Regeln liegen nicht beim Training fest, sondern werden zum Zeitpunkt der Anwendung in einfachem Text formuliert, also genau dann, wenn das Modell gerade einen Inhalt prüft. Wer es betreibt, kann also ändern, was als unsicher gilt, indem er einfach einen Satz umschreibt.
Diese Verschiebung wiegt schwerer als die Modellgröße oder die Benchmark-Werte, so aufschlussreich die auch sein mögen. Es geht in diesem Beitrag darum, was Mistral Shieldstral wirklich verändert, nicht um ein Datenblatt.
Was so ein Sicherheitscheck eigentlich ist
Die meisten stellen sich KI-Moderation als ein einziges System vor: Man fragt einen Chatbot etwas, und wenn die Anfrage gefährlich ist, verweigert der Chatbot selbst die Antwort. In der Praxis laufen bei vielen KI-Produkten zwei Modelle parallel. Das Hauptmodell erzeugt die Antwort, ein zweites, kleineres Modell prüft Anfrage und Antwort gegen eine Richtlinie, bevor überhaupt etwas angezeigt wird. Dieses zweite Modell ist das Guardrail. Es spricht nie direkt mit dem Nutzer, sondern liest und liefert ein Urteil zurück: sicher, unsicher, und oft auch, in welche Kategorie das Unsichere fällt.
Mistral Shieldstral ist genau für diese zweite Rolle gebaut. Es ist kein Chatbot und hat nichts mit Mistrals Flaggschiff-Modellen wie Mistral Large oder Codestral zu tun, die selbst Antworten generieren. Shieldstral klassifiziert nur. Laut Mistrals eigener Ankündigung prüft es sowohl Text als auch Bilder gegen eine Moderationsrichtlinie, und das schließt eine echte Lücke: Viele Guardrail-Werkzeuge schauen nur auf Text und lassen hochgeladene oder generierte Bilder ungeprüft durch. Wer überlegt, welches Open-Weight-Modell er lokal betreiben will (also ein Modell, dessen trainierte Gewichte offen zum Download stehen), stößt früher oder später auf genau diese Frage, denn ein leistungsfähiges lokales Modell ganz ohne Inhaltsprüfung ist nur ein leistungsfähiges Modell ohne Sicherheitsgurt.
Mistral AI — die offizielle Ankündigungsseite für Shieldstral, Mistrals Guardrail-Modell.
Das eigentlich Neue: Man schreibt die Regel, nicht die Trainingsdaten
Hier liegt der Mechanismus, der Mistral Shieldstral einen zweiten Blick wert macht. Bei älteren Guardrail-Systemen ist die Liste der verbotenen Kategorien, Selbstverletzung, Hassrede, explizite Inhalte und so weiter, beim Training fest verdrahtet. Diese Liste zu ändern bedeutet, das Modell neu zu trainieren, was langsam, teuer ist und in der Regel nur der ursprüngliche Anbieter kann. Alle anderen sitzen mit genau den Kategorien fest, die dieser Anbieter einmal ausgewählt hat.
Shieldstral nimmt seine Moderationsrichtlinie stattdessen als Frage in einfacher Sprache entgegen, jedes Mal neu mitgeliefert, wenn es etwas prüfen soll. Ein Betreiber wählt nicht aus einer vorgegebenen Kategorienliste, die werkseitig eingebrannt wurde. Er schreibt in gewöhnlichen Sätzen, was markiert werden soll, und Shieldstral wendet diese Anweisung direkt an. Sollen Inhalte markiert werden, die unlizenzierte medizinische Behandlungen empfehlen? Dann schreibt man genau das. Betreibt man eine Plattform für ein bestimmtes Land mit eigener rechtlicher Definition verbotener Äußerungen? Dann schreibt man stattdessen diese Anweisung. Kein Neu-Training, kein Warten auf ein Update vom Anbieter, keine Fine-Tuning-Pipeline.
In der Praxis bedeutet das: Moderationsrichtlinien werden zu etwas, das ein Betreiber selbst besitzt und bearbeitet, statt etwas, das er von wem auch immer erbt, der das zugrunde liegende Modell gebaut hat. Ein Krankenhaus-Chatbot, eine Bildungsplattform für Kinder und der In-Game-Chat eines Spielestudios haben völlig unterschiedliche Vorstellungen davon, was “unsicher” für ihre Nutzer bedeutet. Unter dem alten System teilen sich alle drei entweder die Standardkategorien eines Anbieters, oder sie zahlen dafür, ein eigenes Modell trainieren zu lassen. Mit diesem Ansatz können alle drei dasselbe kleine offene Modell auf drei verschiedene Richtlinien in einfachem Text ansetzen und bekommen drei unterschiedliche, sinnvolle Ergebnisse.
Klein mit Absicht: Warum die Größe der Punkt ist, nicht die Einschränkung
Mistral beschreibt Shieldstral als Modell mit 3 Milliarden Parametern (Parameter sind die internen Werte, die ein Modell beim Training anpasst; grob gesagt bedeuten mehr davon meist ein größeres, leistungsfähigeres, aber auch teureres Modell im Betrieb). Drei Milliarden sind nach heutigem Maßstab klein, und das ist Absicht. Ein Guardrail muss bei jeder einzelnen Anfrage mitlaufen, die durch ein System geht, zusätzlich zu dem, was das Hauptmodell ohnehin schon leistet. Ist das Guardrail selbst teuer im Betrieb, kann es die Kosten verdoppeln und jede Interaktion verlangsamen.
Mistral gibt an, dass Shieldstral auf einer einzelnen 16-GB-Grafikkarte aus dem Konsumentenbereich läuft, wie sie in einem ordentlichen Gaming-PC steckt, nicht in einem Rechenzentrums-Rack. Diese Design-Entscheidung ist bewusst: Shieldstral soll günstig neben einem viel größeren Modell mitlaufen, Ein- und Ausgaben prüfen, ohne selbst zu einem zweiten teuren System zu werden, das man betreiben muss. Für ein Team, das bereits ein großes Modell auf ernsthafter Hardware betreibt, ist ein schlanker Prüfer, der auf eine einzige bescheidene GPU passt, deutlich leichter zu rechtfertigen als ein zweites Schwergewichts-Modell.
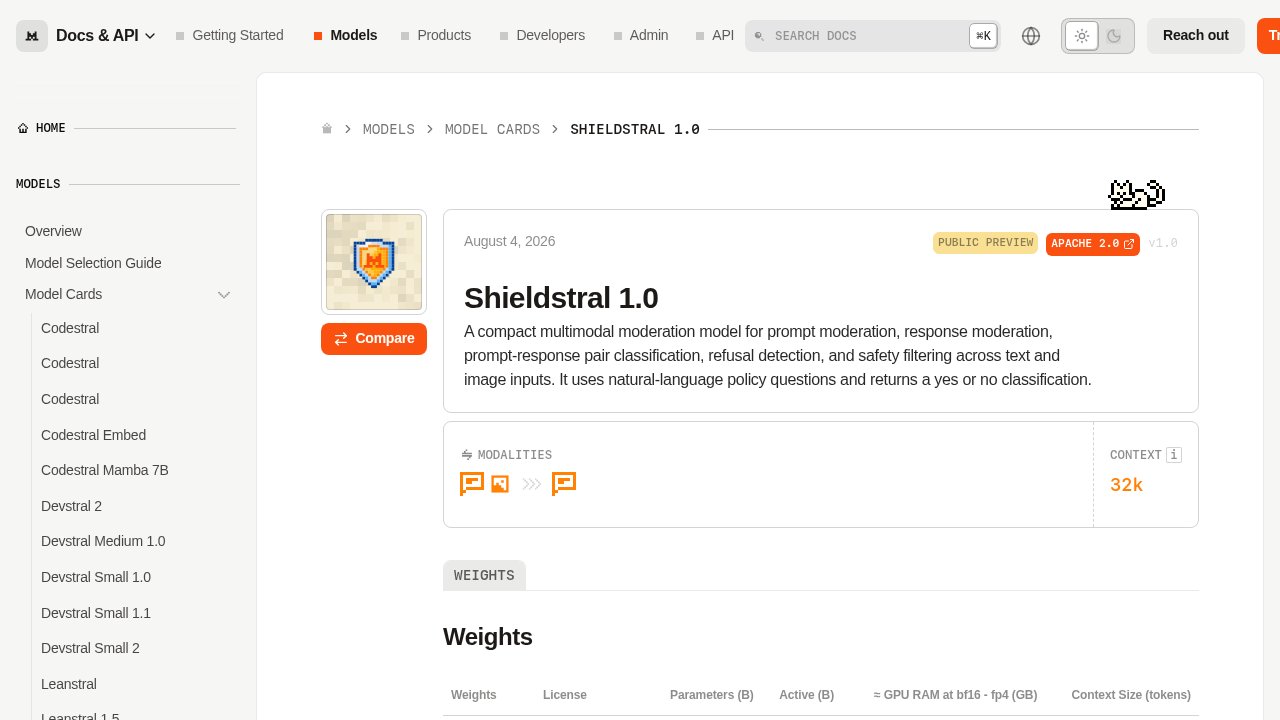
Mistral AI — die offizielle Shieldstral-Modellkarte mit Spezifikationen, Benchmarks und Hardware-Anforderungen.
Shieldstral erscheint unter der Open-Source-Lizenz Apache 2.0, und seine Gewichte (die trainierten Zahlenwerte, die das Modell zum Laufen bringen) lassen sich von Hugging Face herunterladen, der Plattform, über die die meisten Open-Weight-KI-Modelle verteilt werden. Mistral hat für Shieldstral keine eigene API-Preisliste veröffentlicht, was zum Open-Weight-Ansatz passt: Man soll es selbst herunterladen und betreiben, statt pro Anfrage über Mistrals gehosteten Dienst zu zahlen.
Was Mistral zur Genauigkeit behauptet, und warum diese Zahl mit Vorsicht zu genießen ist
Mistral gibt an, dass Shieldstral mit anderen offenen Guardrail-Modellen bis zum Siebenfachen seiner eigenen Größe mithält oder sie übertrifft, gemessen an Sicherheits-Benchmarks (standardisierte Testsätze, mit denen gemessen wird, wie gut ein Modell echte problematische Inhalte erkennt, ohne harmlose Inhalte fälschlich zu markieren). Diese Behauptung wäre bemerkenswert, wenn sie sich hält, denn sie würde bedeuten, dass ein Labor mit Shieldstral eine Guardrail-Leistung nahe an einem viel größeren, teureren Modell bekommt, für einen Bruchteil der Rechenkosten.
Wichtig ist hier Präzision: Es handelt sich um Mistrals eigenen, selbst gemeldeten Benchmark-Wert, nicht um ein Ergebnis, das zum Zeitpunkt der Veröffentlichung unabhängig von Dritten geprüft wurde. Benchmark-Vergleiche, die eine Firma selbst auswählt und durchführt, neigen dazu, das eigene Modell zu begünstigen, ob beabsichtigt oder nicht, allein durch die Wahl, welche Benchmarks hervorgehoben werden. Das heißt nicht, dass die Zahl falsch ist. Es heißt, dass ein aufmerksamer Leser sie als Ausgangspunkt behandelt, nicht als abschließendes Urteil, genau wie jede vom Hersteller gemeldete Zahl einen Moment Skepsis verdient, bevor sie als Fakt weitergereicht wird.
Zur Sprachabdeckung: Mistrals eigene Modell-Dokumentation listet bereits eine konkrete Reihe unterstützter Sprachen, Englisch, Französisch, Spanisch, Deutsch, Italienisch, Portugiesisch, Niederländisch, Chinesisch, Japanisch, Koreanisch, Arabisch und Russisch, weist aber auf eine “ungleichmäßige Abdeckung” als bekannte Einschränkung hin, weil diese Sprachen in den Trainingsdaten unterschiedlich stark vertreten sind. Mistrals eigene Ankündigung schreibt getrennt davon, man arbeite weiter daran, “die mehrsprachige Abdeckung voranzutreiben”, was eher wie eine Zusage klingt, diese Zuverlässigkeitslücke zu schließen, als ein Versprechen, später komplett neue Sprachen hinzuzufügen. Dieser Unterschied zählt für alle, die Shieldstral außerhalb von Mistrals stärksten Sprachen einsetzen: Das Guardrail läuft bereits in einem guten Dutzend Sprachen, nur eben nicht überall mit garantiert gleicher Zuverlässigkeit.
Für wen sich hier wirklich etwas ändert
Am ehesten spüren den Unterschied nicht die gelegentlichen Chatbot-Nutzer, die vermutlich nie erfahren werden, dass im Hintergrund ein Guardrail-Modell mitläuft. Es sind die Teams, die KI-gestützte Produkte bauen und bisher genau zwei Optionen hatten: die Inhaltsregeln des Modell-Anbieters so hinnehmen, wie sie geliefert wurden, oder echte Entwicklungszeit und Geld investieren, um einen eigenen Filter zu trainieren. Eine umschreibbare Richtlinie in einfachem Text verschmilzt diese zwei Optionen zu einem einzigen, leichten Schritt. Ein Schulsystem, ein Gesundheitsdienstleister, eine regionale Plattform unter lokalen Meinungsäußerungsgesetzen und ein Indie-Spielestudio ziehen alle unterschiedliche Grenzen für ihre Nutzer, und keines von ihnen hatte bisher eine einfache Möglichkeit, diese eigene Grenze zu ziehen, ohne entweder fremde Standardvorgaben zu übernehmen oder ein komplett eigenes System von Grund auf zu bauen.
Das ist zugleich ein kleines, aber aufschlussreiches Detail in der größeren Geschichte um Open-Weight-KI, in der sich Mistral als eines der sichtbarsten europäischen Open-Source-Labore positioniert hat, im Gegensatz zu den geschlossenen, abo-gebundenen Modellen der größten US-Labore. Die frühere Verwirrung rund um Mistrals Marke, etwa das frei erfundene Modell “Le Chaton Fat”, das kurzzeitig online kursierte, zeigte bereits, wie viel Aufmerksamkeit darauf liegt, was Mistral tatsächlich ausliefert im Vergleich zu dem, was ihm bloß zugeschrieben wird. Shieldstral ist real, auf Mistrals eigener Seite dokumentiert und eng begrenzt: ein Sicherheitsprüfer, kein allgemeiner Chatbot, und es lohnt sich, ihn genau auf dieser engen Aufgabe zu bewerten statt als Flaggschiff-Release.

Häufig gestellte Fragen
Wofür wird Mistral Shieldstral verwendet?
Mistral Shieldstral ist ein Guardrail-Modell, ein kleines KI-System, das Text oder Bilder gegen ein Regelwerk prüft und alles markiert, was dagegen verstößt. Es läuft neben einem größeren KI-Modell, prüft, was hinein- und herausgeht, statt selbst Antworten für Nutzer zu erzeugen.
Worin unterscheidet sich Shieldstral von einem gewöhnlichen Inhaltsfilter?
Ein gewöhnlicher Inhaltsfilter wird einmalig auf eine feste Liste verbotener Kategorien trainiert, sodass eine Regeländerung ein Neu-Training erfordert. Shieldstral nimmt seine Moderationsrichtlinie stattdessen als Anweisung in einfacher Sprache entgegen, jedes Mal neu mitgeliefert, wenn es einen Inhalt prüft, sodass ein Betreiber umschreiben kann, was als unsicher gilt, ganz ohne Neu-Training.
Ist Shieldstral kostenlos nutzbar?
Mistral hat Shieldstrals Gewichte unter der Open-Source-Lizenz Apache 2.0 auf Hugging Face veröffentlicht, sodass jeder es ohne Lizenzgebühr herunterladen und betreiben kann. Eine eigene API-Preisliste hat Mistral dafür nicht veröffentlicht, da das Modell für den Eigenbetrieb gedacht ist, nicht für den Zugriff über einen kostenpflichtigen Endpunkt.
Ersetzt Shieldstral Mistrals Haupt-Chatbot-Modelle?
Shieldstral ersetzt Mistrals Haupt-Chatbot-Modelle nicht. Es hat nichts mit Mistrals Generierungsmodellen wie Mistral Large oder Codestral zu tun und erzeugt keine Antworten für Nutzer. Es ist ein eng begrenzter Sicherheitsprüfer, der neben einem größeren Modell laufen soll, kein Ersatz dafür.
Welche Hardware braucht man, um Shieldstral zu betreiben?
Shieldstral läuft laut Mistral auf einer einzelnen 16-GB-Grafikkarte aus dem Konsumentenbereich, wie sie in einem gewöhnlichen Gaming-PC steckt, nicht auf spezialisierter Rechenzentrums-Hardware. Diese niedrige Anforderung ist Absicht, denn ein Guardrail-Modell muss jede Anfrage prüfen, ohne dem System, das es schützt, wesentliche Zusatzkosten aufzubürden.
Das Fazit
Die Schlagzeile aus Mistrals Ankündigung, größere Modelle bei Sicherheits-Benchmarks mit einem Bruchteil der Größe einzuholen, ist eine nette Randnotiz. Die Veränderung aber, die im Gedächtnis bleiben sollte, ist leiser: Moderationsrichtlinien sind nicht mehr etwas, das ein Anbieter einmal für alle festlegt, sondern etwas, das ein Betreiber selbst schreibt und in einfachem Text umschreibt, sobald seine Situation es verlangt. Diese Verschiebung ändert, wer die Feder darüber führt, was blockiert wird, und das ist die Art Veränderung, die noch lange zählt, wenn die Benchmark-Werte dieses konkreten Modells längst veraltet sind.