Nemotron Embed : le vrai coût en tokens caché dans votre RAG
Le modèle d'embedding de NVIDIA cartonne sur les benchmarks. Un test indépendant montre qu'il fait surtout baisser la facture de tokens d'un agent IA.
Nemotron Embed : le vrai coût en tokens caché dans votre RAG
Quand une entreprise se plaint que son assistant IA coûte cher à faire tourner, le premier accusé est presque toujours le gros modèle de langage, celui qui rédige les réponses. Un poste de coût moins visible se cache plus tôt dans la chaîne : le petit modèle chargé de choisir quel extrait de document l’assistant a même le droit de lire. Si cette étape rate sa cible, l’assistant relance une recherche, puis une autre, et chaque tentative ajoute des tokens (l’unité sur laquelle les fournisseurs d’IA facturent) à l’addition. NVIDIA vient de sortir une nouvelle version de ce composant discret, baptisée Nemotron 3 Embed. Un testeur indépendant a mené une expérience courte et transparente pour savoir si un meilleur modèle de ce type fait vraiment baisser la facture, pas seulement grimper un score sur un classement.
Ce qu’est vraiment Nemotron 3 Embed (et ce qu’il n’est pas)
La plupart des gens qui ont entendu parler d’un modèle d’IA imaginent quelque chose comme ChatGPT : on tape une question, il écrit une réponse. Un modèle d’embedding fait un travail plus discret et plus mécanique. Il lit un morceau de texte, un paragraphe, un document de politique interne, un ticket de support, et le convertit en une longue liste de chiffres qui capture le sens de ce texte. Deux extraits qui veulent dire des choses proches se retrouvent avec des listes de chiffres proches, même s’ils ne partagent aucun mot en commun. C’est ce mécanisme qui permet à un moteur de recherche de retrouver le passage sur les plafonds de subventions aux énergies renouvelables quand l’utilisateur a tapé une question sur les limites fiscales de l’énergie propre.
Ce mécanisme compte surtout dans le RAG (retrieval-augmented generation, ou génération augmentée par récupération) : plutôt que de répondre uniquement à partir de ce qu’il a mémorisé pendant son entraînement, le modèle de langage cherche d’abord dans les documents propres de l’entreprise les passages pertinents, puis rédige une réponse ancrée sur ce qu’il a trouvé. Le modèle d’embedding, c’est la partie qui cherche. S’il rapporte le mauvais passage, le modèle de langage placé au-dessus donne soit une mauvaise réponse, soit, dans le cas d’un agent autonome, décide de relancer une recherche.
Nemotron 3 Embed est la dernière entrée de NVIDIA dans ce domaine, et la variante qui attire l’attention est la plus petite, un modèle à 1 milliard de paramètres baptisé Nemotron-3-Embed-1B. Il est construit, selon la fiche modèle officielle de NVIDIA sur Hugging Face, en partant du modèle Ministral-3-3B de Mistral, puis en le faisant passer par deux cycles d’élagage (retirer les parties du réseau qui contribuent le moins) et de distillation depuis le plus gros modèle maison de NVIDIA, Nemotron-3-Embed-8B (entraîner un petit modèle à imiter le comportement d’un plus gros). NVIDIA n’a pas reparti d’une page blanche : c’est un descendant plus petit et spécialisé d’un modèle open source déjà existant.
Une précision utile, parce que NVIDIA recycle le nom Nemotron sur des produits très différents : ce modèle n’est pas Nemotron 3 Nano, un autre socle que NVIDIA utilise ailleurs pour des tâches embarquées, et ce n’est pas non plus Nemotron 2-Tower 30B, un modèle génératif complet à architecture hybride qui n’a rien à voir avec la recherche documentaire. Même famille de nom, métiers totalement différents. Si vous évaluez l’un de ces modèles, vérifiez bien qu’il s’agit du modèle d’embedding, et pas d’un cousin au nom presque identique.
Sur la licence, un point à préciser clairement car il circule des erreurs à ce sujet : Nemotron-3-Embed-1B est publié sous OpenMDW-1.1, une licence open weight (un modèle publié gratuitement, poids inclus) maison signée NVIDIA, et non sous Apache ou MIT comme on le lit parfois ailleurs. Le modèle de base Ministral, lui, reste sous Apache 2.0. L’usage commercial est explicitement autorisé dans les deux cas, donc la différence pratique pour la plupart des équipes reste faible, mais l’étiquette elle-même n’est pas interchangeable.
D’après les chiffres publiés par NVIDIA, le modèle atteint 72,38 % de NDCG@10 (une métrique standard de précision de recherche documentaire, qui mesure grosso modo à quel point la bonne réponse arrive près du sommet du classement) sur le benchmark RTEB, et NVIDIA le présente comme la meilleure performance parmi les modèles de taille comparable sur ce benchmark (la première place absolue du classement revient à la variante plus grosse, à 8 milliards de paramètres, pas à celle-ci). Il gère 34 langues et peut traiter en une seule passe des extraits allant jusqu’à 32 768 tokens (les mots et fragments de mots que le modèle manipule). Ce sont les chiffres de NVIDIA, tirés de sa propre fiche modèle, à prendre pour ce qu’ils sont : un résultat de benchmark fourni par le fabricant, utile comme signal de départ, pas comme garantie pour un cas d’usage précis.
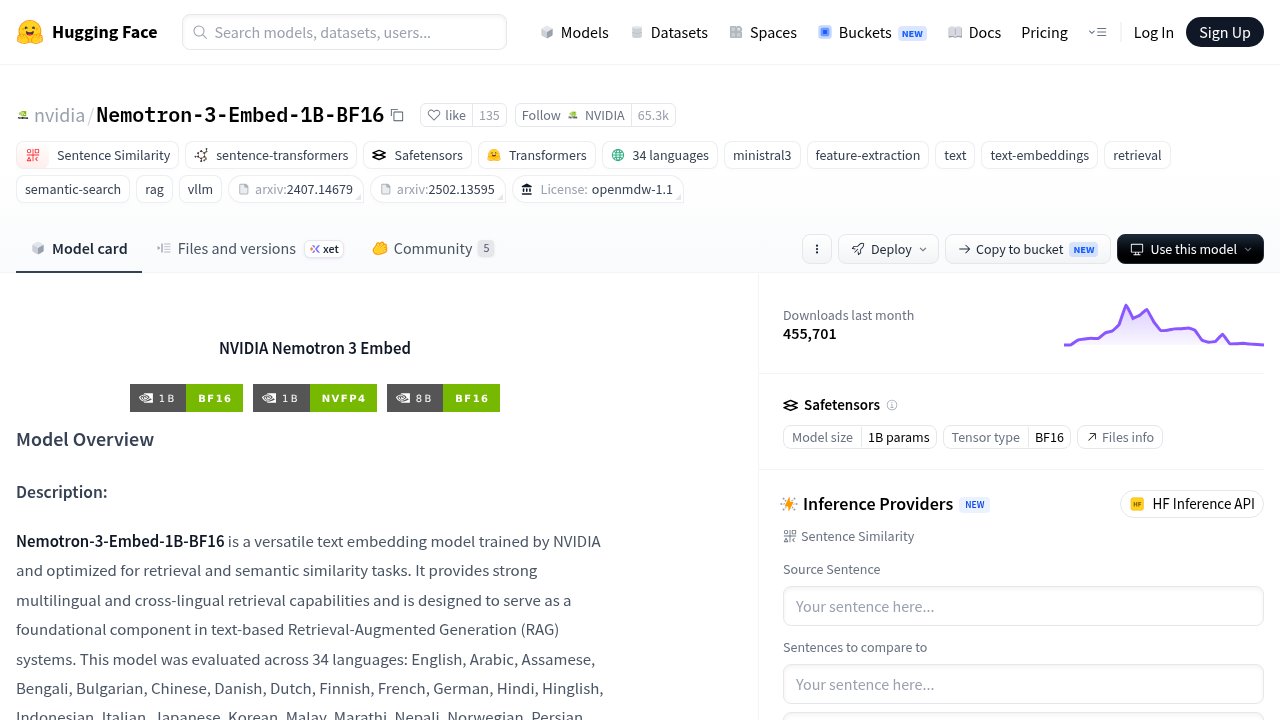
NVIDIA Nemotron-3-Embed-1B — le modèle d’embedding dont il est question ici, tel qu’affiché sur sa fiche officielle Hugging Face.
Pourquoi un meilleur embedding est un problème de coût, pas seulement de précision
Voici le mécanisme qui relie la précision de recherche à un montant en euros. Quand un agent IA (un système capable d’enchaîner plusieurs étapes automatiques vers un objectif, plutôt que de répondre une fois et s’arrêter) cherche dans une base documentaire et ne trouve pas un passage assez bon, il n’échoue pas discrètement. Il retente sa chance : il reformule la question, cherche sous un autre angle, ou découpe la question en sous-parties qu’il interroge une à une. Chacun de ces cycles de recherche supplémentaires renvoie du texte en plus dans la fenêtre de contexte du modèle de langage, et chaque mot de cette fenêtre compte dans la facture de tokens, puisque la plupart des fournisseurs d’IA facturent au token traité.
Un modèle d’embedding faible ne se contente donc pas de produire parfois une moins bonne réponse. Il produit un chemin plus lent et plus cher vers la même réponse, parce que l’agent compense une mauvaise recherche documentaire en cherchant davantage. C’est aussi pour cette raison que recherche documentaire et fine-tuning résolvent des problèmes différents : réentraîner le modèle de langage ne répare jamais une couche de recherche qui continue de lui remonter le mauvais passage. Le piège est facile à manquer, parce que personne ne met la précision d’un modèle d’embedding sur une facture mensuelle. Ce qui apparaît sur la facture, c’est le nombre de tokens, et ce nombre découle directement du nombre de recherches qu’il a fallu pour trouver le bon passage. Si une équipe voit le coût de fonctionnement de son agent IA grimper doucement et n’a pas encore regardé du côté de la recherche documentaire, bien choisir sa base de données vectorielle pour stocker ces embeddings, et le modèle d’embedding qui l’alimente, méritent tous les deux un audit avant de conclure que le modèle de langage est le vrai poste de dépense.
Le test : même corpus, même agent, seul l’embedding change
Les scores de benchmark comme le NDCG@10 sont utiles pour comparer des modèles d’embedding entre eux dans l’abstrait, mais ils ne disent pas à quelqu’un qui fait tourner un vrai agent IA combien ce classement se traduit en économies réelles. Un testeur indépendant, sans lien avec NVIDIA, a voulu mesurer cette traduction directement, et sa méthode mérite d’être détaillée parce que c’est le genre de test que n’importe qui, avec une collection de documents et une clé d’API, pourrait reproduire sur son propre matériel.
Le dispositif : un petit corpus de 25 extraits de texte, tirés de documents de politique publique sur la conservation des océans et des baleines, indexé deux fois avec deux modèles d’embedding différents. Une première fois avec un modèle d’embedding local pris comme référence, nomic-embed-text, exécuté via Ollama (un outil pour faire tourner des modèles d’IA sur sa propre machine plutôt que dans le cloud). Une seconde fois avec Nemotron 3 Embed 1B, récupéré sur Hugging Face. Tout le reste de la chaîne est resté fixe : le même modèle de langage, Qwen3 8B, jouait le rôle de l’agent de recherche dans les deux cas, et on lui a posé les trois mêmes questions multi-sauts (des questions qui exigent de rassembler des faits venant de plusieurs documents pour y répondre). Chaque appel de recherche fait par l’agent, et chaque token consommé au passage, a été enregistré.
Cette conception à une seule variable est ce qui rend le résultat lisible. Si le corpus, les questions ou le modèle d’agent avaient changé entre les deux passages, n’importe quel écart de nombre de tokens aurait pu s’expliquer par une bonne dizaine d’autres facteurs. Garder tout fixe sauf le modèle d’embedding, c’est ce qui permet d’attribuer une différence de résultat au modèle d’embedding et à lui seul.
nomic-embed-text — le modèle d’embedding de référence utilisé dans ce test, exécuté localement via Ollama.
Ce que les chiffres montrent, et ce qu’ils ne montrent pas
Sur les trois questions multi-sauts, le modèle d’embedding de référence (nomic-embed-text) a poussé l’agent à effectuer 15 recherches distinctes, consommant environ 12 688 tokens au passage. Avec Nemotron 3 Embed 1B à la place, et rien d’autre de changé, le même agent n’a eu besoin que de 11 recherches et d’environ 8 734 tokens, soit une baisse de 31 % des tokens et quatre appels de recherche en moins sur ce corpus précis, ces questions précises, et cet agent précis. Sur une question isolée, l’écart était encore plus net : 5 recherches, 3 échanges conversationnels et 4 231 tokens avec le modèle de référence, contre 3 recherches, 2 échanges et 2 110 tokens avec Nemotron, soit à peu près la moitié du coût, pour une réponse jugée équivalente ou mieux organisée par le testeur.
C’est un résultat réel et mécaniquement propre, sur ce test précis. Ce n’est pas une étude statistiquement solide, et traiter ce -31 % comme un chiffre transposable à un autre corpus, un autre agent ou un autre style de question serait une erreur. Trois questions et un corpus de 25 extraits, c’est un échantillon minuscule selon n’importe quel critère ; cela démontre que le mécanisme fonctionne (une meilleure recherche documentaire réduit bien le nombre d’itérations de recherche, ce qui réduit bien la consommation de tokens) sans prouver une ampleur précise que n’importe quel autre déploiement RAG devrait s’attendre à retrouver. Le chiffre de 72,38 % de NDCG@10 publié par NVIDIA et la baisse de 31 % de tokens mesurée par ce testeur sont deux types de preuves différents : l’un est une revendication de benchmark du fabricant sur la qualité de classement, l’autre est un protocole mesuré et reproductible, mené par une seule personne indépendante sur un seul petit jeu de données. Aucun des deux ne remplace l’autre, et aucun des deux ne devrait être cité comme s’il s’appliquait universellement.
Ce que cela change pour un système RAG déjà en production
L’idée qui reste utile dans six mois n’est pas le pourcentage. C’est la forme du test. Quiconque fait tourner un système RAG en production et soupçonne que sa facture de tokens grimpe doucement dispose d’une façon reproductible de vérifier si la couche d’embedding en est la cause : prendre un échantillon représentatif de son propre ensemble de documents, l’indexer avec son modèle d’embedding actuel puis avec un candidat de remplacement, faire tourner le même agent et les mêmes questions de test sur les deux, et consigner le nombre de recherches et le total de tokens. Cette comparaison, menée sur les documents réels d’une entreprise et ses schémas de requêtes réels, dit quelque chose qu’aucun classement public ne peut dire : si changer de modèle d’embedding ferait vraiment baisser sa facture à elle.
Cela recadre aussi où regarder en premier quand le choix d’un LLM open weight ou le coût de fonctionnement d’un agent semble anormal. Le réflexe est d’accuser le modèle de langage qui rédige, puisque c’est la partie visible et bavarde du système. Mais dans un pipeline RAG, le modèle de langage dépense des tokens en réaction à ce que l’embedding lui a transmis. Une couche de recherche documentaire qui renvoie le bon passage du premier coup donne au modèle de langage une raison de moins de reboucler et de chercher encore, et cette discipline se cumule à chaque exécution de l’agent.

Questions fréquentes
Qu’est-ce qu’un modèle d’embedding, en termes simples ?
Un modèle d’embedding convertit un morceau de texte en une liste de chiffres qui représente son sens, ce qui permet à un moteur de recherche de retrouver du contenu lié même quand la formulation ne correspond pas exactement. C’est le composant qui fait la recherche dans un système RAG (génération augmentée par récupération), avant que le modèle de langage ne rédige la réponse.
Nemotron 3 Embed, c’est la même chose que Nemotron 3 Nano ou Nemotron 2-Tower ?
Non. Nemotron 3 Embed 1B est un modèle dédié à la recherche documentaire, tandis que Nemotron 3 Nano est un autre socle NVIDIA utilisé dans d’autres produits, et Nemotron 2-Tower 30B est un modèle de génération de texte sans rapport, à l’architecture hybride différente. Ils partagent un préfixe de marque, pas une fonction.
Une baisse de 31 % des tokens veut-elle dire que tout système RAG économisera 31 % en changeant de modèle ?
Non, cette baisse de 31 % mesurée sur ce test précis ne doit pas être lue comme une promesse universelle. Elle vient du test d’un seul testeur : un corpus unique de 25 extraits, trois questions multi-sauts, un seul modèle d’agent, avec seulement le modèle d’embedding qui change. C’est une démonstration propre qu’une meilleure recherche documentaire fait baisser la consommation de tokens, pas un pourcentage universel que tout autre déploiement devrait attendre.
Quelle licence utilise Nemotron 3 Embed ?
Nemotron-3-Embed-1B est publié sous OpenMDW-1.1, une licence open weight signée NVIDIA, et non sous Apache ou MIT. Le modèle de base dont il a été distillé, Ministral-3-3B, reste sous Apache 2.0. L’usage commercial est autorisé dans les deux cas.
Comment tester cela sur mes propres documents ?
Indexez un échantillon représentatif de votre ensemble de documents deux fois, une fois avec votre modèle d’embedding actuel, une fois avec un candidat de remplacement, puis faites tourner le même agent IA sur les deux avec des questions de test identiques, en consignant chaque appel de recherche et chaque token consommé. Ce sont les totaux de tokens mis côte à côte, pas un score de benchmark publié, qui vous diront si le changement ferait vraiment baisser votre facture.
À retenir
Un score de benchmark de recherche documentaire est un signal de départ, pas une décision d’achat. Ce qui apparaît réellement sur la facture d’un agent IA, c’est le nombre de fois qu’il a dû chercher avant de trouver le bon passage, et ce nombre est fixé par le modèle d’embedding, pas par le modèle de langage qui en récolte le mérite ou le blâme. La façon de savoir si un meilleur modèle d’embedding vaut la peine d’être adopté n’est pas de faire confiance au pourcentage affiché par le test de quelqu’un d’autre, y compris celui-ci. C’est de faire tourner le même protocole comparatif, un corpus, un agent, seul l’embedding qui change, sur les documents et les questions qui composent réellement la charge de travail en question.