Nemotron Embed: Wie ein besseres Embedding-Modell die RAG-Kosten senkt
NVIDIAs Nemotron 3 Embed schneidet bei Retrieval-Benchmarks gut ab – und bedeutet weniger Suchanfragen sowie eine kleinere Token-Rechnung.
Nemotron Embed: Wie ein besseres Embedding-Modell die RAG-Kosten senkt
Wenn ein Unternehmen klagt, sein KI-Assistent sei im Betrieb teuer geworden, fällt der Verdacht meist auf das große Sprachmodell, das die Antworten schreibt. Ein weniger offensichtlicher Kostentreiber sitzt weiter vorn in der Kette: das kleine Modell, das entscheidet, welchen Dokumentenausschnitt der Assistent überhaupt zu lesen bekommt. Trifft dieses Modell die falsche Wahl, sucht der Assistent erneut, und noch einmal, und jeder Versuch schlägt sich in Token nieder, der Abrechnungseinheit, nach der KI-Anbieter ihre Preise berechnen. NVIDIA hat vor Kurzem eine neue Version dieser stillen Komponente veröffentlicht, Nemotron 3 Embed. Ein unabhängiger Tester hat einen kleinen, transparenten Versuch durchgeführt, um herauszufinden, ob eine bessere Version davon in der Praxis wirklich Geld spart, nicht nur Punkte auf einer Bestenliste.
Was Nemotron 3 Embed wirklich ist (und was nicht)
Wer schon mal von einem KI-Modell gehört hat, denkt meist an etwas wie ChatGPT: Man tippt eine Frage, es schreibt eine Antwort. Ein Embedding-Modell arbeitet stiller und mechanischer. Es liest einen Textabschnitt, sei es ein Absatz, ein Richtliniendokument oder ein Support-Ticket, und wandelt ihn in eine lange Liste von Zahlen um, die erfasst, wovon der Text handelt. Zwei Abschnitte mit ähnlicher Bedeutung landen bei ähnlichen Zahlenlisten, selbst wenn sie kein einziges Wort gemeinsam haben. Genau das erlaubt einem Suchsystem, die Passage über Förderobergrenzen für erneuerbare Energien zu finden, obwohl die Nutzerin nach Steuergrenzen für saubere Energie gefragt hat.
Das zählt vor allem bei Retrieval-Augmented Generation, meist RAG abgekürzt: Statt rein aus dem zu antworten, was ein Sprachmodell beim Training auswendig gelernt hat, durchsucht das System zuerst die eigenen Dokumente eines Unternehmens nach relevanten Passagen und schreibt die Antwort dann auf dieser Grundlage. Das Embedding-Modell übernimmt dabei das Finden, meist in Zusammenspiel mit einer Vektordatenbank, die diese Zahlenlisten speichert und durchsuchbar macht. Liefert das Embedding-Modell die falsche Passage, gibt das Sprachmodell darüber entweder eine schlechte Antwort, oder es sucht, in einem autonomen Agenten-Setup, einfach noch einmal.
Nemotron 3 Embed ist NVIDIAs neuester Beitrag in diesem Bereich, und die Variante, die gerade Aufmerksamkeit bekommt, ist die kleinste: ein Modell mit 1 Milliarde Parametern namens Nemotron-3-Embed-1B. Laut NVIDIAs eigener Modellkarte auf Hugging Face entsteht es, indem man von Mistrals Ministral-3-3B-Modell ausgeht und es durch zwei Runden Pruning schickt (das Wegschneiden der Netzwerkteile, die am wenigsten beitragen) sowie durch Distillation aus NVIDIAs eigenem, größeren Nemotron-3-Embed-8B-Modell (ein kleineres Modell wird trainiert, das Verhalten eines größeren nachzuahmen). NVIDIA hat hier nicht bei null angefangen, sondern einen kleineren, spezialisierten Ableger eines bestehenden offenen Modells gebaut.
Eine kurze Klarstellung lohnt sich, weil NVIDIA den Namen Nemotron für ganz unterschiedliche Produkte verwendet: Das hier ist nicht Nemotron 3 Nano, ein separates Basismodell, das NVIDIA anderswo für Aufgaben direkt auf dem Gerät einsetzt, und auch nicht Nemotron 2-Tower 30B, ein vollwertiges generatives Modell mit hybrider Architektur, das mit Suche nichts zu tun hat. Gleiches Familien-Branding, komplett andere Aufgaben. Wer eines davon bewertet, sollte sich vergewissern, dass es wirklich das Embedding-Modell ist und nicht ein Namensvetter.
Zur Lizenz, weil sich hier leicht ein Fehler einschleicht: Nemotron-3-Embed-1B erscheint unter OpenMDW-1.1, einer von NVIDIA selbst verfassten Open-Weight-Lizenz, nicht unter Apache oder MIT, wie andernorts kolportiert wurde. Das zugrunde liegende Ministral-Basismodell bleibt bei Apache 2.0. Kommerzielle Nutzung ist in beiden Fällen ausdrücklich erlaubt, der praktische Unterschied für die meisten Teams ist also gering, aber die Bezeichnung selbst ist nicht austauschbar.
Nach NVIDIAs eigenen Angaben erreicht das Modell 72,38 % NDCG@10 (eine gängige Kennzahl für Retrieval-Genauigkeit, grob gesagt: wie weit oben die richtige Antwort landet) im RTEB-Benchmark. NVIDIA beschreibt es als Bestwert unter vergleichbar großen Modellen auf RTEB (den absoluten Spitzenplatz der gesamten Bestenliste hält die größere 8-Milliarden-Parameter-Variante Nemotron 3 Embed, nicht diese hier). Es beherrscht 34 Sprachen und verarbeitet in einem Durchgang Textabschnitte von bis zu 32.768 Token (Wörter und Wortfragmente) Länge. Das sind NVIDIAs eigene Angaben, von der eigenen Modellkarte, und sie verdienen genau diese Einordnung: ein Benchmarkergebnis des Herstellers, brauchbar als erstes Signal, keine Garantie für einen bestimmten Anwendungsfall.
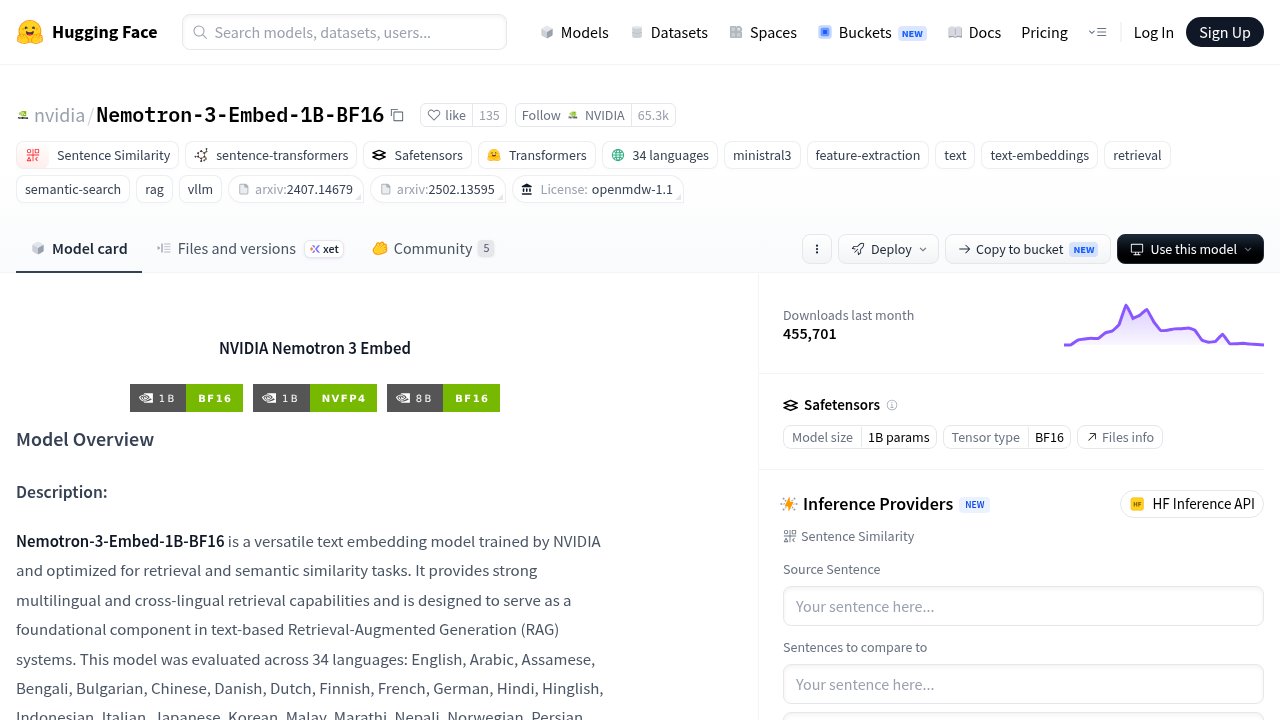
NVIDIA Nemotron-3-Embed-1B — das Embedding-Modell, um das es in diesem Artikel geht, auf seiner offiziellen Hugging-Face-Modellkarte.
Warum ein besseres Embedding-Modell ein Kostenproblem ist, nicht nur ein Genauigkeitsproblem
Der Mechanismus, der Suchgenauigkeit mit einer Rechnung in Euro verbindet, lässt sich einfach nachzeichnen. Wenn ein KI-Agent (ein System, das mehrere automatisierte Schritte auf ein Ziel hin unternimmt, statt nur einmal zu antworten und aufzuhören) einen Dokumentenspeicher durchsucht und keine ausreichend passende Stelle findet, scheitert er nicht einfach still. Meist versucht er es erneut: formuliert die Anfrage um, sucht aus einem anderen Blickwinkel oder zerlegt die Frage in Teilfragen und durchsucht jede einzeln. Jeder dieser zusätzlichen Suchdurchgänge speist mehr Text zurück in das Kontextfenster des Sprachmodells, und jedes Wort in diesem Kontextfenster zählt zur Token-Rechnung, weil die meisten KI-Anbieter pro verarbeitetem Token abrechnen.
Ein schwaches Embedding-Modell liefert also nicht nur gelegentlich eine schlechtere Antwort. Es erzeugt einen langsameren, teureren Weg zur selben Antwort, weil der Agent die schlechte Trefferquote durch mehr Suchen ausgleicht. Das ist auch der Grund, warum Retrieval und Fine-Tuning unterschiedliche Probleme lösen: Kein noch so intensives Nachtrainieren des Sprachmodells behebt eine Retrieval-Schicht, die ihm ständig die falsche Passage liefert. Das übersieht man leicht, weil niemand die Trefferquote des Embedding-Modells auf eine Monatsrechnung schreibt. Was auf der Rechnung auftaucht, ist die Token-Zahl, und die Token-Zahl hängt davon ab, wie viele Suchdurchgänge nötig waren, um die richtige Passage zu finden. Wer beobachtet, dass die laufenden Kosten des eigenen KI-Agenten stetig steigen, und noch nicht auf die Retrieval-Schicht geschaut hat, sollte vor der Annahme, das Sprachmodell selbst sei der Kostentreiber, sowohl die Wahl der passenden Vektordatenbank für die Embeddings als auch das Embedding-Modell dahinter prüfen.
Der Test: gleicher Korpus, gleicher Agent, nur das Embedding-Modell ändert sich
Benchmark-Werte wie NDCG@10 sind praktisch, um Embedding-Modelle abstrakt miteinander zu vergleichen, sagen aber niemandem, der einen echten KI-Agenten betreibt, wie viel diese Rangfolge in reale Ersparnis übersetzt. Ein unabhängiger Tester, nicht NVIDIA selbst, wollte genau diese Übersetzung direkt messen. Die Methode lohnt eine genauere Betrachtung, weil sie sich leicht nachstellen lässt, mit einer eigenen Dokumentensammlung und einem API-Schlüssel.
Der Aufbau: ein kleiner Korpus aus 25 Textabschnitten, entnommen aus Dokumenten zur Meeres- und Walschutzpolitik, zweimal indiziert. Einmal mit einem lokalen Basismodell, nomic-embed-text, ausgeführt über Ollama (ein Werkzeug, um KI-Modelle auf dem eigenen Rechner statt in der Cloud laufen zu lassen). Und einmal mit Nemotron 3 Embed 1B, geladen von Hugging Face. Alles andere in der Kette blieb konstant: Dasselbe Sprachmodell, Qwen3 8B, fungierte beide Male als Such-Agent und bekam dieselben drei Multi-Hop-Fragen gestellt (Fragen, die Fakten aus mehr als einem Dokument zusammenführen müssen, um beantwortet zu werden). Jeder Suchaufruf des Agenten und jedes dabei verbrauchte Token wurden protokolliert.
Genau dieses Design mit nur einer veränderten Variablen macht das Ergebnis überhaupt aussagekräftig. Hätten sich Korpus, Fragen oder das Agentenmodell zwischen den Durchläufen geändert, ließe sich jeder Unterschied in der Token-Zahl mit einem Dutzend anderer Faktoren erklären. Nur weil alles außer dem Embedding-Modell konstant blieb, lässt sich ein Unterschied im Ergebnis eindeutig darauf zurückführen.
nomic-embed-text — das Basis-Embedding-Modell in diesem Test, lokal über Ollama betrieben.
Was die Zahlen zeigten, und was nicht
Über die drei Multi-Hop-Fragen hinweg brachte das Basismodell (nomic-embed-text) den Agenten dazu, 15 einzelne Suchanfragen zu stellen und dabei rund 12.688 Token zu verbrauchen. Mit Nemotron 3 Embed 1B anstelle des Basismodells, sonst unverändert, brauchte derselbe Agent nur noch 11 Suchanfragen und etwa 8.734 Token: ein Rückgang von 31 % bei den Token und vier Suchanfragen weniger, auf diesem konkreten Korpus, mit diesen konkreten Fragen und diesem konkreten Agenten. Bei einer einzelnen Frage fiel der Unterschied noch deutlicher aus: 5 Suchanfragen, 3 Gesprächsrunden und 4.231 Token mit dem Basismodell, gegenüber 3 Suchanfragen, 2 Runden und 2.110 Token mit Nemotron, ungefähr die Hälfte der Kosten, für eine Antwort, die der Tester als gleichwertig oder besser strukturiert einstufte.
Das ist ein echtes, mechanisch sauberes Ergebnis für diesen einen Testlauf. Es ist keine statistisch belastbare Studie, und die minus 31 % einfach auf einen anderen Korpus, einen anderen Agenten oder einen anderen Fragentyp zu übertragen, wäre ein Fehler. Drei Fragen und ein Korpus mit 25 Abschnitten sind nach jedem Maßstab eine kleine Stichprobe. Sie zeigen, dass der Mechanismus funktioniert (bessere Trefferquote senkt die Zahl der Suchdurchgänge, was wiederum die Token-Zahl senkt), ohne eine bestimmte Größenordnung zu belegen, die man bei jedem anderen RAG-Einsatz erwarten dürfte. NVIDIAs Wert von 72,38 % NDCG@10 und die 31 % Token-Ersparnis des Testers sind zwei verschiedene Arten von Beleg: Der eine ist die Benchmark-Aussage eines Herstellers über die Rangqualität, der andere das gemessene, nachvollziehbare Protokoll einer unabhängigen Person auf einem kleinen Datensatz. Keiner ersetzt den anderen, und keiner sollte so zitiert werden, als gelte er allgemein.
Was das für ein RAG-System in Produktion bedeutet
Der bleibende Punkt ist nicht die Prozentzahl. Es ist die Form des Tests. Wer ein produktives RAG-System betreibt und den Verdacht hat, die Token-Rechnung kriecht nach oben, hat damit einen nachvollziehbaren Weg, zu prüfen, ob die Embedding-Schicht die Ursache ist: einen repräsentativen Ausschnitt der eigenen Dokumente nehmen, ihn mit dem aktuellen Embedding-Modell und mit einem Kandidaten für den Ersatz indizieren, denselben Agenten und dieselben Testfragen auf beide loslassen und Suchanzahl sowie Token-Summen protokollieren. Dieser Vergleich, auf den eigenen Dokumenten und tatsächlichen Anfragemustern eines Unternehmens durchgeführt, sagt etwas aus, das kein öffentliches Ranking leisten kann: ob ein Wechsel des Embedding-Modells die eigene Rechnung spürbar senken würde.
Das lenkt auch den Blick neu, wenn die Wahl eines Open-Weight-LLM oder die laufenden Kosten eines Agenten sich falsch anfühlen. Der Reflex ist, das Sprachmodell zu verdächtigen, das die Antworten schreibt, weil es der sichtbare, gesprächige Teil des Systems ist. In einer RAG-Kette verbraucht das Sprachmodell aber Token, während es auf das reagiert, was das Embedding-Modell ihm liefert. Eine Retrieval-Schicht, die die richtige Passage schon beim ersten Versuch zurückgibt, gibt dem Sprachmodell weniger Grund, noch einmal zu suchen, und diese Disziplin summiert sich mit jedem Lauf des Agenten.

Häufig gestellte Fragen
Was ist ein Embedding-Modell, einfach erklärt?
Ein Embedding-Modell wandelt ein Stück Text in eine Zahlenliste um, die dessen Bedeutung darstellt, sodass ein Suchsystem verwandte Inhalte findet, selbst wenn der Wortlaut nicht genau übereinstimmt. Es ist die Komponente, die in einem Retrieval-Augmented-Generation- oder RAG-System die Suche übernimmt, bevor ein Sprachmodell die eigentliche Antwort schreibt.
Ist Nemotron 3 Embed dasselbe wie Nemotron 3 Nano oder Nemotron 2-Tower?
Nein. Nemotron 3 Embed 1B ist ein eigenständiges Modell für Retrieval und Suche, während Nemotron 3 Nano ein separates NVIDIA-Basismodell für andere Produkte ist und Nemotron 2-Tower 30B ein unabhängiges Textgenerierungsmodell mit anderer, hybrider Architektur. Sie teilen sich einen Markennamen, keinen Zweck.
Bedeutet eine Token-Ersparnis von 31 %, dass jedes RAG-System beim Wechsel 31 % spart?
Nein, und die Zahl sollte nicht so gelesen werden. Sie stammt aus dem Test einer einzelnen Person: ein Korpus mit 25 Abschnitten, drei Multi-Hop-Fragen und ein Agentenmodell, wobei nur das Embedding-Modell verändert wurde. Es ist ein sauberer Beleg dafür, dass bessere Trefferquote die Token-Kosten senkt, keine allgemeingültige Prozentzahl, die jeder andere Einsatz erwarten sollte.
Unter welcher Lizenz steht Nemotron 3 Embed?
Nemotron-3-Embed-1B erscheint unter OpenMDW-1.1, einer offenen NVIDIA-Lizenz, nicht unter Apache oder MIT. Das Basismodell, aus dem es destilliert wurde, Ministral-3-3B, bleibt unter Apache 2.0. Kommerzielle Nutzung ist in beiden Fällen erlaubt.
Wie testet man das mit den eigenen Dokumenten?
Einen repräsentativen Ausschnitt der eigenen Dokumente zweimal indizieren, einmal mit dem aktuellen Embedding-Modell und einmal mit einem Kandidaten für den Ersatz, dann denselben KI-Agenten mit identischen Testfragen gegen beide laufen lassen und jeden Suchaufruf sowie jedes verbrauchte Token protokollieren. Der direkte Vergleich der Token-Summen, nicht ein veröffentlichter Benchmark-Wert, zeigt, ob ein Wechsel die eigene Rechnung tatsächlich senkt.
Fazit
Ein Retrieval-Benchmark-Wert ist ein erstes Signal, keine Kaufentscheidung. Was tatsächlich auf der Rechnung eines KI-Agenten landet, ist, wie oft er suchen musste, bevor er die richtige Passage fand, und diese Zahl bestimmt das Embedding-Modell, nicht das Sprachmodell, das dafür gelobt oder verantwortlich gemacht wird. Ob sich ein besseres Embedding-Modell lohnt, lässt sich nicht an einer Schlagzeilen-Prozentzahl ablesen, auch nicht an dieser hier. Der Weg führt über denselben Vergleichstest, ein Korpus, ein Agent, nur das Embedding-Modell verändert, auf den Dokumenten und Fragen, aus denen die eigene Arbeitslast tatsächlich besteht.